English
 Deutsch
 Polski
Ollama, LM Studio, llama.cpp czy vLLM: które oprogramowanie pasuje do lokalnych modeli LLM?

Spis treści
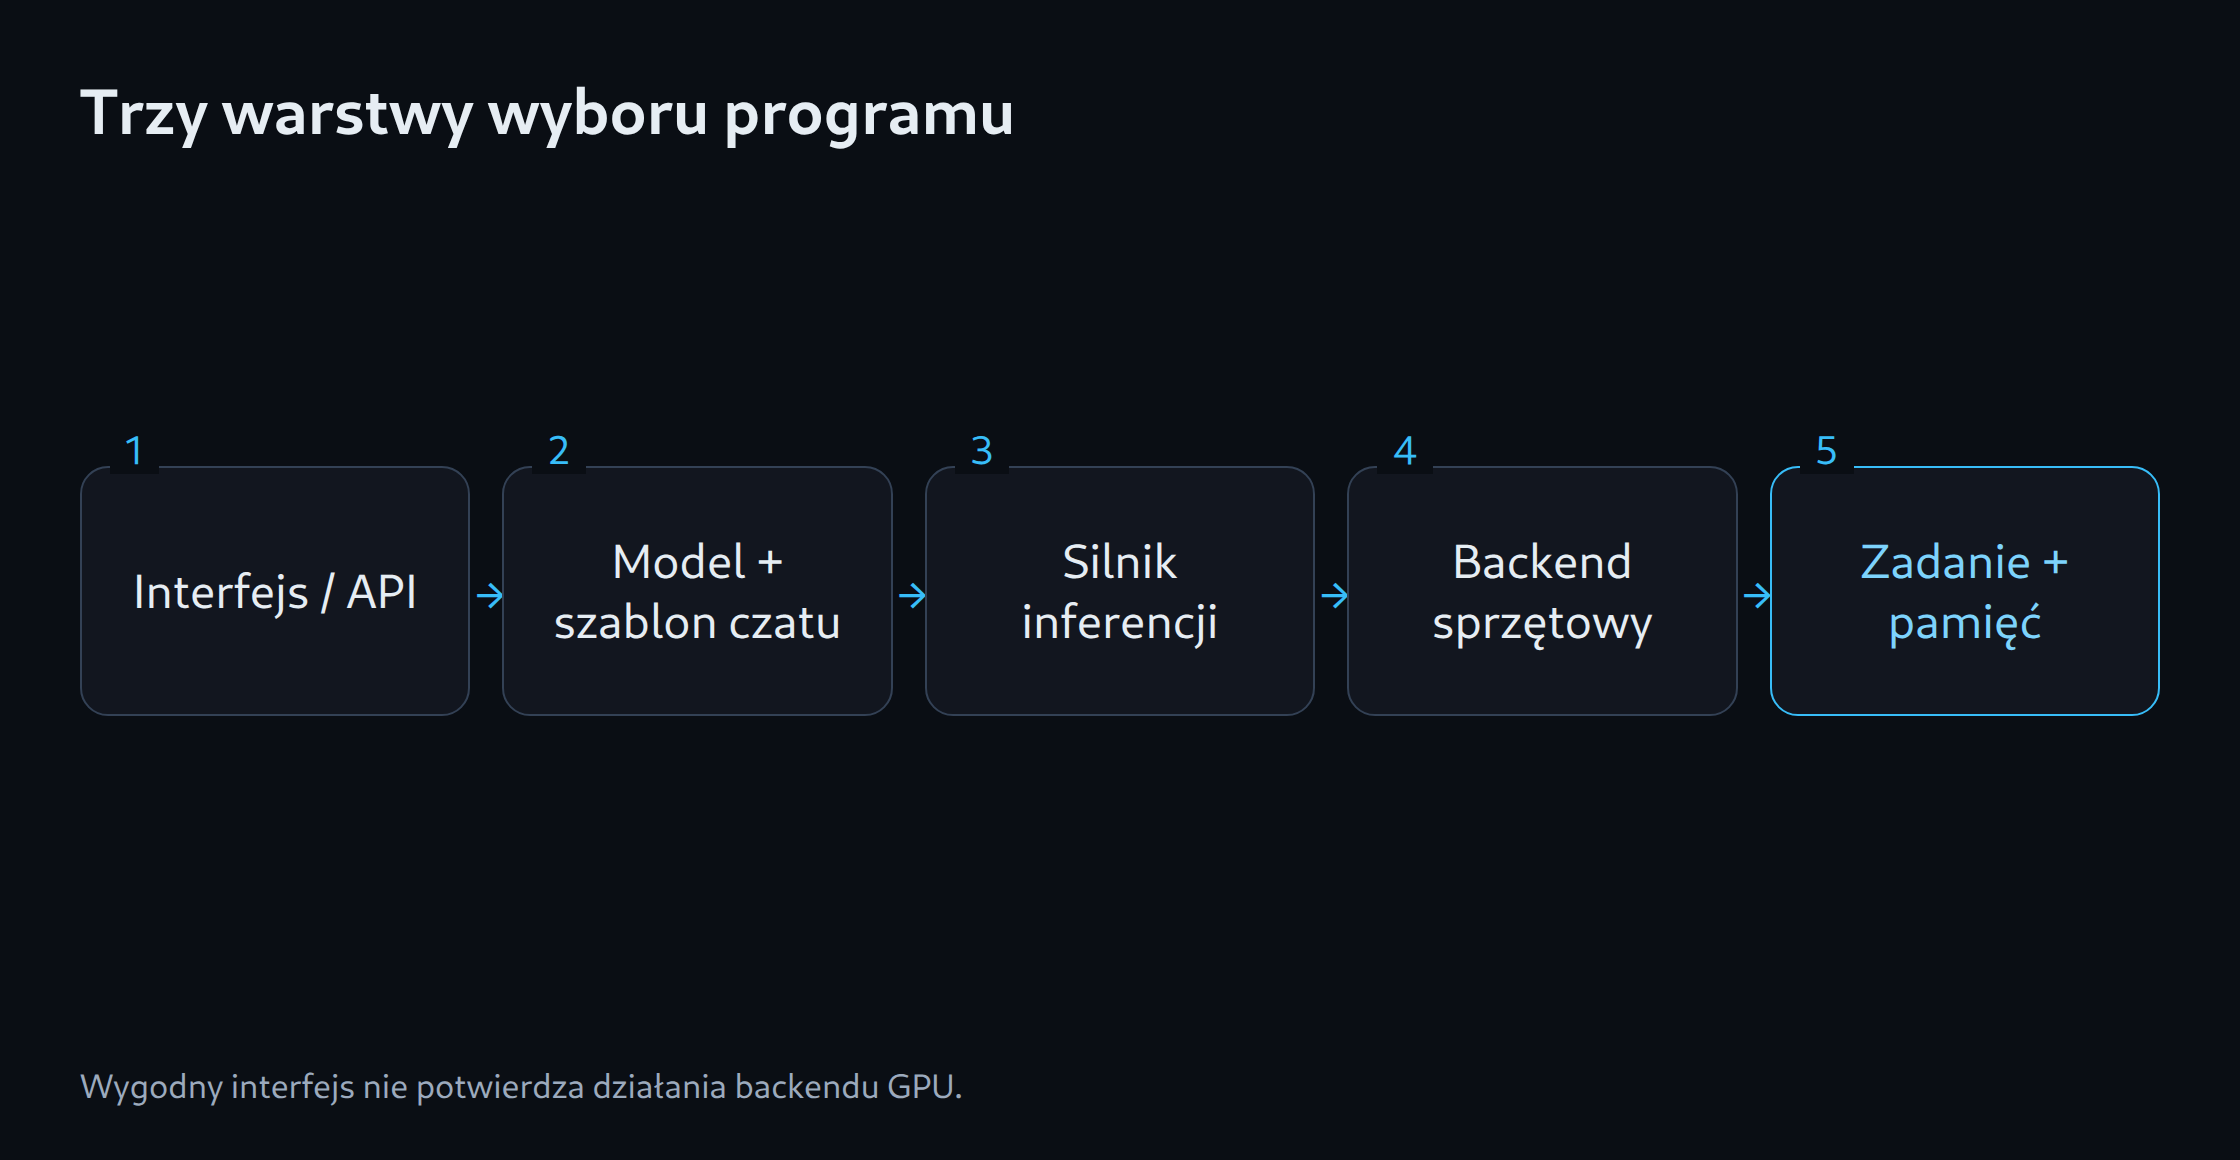
Wybór oprogramowania dla lokalnego modelu LLM zaczyna się od zadania. Czat na komputerze, API dla skryptu i usługa obsługująca równoległe żądania wymagają innych właściwości. Popularne produkty zajmują także różne warstwy: interfejs, zarządzanie modelami i silnik inferencji to odrębne pojęcia.
Porównanie dotyczy udokumentowanych funkcji, bez własnych pomiarów szybkości. Wersja środowiska, architektura modelu i sprzęt pozostają częścią każdej konkretnej decyzji.
Sześć ścieżek z różnymi priorytetami
| Oprogramowanie | Przydatna cecha | Kontrola przed startem |
|---|---|---|
| Ollama | Zarządzanie modelami i lokalne API | Backend, tag modelu i kontekst |
| LM Studio | Interfejs komputerowy i wybór modelu | Środowisko, format i przeniesienie na GPU |
| llama.cpp | Bezpośrednia kontrola, GGUF, wiele backendów | Kompilacja i obsługa architektury |
| MLX LM | Wykonanie na Apple Silicon | Artefakt MLX i zapas pamięci |
| vLLM | Serwer API i równoległość | System, GPU i kernel kwantyzacji |
| OpenVINO GenAI | Osobna zoptymalizowana ścieżka inferencji | Konwersja modelu i urządzenie docelowe |
Osobny wybór dla komputera i API
LM Studio pasuje do graficznego początku. Ollama zapewnia stosunkowo prostą usługę łączącą zarządzanie modelami z API. Dodanie interfejsu czatu nie zmienia automatycznie silnika pod spodem. Wygodna rozmowa nie potwierdza więc przepustowości serwera.
llama.cpp udostępnia bardziej bezpośrednią kontrolę parametrów i backendów sprzętowych. Dodatkowa kontrola przydaje się przy powtarzalnych konfiguracjach lub nietypowym sprzęcie. Nazwa projektu oznacza środowisko wykonawcze, a nie ograniczenie do rodziny Llama.
Backend określa zgodność sprzętu
CUDA, Metal, Vulkan, SYCL i XPU to różne ścieżki wykonania. Instrukcja dla NVIDIA nie przenosi się bez zmian na Intel Arc. Ollama dokumentuje dodatkową obsługę Vulkan w Windows i Linux; sterownik, zainstalowany backend i rzeczywiste wykrycie urządzenia muszą być zgodne.
Na Apple Silicon naturalnymi kandydatami są MLX LM i odpowiednie ścieżki Metal. Kwantyzacja MLX i plik GGUF pozostają różnymi artefaktami. Zmiana backendu wymaga kontroli rewizji modelu, tokenizera i szablonu czatu. Inna odpowiedź może wynikać z konfiguracji zamiast z lepszego silnika.
vLLM dla właściwego zadania serwerowego
vLLM skupia się na obsłudze modeli. Dokumentacja instalacji GPU wskazuje Linux; jedną ze ścieżek dla Windows jest WSL. To inny przebieg niż natywna instalacja aplikacji komputerowej. Obsługiwany GPU nie gwarantuje także każdego kernela kwantyzacji.
Pojedyncza sesja wymaga krótkiego czasu do pierwszego tokenu i płynnego generowania. Wiele sesji dodaje łączną przepustowość, kolejki i opóźnienia pod obciążeniem. Szybka pojedyncza odpowiedź nie rozstrzyga porównania wieloużytkownikowego. SGLang jest dodatkowym kandydatem wymagającym osobnej kontroli bieżącej obsługi modeli.
Wiarygodna ścieżka wyboru
Pierwsze kryteria to system, dostępny sprzęt i zamierzony model. Następne obejmują wynik strukturalny, wywołania narzędzi, obrazy lub pracę offline. Wspólny zestaw zadań powinien działać z zapisaną rewizją, kontekstem i ustawieniami próbkowania.
Mały asystent komputerowy nie wymaga złożonego serwera wyłącznie na zapas. Usługa API potrzebuje powtarzalnych ustawień startu, czytelnych logów i granic obciążenia. Istniejący kalkulator pamięci pomaga ocenić dopasowanie modelu; wybór programu wynika z potwierdzonego backendu i rzeczywistego zadania.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy Ollama i llama.cpp są zamienne?
Ollama dodaje zarządzanie modelami i własne API. llama.cpp zapewnia bardziej bezpośredni dostęp do środowiska wykonawczego i backendów. O możliwości zmiany decydują format modelu, szablon czatu i obsługiwane funkcje.
Czy vLLM jest potrzebny do pojedynczej sesji czatu na komputerze?
Pojedyncza sesja nie uzasadnia automatycznie dodatkowej złożoności serwera. Wybór zależy od systemu, sprzętu, modelu i wymaganych funkcji API. Wyższa przepustowość przy wielu żądaniach nie zastępuje oceny wygody obsługi.
Źródła
- Ollama: Hardware support
- LM Studio: Dokumentation
- llama.cpp: Projekt und Backends
- vLLM: GPU installation
- MLX LM: Projekt
- OpenVINO: Generative AI workflow
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły