English
 Deutsch
 Polski
KI-Agenten in der Webanalyse: Wie agentischer Traffic GA4 verzerrt und sich serverseitig trennen lässt

Management Summary
KI-Agenten sind Programme, die Websites anstelle eines Menschen besuchen und bedienen können. Solche Besuche können in der Webanalyse auftauchen und die Besuchszahl ohne zusätzliche Käufe erhöhen. Der Artikel erklärt die Bedeutung fürs Marketing: Eine sinkende Kaufquote kann teilweise an einer veränderten Besucherzusammensetzung liegen. Die Trennung bestätigter automatischer Besuche hilft bei der Einordnung. Ein KI-Verweis allein beweist noch keine automatische Bedienung; manche Zugriffe bleiben unbekannt.
Inhalt
- Vier Arten von Zugriffen
- Der Kanal AI Assistant ist kein Menschennachweis
- Identität und Sicherheit der Aussage
- Eine kleine Klassifikation mit ehrlichem Rest
- Logs und GA4 gemeinsam, aber getrennt auswerten
- Sitzungen ohne falsche Zusammenfassung zählen
- WebMCP misst einen Werkzeugaufruf
- Filter und maschinelle Abrufe
- Fragen und Antworten
- Quellen
Ein Browser-Agent kann Seiten öffnen und dieselben Analyseereignisse wie ein menschlicher Besuch auslösen. Dadurch kann beispielsweise die Zahl der Sitzungen steigen, obwohl keine zusätzlichen Käufe entstehen. Das Ausmaß hängt von der Website, dem Agenten und der Messkonfiguration ab. Eine pauschale Aussage über „die meisten Websites“ lässt sich daraus nicht ableiten.
Für eine brauchbare Auswertung sind zwei Fragen getrennt zu behandeln: Woher kam der Besuch, und welche Hinweise gibt es auf Automatisierung? Ein KI-Verweis beantwortet die erste Frage. Ein geprüfter Agentennachweis betrifft die zweite. Unbekannter Traffic bleibt unbekannt.
Vier Arten von Zugriffen
- Ein Mensch klickt auf einen Link in einer KI-Antwort. Der Browser kann GA4 ausführen, sofern die Messung geladen und zulässig ist.
- Ein Dienst ruft im Nutzerauftrag eine Seite ab, beispielsweise ChatGPT-User. Ohne Ausführung des Tags entsteht dadurch allein kein GA4-Ereignis.
- Ein Browser-Agent bedient die Website. JavaScript und Analyseereignisse sind möglich, aber nicht für jeden Agenten und jede Konfiguration garantiert.
- Ein Such- oder Trainingscrawler lädt Inhalte. Solche Abrufe gehören zunächst in eine eigene technische Auswertung.
Der Kanal AI Assistant ist kein Menschennachweis
Google dokumentiert seit Mai 2026 den Kanal „AI Assistant“. Bei einem erkannten KI-Referrer wird das Medium „ai-assistant“ und die Kampagne „(ai-assistant)“ verwendet. Ein Referrer ist die mitgelieferte Herkunftsadresse. Diese Herkunft beweist weder menschliche Bedienung noch die Identität eines Agenten. Auch ein automatisierter Browser kann eine passende Herkunft mitsenden. Die Dimension Source Group fasst seit Juni unterschiedliche Quellnamen zusammen und wird laut Google rückwirkend befüllt. [1]
Ohne Herkunftsangabe oder passende Kampagnenparameter kann Traffic als „Direct“ erscheinen; vorhandene andere Zuordnungssignale können das Ergebnis beeinflussen. Der Bericht zählt erfasste Besuche, nicht sämtliche Erwähnungen oder Links in KI-Antworten. Mehr Direktzugriffe, Warenkorbaktionen ohne Kauf oder gleichmäßige Zeitabstände sind Prüfhinweise, aber kein Beweis für Agenten.
Identität und Sicherheit der Aussage
Der User-Agent ist eine vom Client gesendete Selbstbeschreibung. Ein Text wie „Google-Agent“ ist leicht nachzuahmen. Google veröffentlicht passende IP-Bereiche für diesen Agenten; eine Herkunftsprüfung muss genau diese Bereiche oder das dokumentierte DNS-Verfahren verwenden. Bei DNS gehören Rückwärtsauflösung, Prüfung der erlaubten Domain und anschließende Vorwärtsauflösung auf dieselbe IP zusammen. Eine beliebige Adresse aus Google Cloud beweist keinen Google-Agent. [2]
Web Bot Auth kann einen signierenden Betreiber nachweisen. Cloudflare dokumentiert dafür HTTP-Signaturen und einen öffentlichen Schlüsselverzeichnisdienst auf Basis noch veränderlicher IETF-Entwürfe. Eine gültige Signatur beweist nicht automatisch einen bestimmten menschlichen Auftrag, Harmlosigkeit oder Kaufabsicht. Das bloße Vorhandensein von Signature-Headern reicht ebenfalls nicht. Eine eigene Prüfung benötigt zusätzlich eine Vertrauensentscheidung zum Betreiber, korrekte signierte Bestandteile, Zeitfenster und Schutz vor Wiederholung. [3]
Ein CDN ist ein vorgeschalteter Auslieferungsdienst; eine WAF prüft Webanfragen auf Sicherheitsregeln. Deren Ergebnis kann die Anwendung übernehmen, wenn der Übertragungsweg abgesichert ist. Der Ursprung muss direkte Umgehungen verhindern, und der vorgeschaltete Dienst muss eingehende Klassifikationsheader entfernen und selbst neu setzen. Eine gewöhnliche IP-Weiterleitungsangabe oder ein vom Browser gesetzter Header ist kein vertrauenswürdiges Prüfergebnis.
Eine kleine Klassifikation mit ehrlichem Rest
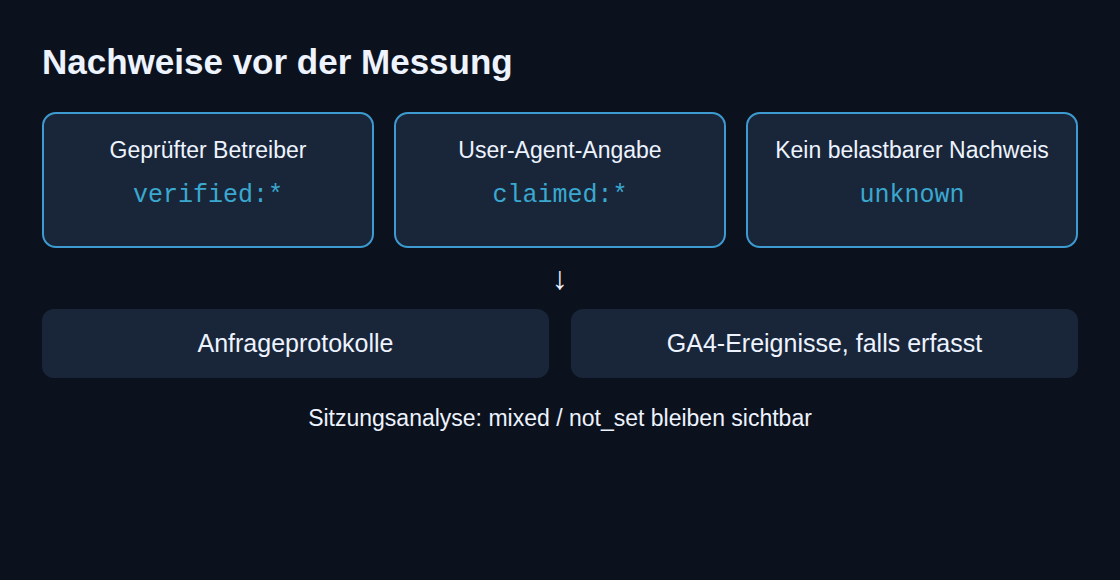
Das PHP-Beispiel trennt drei Fälle: bestätigter Betreiber, bloße User-Agent-Angabe und unbekannter Zugriff. Die zweite Eingabe darf ausschließlich aus einer bereits vertrauenswürdig geprüften Serverintegration stammen. Ohne eine solche Integration bleibt der Wert null. Die Funktion führt selbst keine Signatur- oder IP-Prüfung durch. Ein beliebiger HTTP-Header darf nicht direkt als zweites Argument dienen.
declare(strict_types=1);
function classifyTraffic(string $userAgent, ?string $verifiedClass = null): string
{
$verified = ['agent:google', 'fetcher:openai', 'fetcher:anthropic',
'fetcher:perplexity', 'crawler'];
if ($verifiedClass !== null && in_array($verifiedClass, $verified, true)) {
return 'verified:' . $verifiedClass;
}
$tokens = [
'Google-Agent' => 'agent:google',
'ChatGPT-User' => 'fetcher:openai',
'Claude-User' => 'fetcher:anthropic',
'Perplexity-User' => 'fetcher:perplexity',
'GPTBot' => 'crawler', 'OAI-SearchBot' => 'crawler',
'ClaudeBot' => 'crawler', 'PerplexityBot' => 'crawler',
];
foreach ($tokens as $token => $class) {
if (stripos($userAgent, $token) !== false) {
return 'claimed:' . $class;
}
}
return 'unknown';
}Die feste Werteliste verhindert frei erfundene Klassen und begrenzt die Zahl der Berichtswerte. Ein normaler Chrome-User-Agent ergibt „unknown“, nicht „human“. Ein unbekannter bestätigter Betreiber wird konservativ nicht automatisch einer bekannten Klasse zugeordnet. Klassen dienen der Analyse und ersetzen keine Zugriffsberechtigung.
Logs und GA4 gemeinsam, aber getrennt auswerten
Serverprotokolle zählen Anfragen. GA4 zählt erfasste Ereignisse und daraus abgeleitete Sitzungen. Zehn Bildabrufe sind deshalb weder zehn Menschen noch zehn Sitzungen. Bei einer Auslieferung direkt aus dem CDN sieht der Ursprungsserver den Abruf nicht; dann werden auch CDN-Protokolle benötigt. Für die Übersicht reichen häufig Zeitpunkt, Pfad ohne Suchparameter, Status, Klasse und Prüfverfahren. Personenbezogene oder geheime URL-Inhalte gehören nicht ungeprüft in zusätzliche Analyseprotokolle.
Die Klasse kann vor dem ersten Analyseereignis als traffic_class in den dataLayer gelangen und anschließend mit jedem relevanten Ereignis gesendet werden. Voraussetzung bleibt die geltende Einwilligungs- und Messkonfiguration. GA4 benötigt für Berichte eine benutzerdefinierte Dimension mit Ereignisbereich. Deren Registrierung wirkt nicht rückwirkend; bereits zuvor exportierte Rohparameter können jedoch unabhängig davon in BigQuery auswertbar sein. [4]
In gemeinsam zwischengespeichertem HTML darf keine besucherspezifische Klasse feststehen. Geeignet sind eine sichere Ergänzung pro Auslieferung oder ein kontrollierter Cache-Schlüssel mit der begrenzten Klasse. Bei serverseitigem Tagging muss auch die Messanfrage zuverlässig klassifiziert werden. Die Signatur einer Seitenanfrage geht nicht automatisch auf eine spätere Analyseanfrage über.
Sitzungen ohne falsche Zusammenfassung zählen
Die folgende BigQuery-Abfrage ist ein Auswertungsbeispiel für tägliche GA4-Exporttabellen. Projekt, Dataset und Zeitraum sind Platzhalter. Zusammen gruppiert werden Stream, pseudonyme Kennung und Sitzungsnummer. Fehlende Kennungen werden ausgeschlossen und müssen zusätzlich als nicht zuordenbare Ereignisse gezählt werden. Sonst würden viele unbekannte Ereignisse zu einer erfundenen Sitzung zusammenfallen. [5]
WITH events AS (
  SELECT
    stream_id, user_pseudo_id,
    (SELECT value.int_value FROM UNNEST(event_params)
      WHERE key = 'ga_session_id') AS session_id,
    NULLIF((SELECT value.string_value FROM UNNEST(event_params)
      WHERE key = 'traffic_class'), '') AS traffic_class,
    event_name
  FROM `my-project.analytics_123456789.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
), sessions AS (
  SELECT stream_id, user_pseudo_id, session_id,
    CASE
      WHEN COUNT(DISTINCT traffic_class) = 0 THEN 'not_set'
      WHEN COUNT(DISTINCT traffic_class) = 1 THEN MAX(traffic_class)
      ELSE 'mixed'
    END AS traffic_class,
    COUNTIF(event_name = 'purchase') > 0 AS purchased
  FROM events
  WHERE stream_id IS NOT NULL
    AND user_pseudo_id IS NOT NULL
    AND session_id IS NOT NULL
  GROUP BY stream_id, user_pseudo_id, session_id
)
SELECT traffic_class, COUNT(*) AS sessions,
  COUNTIF(purchased) AS purchasing_sessions,
  ROUND(100 * SAFE_DIVIDE(COUNTIF(purchased), COUNT(*)), 2) AS purchase_rate_pct
FROM sessions
GROUP BY traffic_class
ORDER BY sessions DESC;
Bei mehreren unterschiedlichen Klassen erhält die Sitzung den Wert „mixed“. MAX wird nur verwendet, nachdem genau ein unterschiedlicher Wert festgestellt wurde. Fehlende einzelne Klassen innerhalb einer sonst markierten Sitzung werden hier ignoriert; diese Abdeckung braucht eine separate Prüfung. Der Zeitraum begrenzt die beobachteten Ereignisse und kann Sitzungen am Rand abschneiden. Die Kaufquote bedeutet Sitzungen mit mindestens einem purchase-Ereignis geteilt durch beobachtete zuordenbare Sitzungen. Das ist weder Umsatzanteil noch ein Kausalnachweis für Verzerrung.
WebMCP misst einen Werkzeugaufruf
WebMCP bietet Browser-Agenten definierte Website-Funktionen. Die aktuelle Chrome-Dokumentation verwendet document.modelContext. Die Schnittstelle ist weiterhin in Entwicklung; Verfügbarkeit und Versuchsteilnahme sind vor dem Einsatz anhand der Primärdokumentation zu prüfen. Der Aufruf eines registrierten Handlers ist ein messbarer Funktionsaufruf, aber kein kryptografischer Identitätsnachweis des ausführenden Akteurs. [6]
export async function registerSearchTool(doc, search, record) {
  if (!doc.modelContext?.registerTool) return false;
  await doc.modelContext.registerTool({
    name: 'search_products',
    description: 'Produktsuche nach Suchbegriff und optionaler Preisobergrenze.',
    inputSchema: {
      type: 'object',
      properties: {
        query: { type: 'string', minLength: 1, maxLength: 200 },
        max_price: { type: 'number', minimum: 0 }
      },
      required: ['query'],
      additionalProperties: false
    },
    async execute(input) {
      if (!input || typeof input.query !== 'string' ||
          !input.query.trim() || input.query.length > 200 ||
          Object.keys(input).some(k => !['query', 'max_price'].includes(k)) ||
          (input.max_price !== undefined &&
           (!Number.isFinite(input.max_price) || input.max_price < 0))) {
        throw new Error('Invalid search input');
      }
      const params = new URLSearchParams({ q: input.query.trim() });
      if (input.max_price !== undefined) {
        params.set('max', String(input.max_price));
      }
      const result = await search(params);
      record({ event: 'webmcp_tool_success', tool_name: 'search_products' });
      return JSON.stringify(result);
    }
  });
  return true;
}
Das Modul erhält drei Abhängigkeiten: das Dokument, eine Suchfunktion und eine Messfunktion. Die Suche muss den echten Endpunkt aufrufen, HTTP-Fehler prüfen und dessen Ergebnisformat validieren. Die Messfunktion berücksichtigt die Einwilligung und sollte Messfehler auffangen, ohne die erfolgreiche Suche abzubrechen. Erst nach erfolgreicher Suche wird webmcp_tool_success gemeldet. Eine Preisgrenze von 0 bleibt gültig. Suchbegriffe und Ergebnisse gelangen nicht in das Messereignis. Die Eingabeprüfung ersetzt keine Berechtigungs- und Datenprüfung am Server.
Filter und maschinelle Abrufe
Hostname-Include-Filter können eingehende GA4-Daten auf erlaubte Hostnamen begrenzen. Laut Google sind leere Hostnamen betroffen, während Measurement-Protocol-Ereignisse ausgenommen bleiben. Der Testzustand hilft vor der Aktivierung; ein aktiver Datenfilter entfernt Daten dauerhaft und ist keine nachträgliche Berichtsansicht. Der Hostname ist kein Agentennachweis. [1, 7]
Data Manager API unterstützt laut Google serverseitige Analytics-Ereignisse. Daraus folgt keine Notwendigkeit, jeden Crawlerabruf in GA4 zu übertragen. Für rohe Maschinenabrufe ist ein eigenes Log-Dataset oft klarer. Dadurch werden keine künstlichen Nutzer- oder Sitzungskennungen benötigt. Eine separate GA4-Property wäre nur mit passendem Messmodell, gültigen Identifikatoren und den erforderlichen Datenschutzvoraussetzungen sinnvoll.
Fragen und Antworten
Kann bereits erfasster Traffic später getrennt werden?
Ja, sofern geeignete Merkmale bereits gespeichert wurden. Berichtsfilter oder BigQuery können solche Daten nachträglich segmentieren. Fehlende Identitätsnachweise lassen sich daraus jedoch nicht zuverlässig zurückgewinnen. Die Registrierung einer neuen GA4-Dimension und eine rückwirkende Auswertung vorhandener Rohdaten sind unterschiedliche Vorgänge.
Warum reicht eine andere Kaufquote nicht als Beweis?
Eine Gruppe kann andere Produkte, Herkunftsquellen oder Aufgaben haben. Zusätzlich können Erkennungsfehler vorliegen. Eine abweichende Kaufquote beschreibt zunächst einen Unterschied zwischen den beobachteten Gruppen. Selbst der Anteil von Checkout-Seitenaufrufen lässt keinen direkten Schluss auf Umsatz oder abgeschlossene Käufe zu.
Was ist der wichtigste Kontrollfall?
Ein Zugriff ohne belastbaren Nachweis muss unbekannt bleiben. Zusätzlich benötigen gefälschte Klassifikationsheader, wechselnde Klassen innerhalb einer Sitzung und Seiten aus dem CDN-Cache eigene Proben. Erst diese Gegenproben zeigen, ob die Klassifikation zuverlässig weitergereicht wird.
Quellen
- Versionshinweise zu Google Analytics
- Nutzerausgelöste Google-Abrufe
- Cloudflare: Web Bot Auth
- Benutzerdefinierte Ereignisdimensionen
- Schema des BigQuery-Exports
- Chrome: imperative WebMCP-Schnittstelle
- Hostname-Filter
Quellen geprüft: 26. Oktober 2026.
Passend dazu