English
 Deutsch
 Polski
Mac Studio M5 als AI-Schmiede: M5 Max, M5 Ultra und Mac mini M6 im LLM-Vergleich

Management Summary
Mac Studio und Mac mini können als eigene Arbeitsplätze für Sprachmodelle dienen, also KI-Systeme für Texte und Antworten. Der Artikel ordnet die Geräte nach ihrem Nutzen für solche Aufgaben ein. Ihr gemeinsamer Speicher wird auch von anderen Programmen benötigt und steht nicht vollständig der KI zur Verfügung. Entscheidend ist deshalb, welche Arbeit auf dem konkreten Rechner sinnvoll möglich ist. Größere Ausstattung kann mehr Aufgaben ermöglichen, ersetzt aber keine Einschätzung von Tempo, Strombedarf und Lautstärke.
Inhalt
Ein Mac Studio kann große Sprachmodelle direkt auf dem eigenen Rechner ausführen. Entscheidend sind ausreichend Speicher und ein Programm, das die Apple-Hardware unterstützt. Eine austauschbare Grafikkarte wie in vielen Tower-PCs gehört nicht zu diesem Konzept.
Am 25. Oktober 2026 nennt Apple den Mac Studio mit M5 Max oder M5 Ultra und den Mac mini mit M6 oder M5 Pro. Die Tabelle betrachtet drei ausgewählte Varianten, nicht die gesamte Mac-Palette. Die Zahlen stammen aus technischen Daten; eigene Messungen der Antwortgeschwindigkeit liegen nicht vor.
Drei konkrete Apple-Profile
| Gerät | Unified Memory | Dokumentierte Bandbreite |
|---|---|---|
| Mac mini M6 | 16 bis 32 GB | 153 beziehungsweise 170 GB/s |
| Mac Studio M5 Max | 36 bis 128 GB | 460 beziehungsweise 614 GB/s |
| Mac Studio M5 Ultra | 96 bis 512 GB | 1,2 TB/s |
Die Kapazität hängt von der bestellten Ausführung ab. Beim M5 Max nennt Apple 128 GB zusammen mit der Variante mit 40 GPU-Kernen; beim M5 Ultra gehören 512 GB zur Variante mit 80 GPU-Kernen. Der Mac mini M6 ist trotz höherer Generationenzahl auf weniger Speicher begrenzt. Die Bandbreite beschreibt den möglichen Datentransport pro Sekunde, nicht die Geschwindigkeit fertiger Antworten.
Unified Memory ist ein gemeinsames Budget
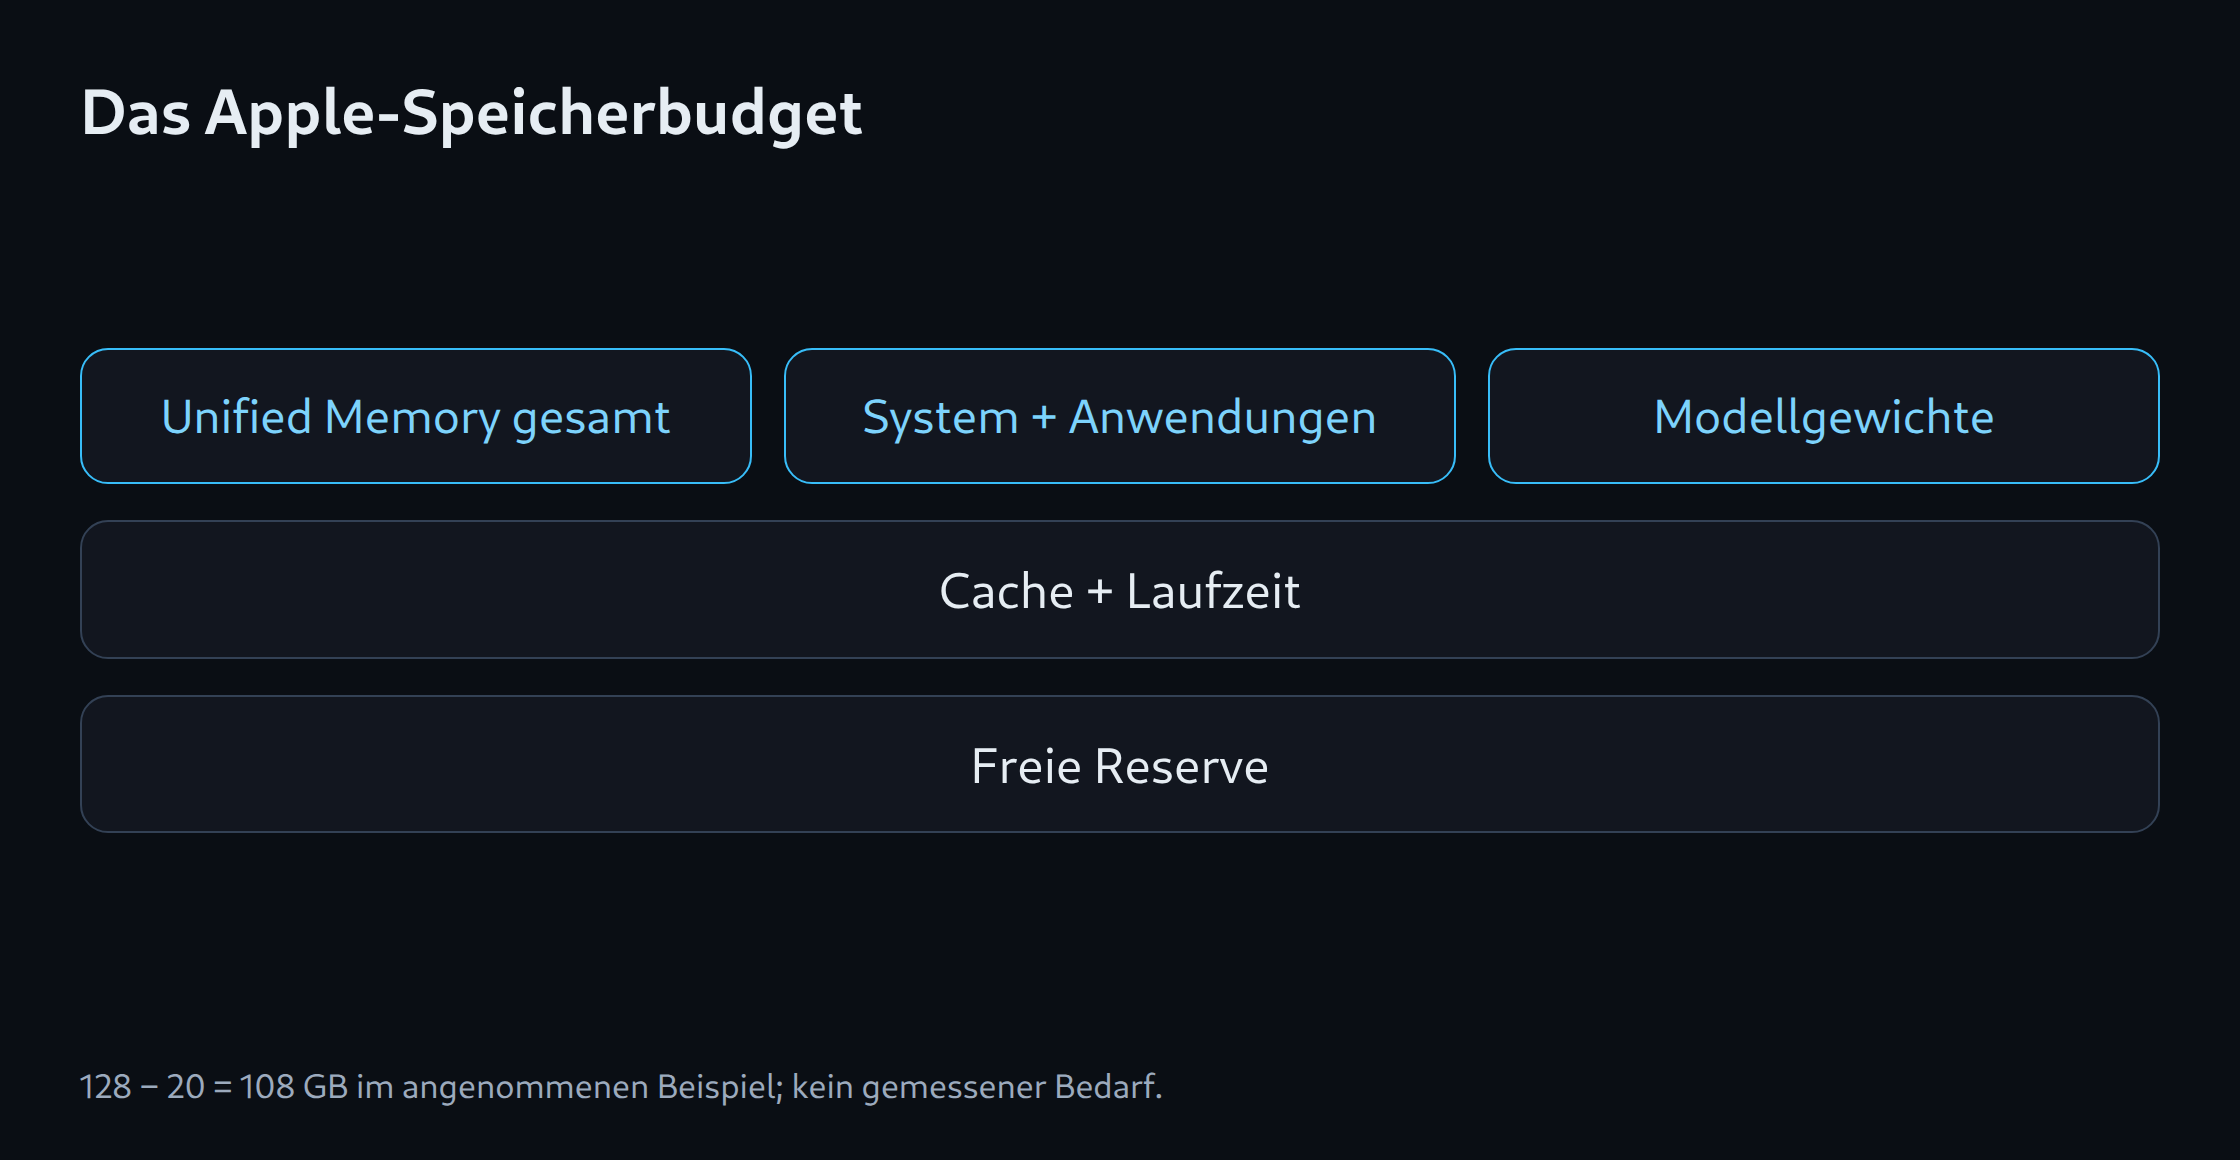
Unified Memory bedeutet gemeinsam genutzten Arbeitsspeicher. Hauptprozessor und Grafikprozessor greifen darauf zu; Betriebssystem und andere Programme belegen ebenfalls Platz. Zusätzlich zu den Modellgewichten, also den gespeicherten Zahlenwerten des Modells, werden Zwischenergebnisse und vorübergehende Arbeitsbereiche benötigt. 512 GB Gesamtspeicher sind deshalb keine 512 GB frei nutzbarer Modellplatz.
Ein angenommenes Beispiel reserviert bei 128 GB insgesamt 20 GB für System und weitere Anwendungen. Rechnerisch bleiben 108 GB für Modell und ausführendes Programm. Die 20 GB sind frei gewählt, kein Apple-Mindestwert. Auch die verbleibenden 108 GB sind keine zugesicherte GPU-Zuteilung: macOS und das Programm können weitere Grenzen setzen. Für einen dauerhaft laufenden Dienst zählt eine Messung mit typischen Eingaben und gleichzeitig laufenden Anwendungen.
MLX, llama.cpp und Ollama
MLX LM erzeugt Text mit Modellen für Apple Silicon. llama.cpp kann die GPU über Apples Metal-Schnittstelle nutzen; Ollama dokumentiert ebenfalls Metal-Unterstützung. Der verlinkte Ollama-Beitrag zu MLX beschreibt dagegen eine konkrete Vorschau mit einem bestimmten Modell und nennt mehr als 32 GB Speicher als Voraussetzung. Diese Vorschau ist keine Zusage für jedes Ollama-Modell oder jede spätere Version.
Eine Modelldatei für MLX und eine GGUF-Datei für llama.cpp sind nicht einfach austauschbar. Ein fairer Vergleich beginnt mit derselben ursprünglichen Modellversion. Quantisierung bedeutet eine platzsparende Darstellung der Modellwerte mit geringerer Genauigkeit; auch diese Einstellung wird festgehalten. Das Chat-Template legt fest, wie Systemhinweise und Nachrichten für das Modell zusammengesetzt werden. Unterschiede daran können Antworten verändern, selbst auf derselben Hardware.
Neural Engine und GPU-Beschleunigung unterscheiden
Apple unterscheidet Neural Accelerators in der GPU von der separaten Neural Engine. Ein Programm nutzt solche Recheneinheiten nur, wenn der gewählte Softwareweg das unterstützt. Die Zahl der Neural-Engine-Kerne sagt deshalb allein nichts darüber aus, wie schnell ein beliebiges Sprachmodell antwortet.
Bei einem Chat wird die Zeit vom Absenden bis zum ersten Antwortteil getrennt von der weiteren Textausgabe gemessen. Lange Eingaben brauchen vor der ersten Ausgabe zusätzliche Verarbeitung. Ein Dienst für mehrere Personen muss außerdem mit gleichzeitig eintreffenden Anfragen getestet werden. Ein Modell kann in den Speicher passen und trotzdem zu langsam für den geplanten Einsatz sein.
Mac, Tower-PC und DGX Spark vergleichen
Bei einem Tower-PC lassen sich je nach Aufbau Grafikkarte und andere Komponenten austauschen. Eine passende NVIDIA-Karte ermöglicht Programme auf Basis von CUDA. DGX Spark verwendet ebenfalls NVIDIA-GPU-Technik, aber einen Arm-Prozessor; Programme und Container müssen zu dieser Plattform passen. Der Mac benötigt wiederum ein unterstütztes Modellformat und eine passende Version des ausführenden Programms.
Die Auswahl beginnt daher mit einer konkreten Aufgabe und deren Speicherbedarf. Ein kleineres Modell kann auf einem mini ausreichen; ein größeres Modell oder längere Eingaben können mehr Speicher verlangen. Lautstärke, Stromaufnahme an der Steckdose und Antwortzeiten müssen am vorgesehenen Gerät gemessen werden. Der verlinkte Rechner hilft bei einer ersten Schätzung. Ohne einen Test der tatsächlichen Aufgaben ist daraus keine Kaufzusage ableitbar.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Gibt es im aktuellen Vergleich einen Mac Studio M6?
Apple dokumentiert aktuell den Mac Studio mit M5 Max oder M5 Ultra und den Mac mini mit M6. Der Plan verwendet diese Produktzuordnung. Ein späteres Studio-Modell benötigt eigene bestätigte Daten.
Sind 512 GB Unified Memory vollständig für das LLM verfügbar?
Nein. Betriebssystem, andere Programme und das Modell teilen sich den Speicher. Neben den gespeicherten Modellwerten brauchen auch Zwischenergebnisse Platz. Wie viel Speicher das Modell tatsächlich nutzen kann, hängt von den laufenden Programmen und den Grenzen von macOS ab.
Quellen
- Apple: Mac Studio M5 Max / M5 Ultra – technische Daten
- Apple: Mac mini M6 und Mac Studio M5 verfügbar
- MLX LM: Projekt
- llama.cpp: Projekt und Backends
- Ollama: Hardware support
- NVIDIA: DGX Spark Hardware Overview
- Apple: Mac mini – technische Daten
- Ollama: MLX on Apple Silicon
Quellen geprüft: 25. Oktober 2026.
Passend dazu