English
 Deutsch
 Polski
meta_query in WP_Query: Wie jede Klausel zu einem Join wird und was das kostet

Inhalt
Eine Seite, die Beiträge nach drei eigenen Feldern filtert, ist in PHP ein Feld und in SQL vier Verbindungen. Das Feld liest sich wie ein Filter; das SQL liest sich wie eine Tabelle, die für jede Bedingung erneut besucht wird – denn genau das ist es.
Das Bemerkenswerte ist nicht, dass es langsam ist; die meisten Seiten werden nie groß genug, dass es auffiele. Bemerkenswert ist, dass die Kosten in dem Code unsichtbar sind, der sie verursacht, und dass sie mit zwei Dingen zugleich wachsen: mit der Zahl der Klauseln und mit der Größe einer Tabelle, die sich niemand ansieht.
Was WP_Query aus dem Feld baut
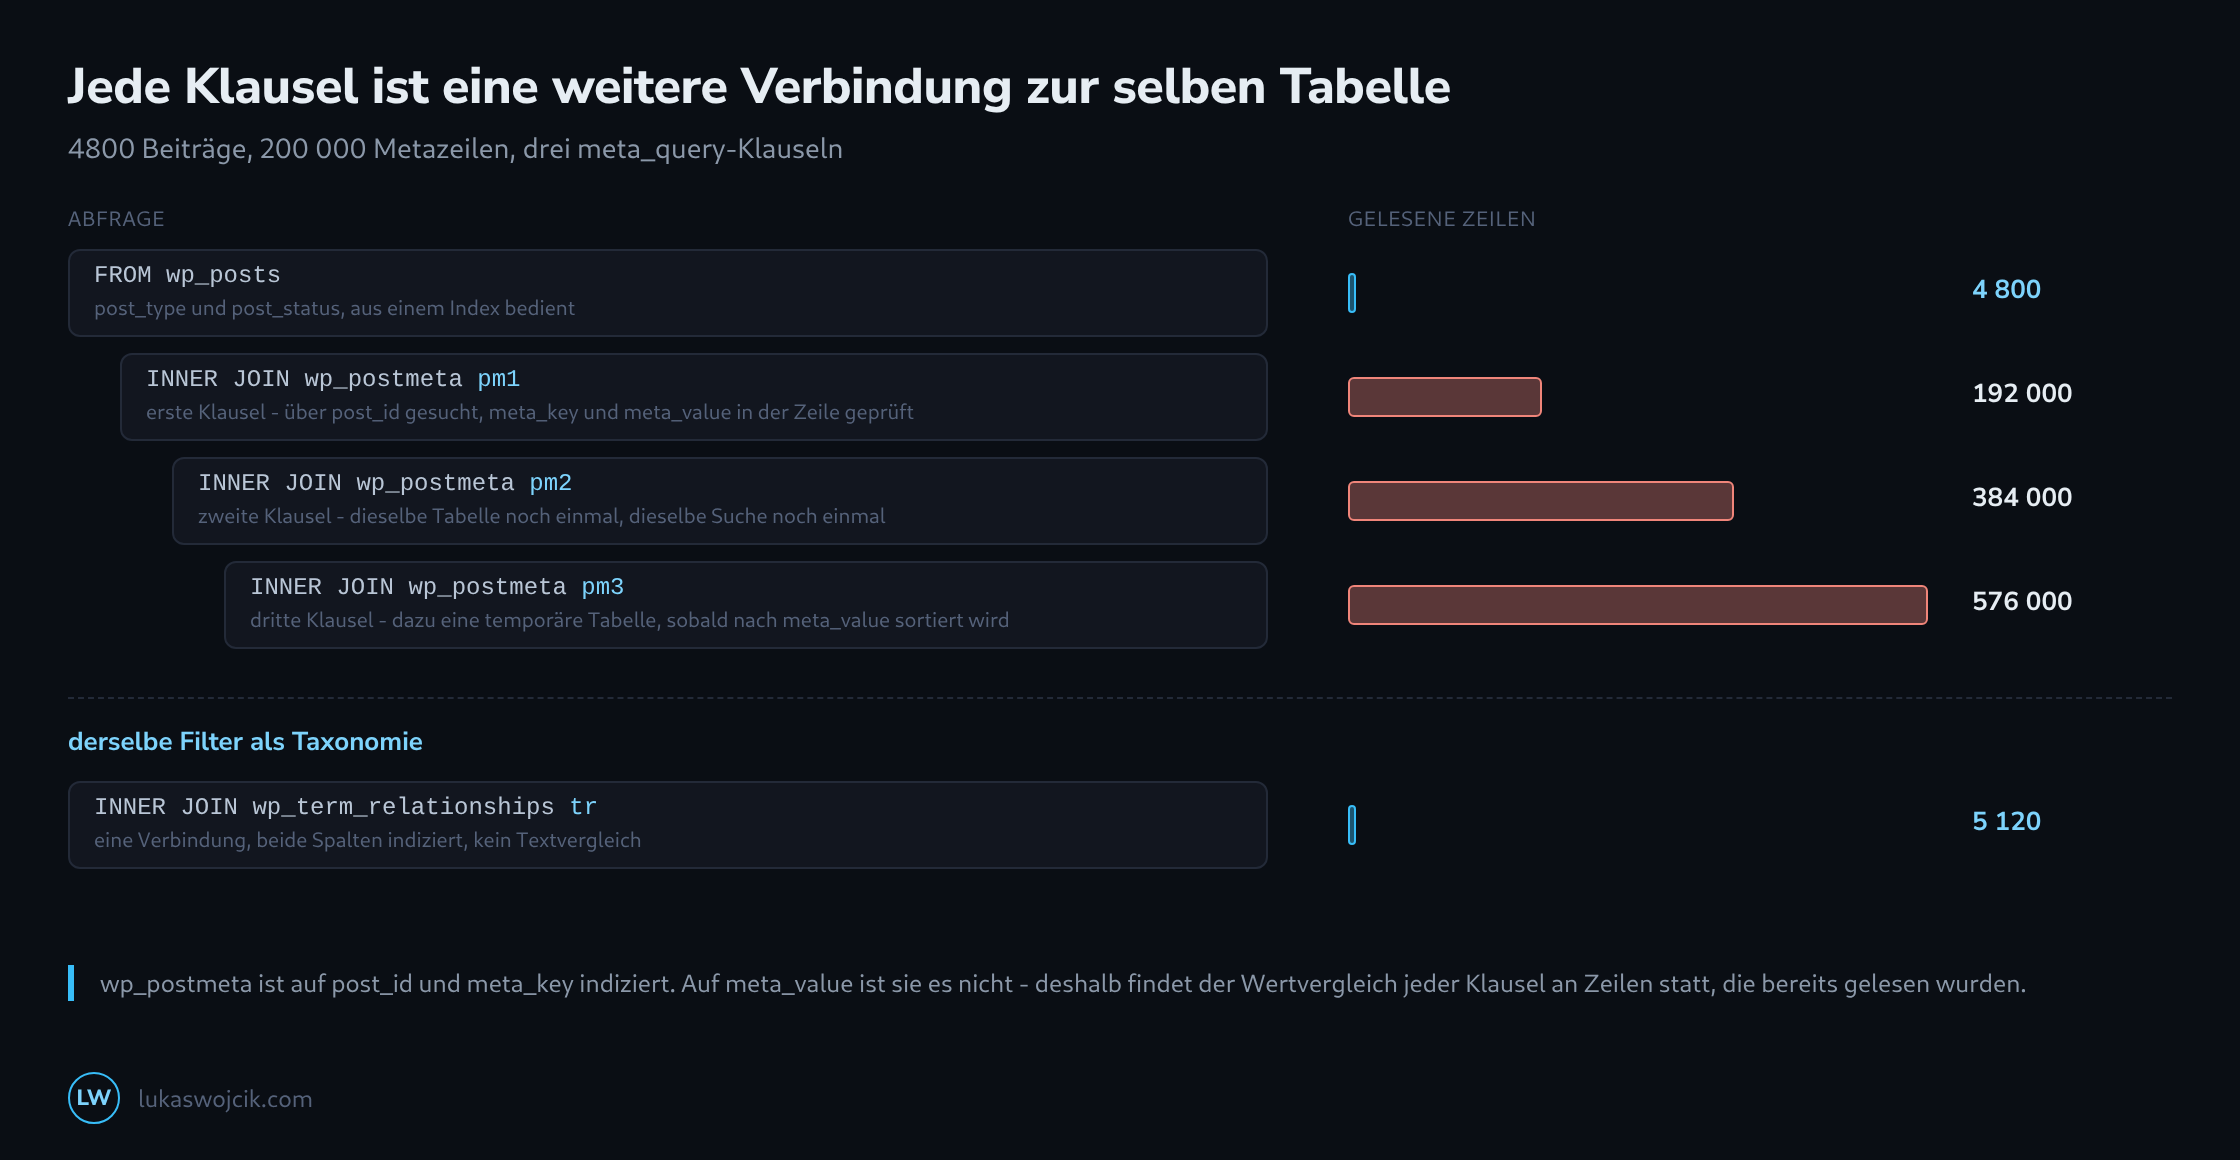
Jede Klausel in meta_query bekommt einen eigenen Aliasnamen auf wp_postmeta und eine eigene Verbindungsbedingung. Zwei Klauseln, zwei Aliasnamen; fünf Klauseln, fünf. Die Tabelle wird so oft mit sich selbst verbunden, wie es Bedingungen gibt, und jede dieser Verbindungen trägt das volle Gewicht der Tabelle hinter sich her.
SELECT wp_posts.ID FROM wp_posts
  INNER JOIN wp_postmeta pm1 ON wp_posts.ID = pm1.post_id
  INNER JOIN wp_postmeta pm2 ON wp_posts.ID = pm2.post_id
  INNER JOIN wp_postmeta pm3 ON wp_posts.ID = pm3.post_id
WHERE post_type = 'post' AND post_status = 'publish'
  AND ( pm1.meta_key = '_region' AND pm1.meta_value = 'nord' )
  AND ( pm2.meta_key = '_stufe'  AND pm2.meta_value = 'b' )
  AND ( pm3.meta_key = '_aktiv'  AND pm3.meta_value = '1' )
ORDER BY wp_posts.post_date DESC
Daran ist nichts falsch. Es ist die wörtliche Übersetzung des Gewünschten, und die Datenbank beantwortet sie richtig – nachdem sie auf einer mittelgroßen Seite in der Größenordnung einer halben Million Zeilen gelesen hat, um vierzig zurückzugeben.
Der Index, den es nicht gibt
wp_postmeta trägt drei Indizes: den Primärschlüssel auf meta_id, einen auf post_id und einen auf die ersten 191 Zeichen von meta_key. Auf meta_value gibt es keinen, und es kann sinnvoll auch keinen geben: Die Spalte ist LONGTEXT, und ein Index auf eine Textspalte unbegrenzter Länge ist entweder ein Präfix oder gar nichts.
Jede Klausel wird deshalb in zwei Bewegungen beantwortet. Die Verbindung findet die Zeilen zu einem Beitrag über post_id – schnell, indiziert, genau wofür ein Index da ist. Danach wird der Wert innerhalb jeder dieser Zeilen verglichen, eine nach der anderen, ohne Hilfe von irgendwoher. Der Aufwand ist der Zahl der Metazeilen je Beitrag proportional, und die liegt auf einer Seite mit Seitenbaukasten und ein paar Erweiterungen selten unter dreißig.
Die Klauseln, die mehr kosten als die anderen
| Klausel | Was die Datenbank dafür tun muss |
|---|---|
'compare' => '=' |
der Grundfall: eine Verbindung, ein Zeichenkettenvergleich je Zeile |
'compare' => 'LIKE' |
dasselbe mit Mustervergleich; ein führender Platzhalter schließt jede Abkürzung aus |
'type' => 'NUMERIC' |
legt CAST() um die Spalte und nimmt damit die letzte Aussicht auf Indexnutzung |
'compare' => 'NOT EXISTS' |
eine LEFT JOIN samt IS-NULL-Prüfung – jede nicht passende Zeile muss erst entstehen |
'relation' => 'OR' |
die Klauseln engen einander nicht mehr ein; die Zwischenmenge ist die Vereinigung |
'orderby' => 'meta_value' |
eine temporäre Tabelle und eine Sortierung über eine Textspalte |
Die letzte Zeile macht aus einer langsamen Seite eine Zeitüberschreitung. Nach einem Metawert zu sortieren, lässt sich aus keinem Index bedienen; die Datenbank baut also das gesamte Zwischenergebnis auf und sortiert es – und weil meta_value ein LONGTEXT ist, geschieht diese Sortierung auf der Platte statt im Arbeitsspeicher, sobald die Menge groß wird.
NOT EXISTS verdient eine eigene Warnung. Es liest sich wie das billige Gegenteil von EXISTS und ist das Gegenteil von billig: Abwesenheit nachzuweisen heißt, jeden Kandidaten zu besuchen – und das ist genau das, was ein Index nicht abkürzen kann.
Wohin der Filter stattdessen gehört
Ein Wert, nach dem gefiltert wird, ist keine Eigenschaft eines Beitrags in dem Sinn, in dem ein Untertitel eine ist. Er ist eine Einordnung, und für Einordnungen hat WordPress bereits eine Struktur mit den richtigen Indizes: wp_term_relationships ist auf beiden Spalten indiziert, ein Begriffsfilter ist also eine Verbindung, die vollständig aus Indizes beantwortet wird, ganz ohne Textvergleich.
Die Regel daraus ist kurz. Was gefiltert oder sortiert wird, gehört in eine Taxonomie – oder, wenn die Werte wirklich zahlenmäßig und stetig sind, in eine Spalte einer eigenen Tabelle. Was erst gelesen wird, nachdem der Beitrag gefunden ist, kann in den Metadaten bleiben, wo es genau einen Zugriff über post_id kostet und sonst nichts.
Messen statt schätzen
Die von WP_Query gebaute Abfrage steht vor der Ausführung bereit: In $query->request liegt das fertige SQL, und durch EXPLAIN geschickt beantwortet es die einzigen zwei Fragen, auf die es ankommt. Die Spalte rows ist die Schätzung, wie viele Zeilen jeder Schritt lesen wird; die Spalte Extra benennt die teuren Formen unverblümt, und Using temporary; Using filesort zusammen sind die Unterschrift einer Sortierung, die nicht mitwächst.
wp db query "EXPLAIN SELECT wp_posts.ID FROM wp_posts INNER JOIN ..."

id  select_type  table     type    key       rows    Extra
1   SIMPLE       wp_posts  ref     type_st.  4800    Using temporary; Using filesort
1   SIMPLE       pm1       ref     post_id     40    Using where
1   SIMPLE       pm2       ref     post_id     40    Using where
1   SIMPLE       pm3       ref     post_id     40    Using where
Drei Zeilen mit Using where hinter einem Zugriff über post_id sind genau das oben beschriebene Bild: Der Index hat die Zeilen gefunden, die Bedingung wurde danach angewandt. Die Zahl in rows, über die Verbindungen multipliziert, ist die Größe, die mit der Seite wächst – und es lohnt sich, sie an dem Tag zu kennen, an dem die Abfrage geschrieben wird, statt an dem, an dem die Seite nicht mehr lädt.
Fragen und Antworten
Macht ein Unterstrich vor dem Schlüssel, wie bei _region, die Abfrage schneller?
Nein. Ein führender Unterstrich kennzeichnet ein Feld nur als geschützt, und WordPress blendet es deshalb im Editor in der Liste der individuellen Felder aus. Für die Datenbank ist er ein Zeichen wie jedes andere, und der Index auf meta_key findet _region genauso schnell wie region.
Hilft ein persistenter Objektcache gegen eine teure meta_query?
Er verdeckt die Kosten, statt sie zu beseitigen. Seit WordPress 6.1 legt WP_Query die gefundenen Beitragsnummern im Objektcache ab, und mit einem persistenten Cache wie Redis wird eine wiederholte, identische Abfrage dann ohne SQL beantwortet. Der Schlüssel dieses Eintrags wird aus der Abfrage gebildet, und ungültig wird er, sobald irgendein Beitrag gespeichert wird, nicht nur einer aus dem Ergebnis.
Daraus folgen zwei Grenzen. Jede Filterkombination ist eine eigene Abfrage und damit ein eigener Eintrag: Eine Filterseite mit drei Feldern zu je fünf Werten kennt allein 125 Kombinationen, in denen alle drei gesetzt sind, und jede davon zahlt beim ersten Aufruf den vollen Preis. Und wo laufend Beiträge gespeichert werden, etwa durch regelmäßige Importe, verfallen die Einträge, bevor sie sich auszahlen.
Für die Messung heißt das: Das SQL aus $query->request, durch EXPLAIN geschickt, zeigt den Fall ohne Cache, und genau der zählt, weil er bei jeder neuen Kombination und nach jeder Änderung eintritt. Ein Seitencache vor WordPress hilft aus demselben Grund nur begrenzt, denn jede Filterkombination ist eine eigene Adresse.
Quellen
Passend dazu