English
 Deutsch
 Polski
410 Gone na robots.txt: jak odpowiedź 4xx na plik reguł zmienia zachowanie crawlera

Management Summary
Odpowiedź 410 Gone informuje odwiedzającego lub wyszukiwarkę, że strona została usunięta. Plik robots.txt ma inne zadanie: przekazuje współpracującym robotom zasady dostępu. Zwrócenie 410 dla tego pliku nie oznacza zakazu dalszych odwiedzin. Ma to znaczenie przy zamykaniu witryny lub ograniczaniu ruchu, ponieważ zbyt wczesna blokada może przeszkodzić wyszukiwarce w rozpoznaniu usunięcia treści. Odciążenie serwera i usunięcie wyników wyszukiwania wymagają więc osobnych decyzji.
Spis treści
Crawler to program automatycznie pobierający strony, na przykład dla wyszukiwarki. Wyłączony host może odpowiadać 410 Gone dla usuniętych stron, a mimo to otrzymywać żądania crawlerów. Odpowiedź na /robots.txt wymaga osobnej kontroli: status usunięcia pliku reguł sam nie jest zakazem pobierania.
Usunięcie i crawling to różne decyzje
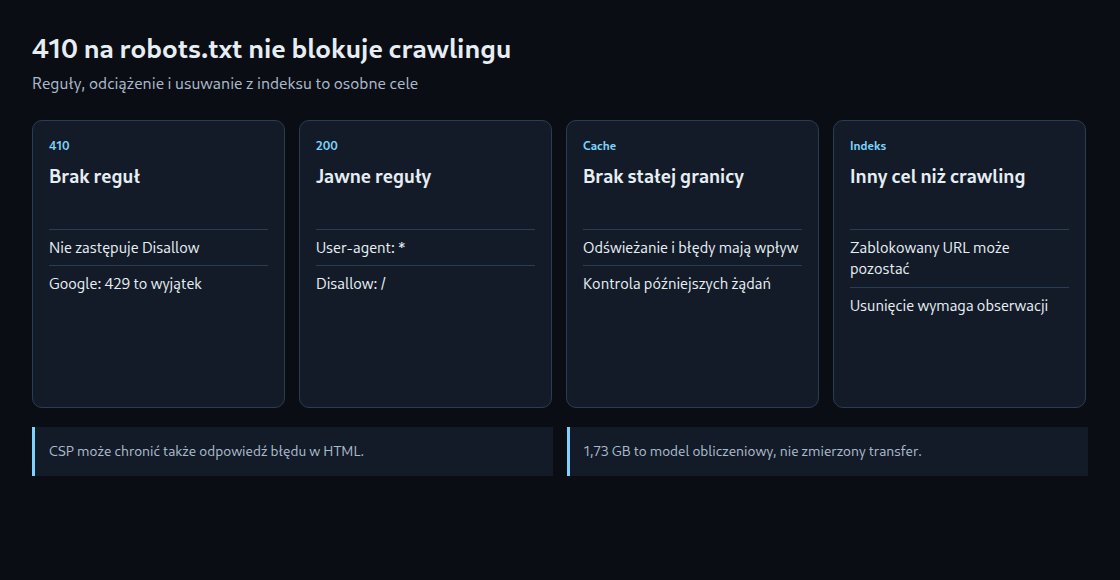
410 oznacza, że zasób docelowy nie jest już dostępny i prawdopodobnie pozostanie niedostępny. 404 nie określa, czy brak jest tymczasowy czy trwały. Żaden kod nie gwarantuje natychmiastowego końca żądań. Aktualna dokumentacja Google opisuje zwykłe odpowiedzi 404 i 410 wspólnie w kontekście późniejszego usuwania z indeksu. Ogólna gwarancja szybszego usunięcia przez 410 jest nieuzasadniona.
Dlaczego 410 na robots.txt nie blokuje
RFC 9309 dopuszcza crawling, gdy plik reguł jest niedostępny, na przykład po odpowiedzi 4xx. Dotyczy to protokołu wykluczania, nie zgody na omijanie logowania czy kontroli dostępu. Google dokumentuje traktowanie 4xx poza 429 jako braku ograniczeń crawlingu. Wyjątek ma znaczenie: 429 sygnalizuje przeciążenie.
Poprawna odpowiedź z regułami powinna zawierać zwykły tekst UTF-8. Minimalny plik dla wyłączonego origin wygląda następująco:
User-agent: *
Disallow: /
Plik wymaga rzeczywistej odpowiedzi sukcesu. Ten sam tekst w odpowiedzi 410 nie jest równoważny. Reguły dotyczą danego protokołu, hosta i portu. Istniejące bardziej szczegółowe grupy crawlerów lub reguły Allow mogą zmieniać wynik. Dopisanie dwóch linii do złożonego pliku nie jest więc uniwersalną blokadą.
Błąd serwera nie zastępuje trwałej reguły
RFC 9309 początkowo wymaga pełnego zakazu przy nieosiągalności reguł wskutek błędów serwera lub sieci, ale pozwala na inne postępowanie po długiej awarii. Udokumentowany proces Google zaczyna się od dwunastogodzinnej przerwy, po której przez maksymalnie 30 dni używana jest ostatnia poprawna kopia. Bez zapisanej kopii późniejsze zachowanie może dopuszczać pobieranie. Celowo uszkodzony endpoint nie jest zatem dobrym zamiennikiem jawnych reguł.
Zalecenie standardu dotyczące zwykle 24 godzin pamięci ma wyjątek dla nieosiągalnego pliku. Google także dokumentuje zmienne okresy przechowywania. Nie istnieje gwarancja działania do następnego dnia; efekty mogą pojawić się wcześniej. Dowodem są udane pobrania, faktycznie podane reguły i późniejsze żądania, a nie sam upływ czasu.
Co wynika z historycznego zdarzenia
Archiwalny artykuł opisuje szeroką regułę 410 obejmującą robots.txt oraz liczne adresy z parametrami. Podano 732 498 odpowiedzi ogółem i 698 400 żądań z identyfikatorem crawlera, w tym 696 907 różnych adresów. Pierwotny zbiór żądań z wyznaczonym zakresem czasu nie był dostępny w sprawdzonym pakiecie artykułu. Wartości pozostają historycznymi danymi przytoczonymi, nie niezależnie potwierdzonym pomiarem.
Obliczenie daje 1493 powtórzone żądania, około 0,214% żądań z identyfikatorem crawlera. Duży udział różnych adresów pasuje do rozległej przestrzeni URL, ale nie dowodzi nieskończonej pętli linków ani dalszego odczytywania odnośników z odpowiedzi 410. Taka przyczynowość wymaga danych o źródle, generowanych linkach, czasie i zweryfikowanej tożsamości crawlera. Sam User-Agent nie potwierdza tożsamości.
Rozmiar odpowiedzi wymaga jednostek i kontekstu
Jako czysty model obliczeniowy liczby z artykułu dają 732 498 × 2364 bajty = 1 731 625 272 bajty, czyli około 1,73 GB lub 1,61 GiB. Przy 850 bajtach wynik to 622 623 300 bajtów, około 64,0% mniej. Koryguje to wcześniejsze 1,65 GB.
Mnożenie nie jest pomiarem ruchu na łączu. Kompresja nagłówków HTTP/2 lub HTTP/3, kompresja treści oraz narzut TLS i transportu zmieniają rzeczywistą ilość danych. Deklarowane rozmiary pojedynczych odpowiedzi wymagają opisanej metody i protokołu przed wyciąganiem wniosków o transferze.
Nagłówki bezpieczeństwa dopasowane do odpowiedzi
Status błędu może nadal nieść dokument HTML ze skryptami, linkami lub odbitymi danymi wejściowymi. Content Security Policy (CSP) może określać, które skrypty i inne zasoby przeglądarka może ładować dla takiego dokumentu. Zalecenie „nagłówki bezpieczeństwa nigdy nie należą do odmów” jest więc błędne. Stała odpowiedź tekstowa może uzasadniać mniejszą politykę, lecz decyzja zależy od typu treści i sposobu wyświetlania. Inne nagłówki mają inne zadania i wymagają osobnej oceny.
Cel operacyjny decyduje o kolejności
Jawne reguły robots mogą ograniczyć pracę współpracujących crawlerów. Nie zatrzymują technicznie dowolnych klientów ani pobrań odświeżających robots.txt. Kontrola dostępu i limity żądań są osobnymi środkami. Usunięcie nieaktualnego generowania linków usuwa inne możliwe źródło ciągłej pracy.
Usunięcie z wyszukiwarki wymaga dostępu crawlera do odpowiedzi 404, 410 lub obsługiwanego noindex. Wcześniejsza blokada może uniemożliwić tę obserwację i pozostawić znany URL w wynikach. Kolejność zależy od priorytetu: szybkiego odciążenia albo usunięcia z indeksu. Oczekiwanie na zniknięcie każdego możliwego adresu nie jest uniwersalną procedurą. Weryfikacja obejmuje każdy origin, odpowiedź reguł, odpowiedzi treści i późniejszy ruch.
Źródła
Powiązane artykuły