English
 Deutsch
 Polski
gzip, Brotli i zstd: pomiar kompresji HTTP

Management Summary
Kompresja HTTP pakuje treść strony oszczędniej na czas przesyłania, zmniejszając ilość danych wysyłanych do przeglądarki. gzip, Brotli i zstd to różne metody takiego pakowania. Próba dwudziestu domen pokazuje praktyczne użycie, ale różna treść witryn nie pozwala stworzyć rankingu metod. Ważna jest równowaga między rozmiarem transmisji, pracą komputera i ładowaniem. Mniej danych pomaga, lecz nie przyspiesza całej strony proporcjonalnie, ponieważ inne etapy również zajmują czas.
Spis treści
Kompresja HTTP zmniejsza liczbę bajtów przesyłanych w treści odpowiedzi. Wynik zależy od danych, ustawień kompresji i faktycznie otrzymanej odpowiedzi. Sam pomyślny status HTTP nie dowodzi pobrania oczekiwanej strony głównej.
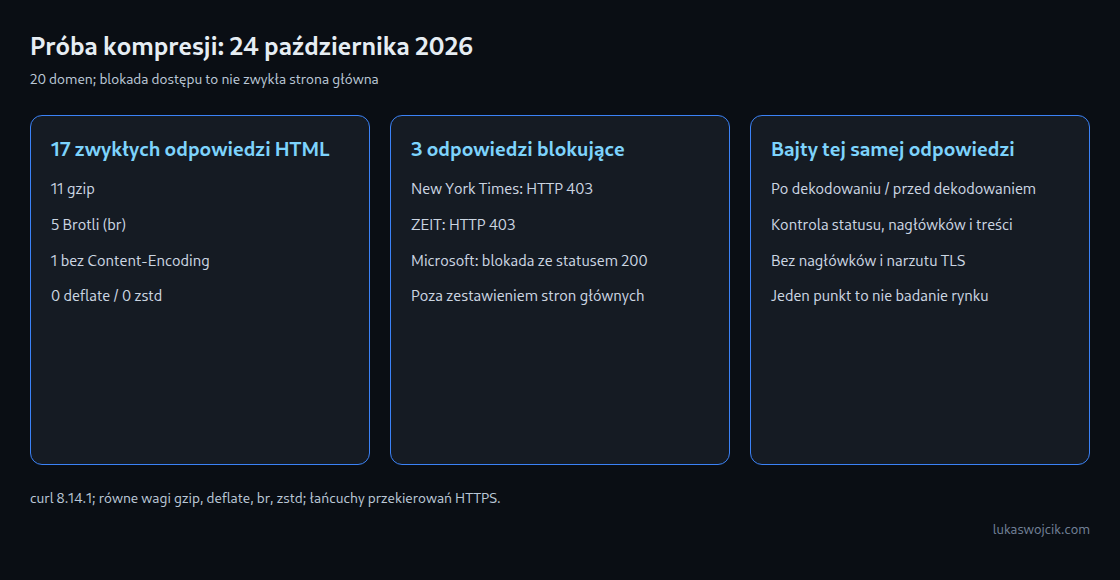
Kontrola dwudziestu domen 24 października 2026 dała siedemnaście zwykłych odpowiedzi HTML i trzy odpowiedzi blokujące dostęp. Wśród siedemnastu zwykłych odpowiedzi jedenaście użyło gzip, pięć Brotli, a jedna nie miała Content-Encoding. Żadna odpowiedź nie wybrała zstd. To obserwacje jednej konfiguracji żądań, nie udziały rynkowe ani trwałe ustawienia witryn.
Jak wybierane jest kodowanie odpowiedzi
Accept-Encoding podaje akceptowane kodowania odpowiedzi. W próbie zaoferowano gzip, deflate, br, zstd z równymi domyślnymi wagami. Na wybór wpływają możliwości serwera, konfiguracja i rodzaj zasobu; kolejność listy nie gwarantuje preferencji. Odpowiedź bez kodowania zwykle również jest dopuszczalna, o ile nie została wyraźnie wykluczona.
Content-Encoding wskazuje faktycznie zastosowane kodowanie. Brak pola oznacza brak zadeklarowanego kodowania treści, a nie zgodność z plikiem na dysku. HTML może powstawać dynamicznie. Możliwe są też kolejne warstwy kodowania; dekodowanie odbywa się wtedy w odwrotnej kolejności.
Gdy reprezentacja zależy od tego pola żądania, Vary: Accept-Encoding pomaga poprawnie działającym pamięciom podręcznym rozdzielić warianty. Nagłówek nie dowodzi prawidłowej konfiguracji każdego pośrednika. Odpowiedź z pamięci lub wcześniej skompresowany plik nie musi być kompresowany ponownie przy każdym żądaniu.
gzip, Brotli, zstd i deflate
- gzip: szeroko obsługiwany, lecz nie gwarantowany w każdym programie ani wariancie narzędzia. Nadal liczą się zgłoszone możliwości.
- Brotli (
br): często skuteczny dla tekstu. Wyższe poziomy jakości mogą dawać mniejsze pliki, ale wymagają więcej obliczeń; stała przewaga szybkości lub wielkości nie dotyczy wszystkich danych. - Zstandard (
zstd): zaprojektowany z myślą o korzystnym kompromisie szybkości i kompresji. Wynik zależy od poziomu, implementacji, sprzętu oraz danych. Brak wyboru w tej próbie nie dowodzi braku obsługi w przeglądarkach ani na wszystkich serwerach. - deflate: kodowanie HTTP używa opakowania zlib wokół DEFLATE. gzip również zwykle korzysta z DEFLATE, lecz z innym opakowaniem. Formaty nie są zamienne.
Rzeczywista oferta przeglądarki zależy od wersji i kontekstu. Ręcznie skonstruowane żądanie curl nie jest testem zgodności przeglądarek.
Zmierzone odpowiedzi
Pomiar wykonano z Raspberry Pi 24 października 2026 między 04:45:33 a 04:45:37 UTC. curl 8.14.1 obsługiwał wszystkie cztery oferowane dekodery. Dla każdej domeny wykonano jeden łańcuch pobrania z przekierowaniami HTTPS, bez logowania i JavaScriptu przeglądarki, z domyślnym identyfikatorem curl. Tabela opisuje końcową odpowiedź. Nagłówki, zdekodowane treści i metadane curl zostały zachowane do weryfikacji.
| Domena | HTTP | Content-Encoding | Bajty zakodowane | Bajty po dekodowaniu | Ocena |
|---|---|---|---|---|---|
| wikipedia.org | 200 | gzip | 28883 | 122421 | zwykły HTML |
| github.com | 200 | gzip | 118918 | 580257 | zwykły HTML |
| bbc.com | 200 | gzip | 92972 | 649846 | zwykły HTML |
| nytimes.com | 403 | brak | 771 | 771 | blokada dostępu |
| cloudflare.com | 200 | br | 109639 | 1333885 | zwykły HTML |
| mozilla.org | 200 | br | 8032 | 47807 | zwykły HTML |
| apple.com | 200 | gzip | 47325 | 326751 | zwykły HTML |
| microsoft.com | 200 | brak | 201253 | 201253 | blokada dostępu |
| spiegel.de | 200 | gzip | 272825 | 1958177 | zwykły HTML |
| heise.de | 200 | gzip | 135977 | 936097 | zwykły HTML |
| python.org | 200 | brak | 52766 | 52766 | zwykły HTML |
| debian.org | 200 | gzip | 4279 | 15864 | zwykły HTML |
| kernel.org | 200 | gzip | 3438 | 19152 | zwykły HTML |
| gnu.org | 200 | gzip | 9806 | 31463 | zwykły HTML |
| w3.org | 200 | br | 8996 | 49520 | zwykły HTML |
| nginx.org | 200 | gzip | 2206 | 6461 | zwykły HTML |
| postgresql.org | 200 | gzip | 5914 | 25040 | zwykły HTML |
| zeit.de | 403 | brak | 5439 | 5439 | blokada dostępu |
| tagesschau.de | 200 | br | 128481 | 1613994 | zwykły HTML |
| php.net | 200 | br | 11789 | 60308 | zwykły HTML |
New York Times i ZEIT zwróciły HTTP 403. Microsoft zwrócił HTTP 200, ale treść jednoznacznie informowała o blokadzie dostępu. Te trzy odpowiedzi nie wchodzą do zestawienia zwykłych stron głównych. Treść odpowiedzi Microsoft miała 201 253 bajty bez zadeklarowanego kodowania; nie określa to polityki kompresji właściwej strony głównej Microsoft.
Python.org zwróciła w tym przebiegu zwykły HTML strony głównej bez Content-Encoding. Informacja o braku JavaScriptu znajduje się wewnątrz tej strony; sama informacja nie oznacza osobnej strony blokady. Wcześniejsze lub inaczej skonfigurowane żądania mogą otrzymać inną reprezentację.
Współczynnik i oszczędność to różne liczby
Współczynnik to liczba bajtów po dekodowaniu podzielona przez liczbę bajtów zakodowanej treści. Wartość 4 oznacza jedną czwartą pierwotnego rozmiaru, czyli 75% mniej bajtów. Nie oznacza czterokrotnie szybszego wyświetlania strony.
Dla skompresowanych zwykłych odpowiedzi współczynniki wyniosły od 2,93 dla nginx.org do 12,56 dla tagesschau.de. W drugim przypadku 1 613 994 bajtom po dekodowaniu odpowiadało 128 481 bajtów zakodowanej treści, czyli około 92,0% mniej danych odpowiedzi. Liczby nie obejmują nagłówków, narzutu TLS i transportu, innych zasobów strony ani renderowania.
Różne witryny dostarczają różne dane wejściowe. Takie współczynniki nie tworzą rankingu algorytmów. Rzetelne porównanie kompresuje identyczne bajty przy udokumentowanych ustawieniach oraz mierzy czas CPU obok rozmiaru. O dostępnej nadmiarowości decydują powtórzenia, nie sama długość pliku ani użycie frameworka.
Pomiar wymaga tej samej treści
Dwa osobne żądania mogą pomieszać różne treści, przekierowania, błędy lub warianty pamięci. Także żądanie identity wymaga sprawdzenia rzeczywistego Content-Encoding. Porównanie rozmiaru przesłanego i rozpakowanego dla tej samej odpowiedzi zapobiega porównywaniu różnych treści, ale nadal wymaga pełnego udanego transferu, poprawnego dekodowania i kontroli zawartości.
W tym pomiarze curl używał --compressed: zapisany plik był zdekodowany, natomiast size_download mierzył przesłane bajty treści odpowiedzi. Zapisane nagłówki nadal opisują kodowanie transmisji. Wzmianka o gzip w nagłówkach nie uzasadnia więc ponownego rozpakowania już zdekodowanego pliku.
Pytania i odpowiedzi
Czy dodatkowa kompresja pomaga obrazom i fontom?
Już skompresowane pliki JPEG, PNG, WebP, AVIF i WOFF2 często niewiele zyskują albo rosną. SVG jest tekstem i często korzysta z kompresji. Samo rozszerzenie nie wystarcza; znaczenie mają rzeczywiste bajty i typ MIME.
Czy Brotli zawsze powinien używać najwyższej jakości?
Nie. Brotli obsługuje poziomy jakości 0–11. Wysokie ustawienia mogą wymagać znacznie więcej obliczeń. Pliki statyczne można kompresować podczas budowania; przy odpowiedziach dynamicznych koszt kompresji musi odpowiadać dostępnej mocy procesora i dopuszczalnemu czasowi odpowiedzi. gzip i zstd również umożliwiają wcześniejszą kompresję. Ta próba nie wskazuje uniwersalnie najlepszego poziomu.
Czy HTTPS usuwa ryzyko kompresji?
Nie. W atakach typu BREACH różnice długości skompresowanych odpowiedzi mogą ujawniać informacje o tajnych wartościach. Ryzyko występuje, gdy sekret i dane kontrolowane przez atakującego trafiają do wspólnej skompresowanej odpowiedzi, a długości kolejnych odpowiedzi są obserwowalne. Zwykłe kodowanie znaków HTML samo nie usuwa tego warunku. Zależnie od aplikacji środki ochrony obejmują wyłączenie kompresji dla zagrożonych odpowiedzi, oddzielenie sekretów od odbijanych danych lub poprawne maskowanie tokenów. TLS 1.3 usuwa kompresję TLS, lecz nie kodowanie treści HTTP ani związane z tym kanały boczne.
Jak ręcznie sprawdzić pojedynczą odpowiedź gzip?
Poniższe polecenie curl jest przeznaczone dla nowego pustego katalogu roboczego i małego zaufanego zasobu HTTPS. Pomija konfigurację curlrc, nie dekoduje automatycznie i nie śledzi przekierowań:
curl -q --fail --silent --show-error --max-time 30 --max-filesize 10000000 --proto "=https" -H "Accept-Encoding: gzip" -D headers.txt -o body.bin -w "%{http_code}\n" https://example.com/Przed dekodowaniem wypisany status musi wynosić 200, a końcowe nagłówki muszą deklarować dokładnie Content-Encoding: gzip. Przed interpretacją rozmiarów potrzebna jest następnie kontrola, czy zdekodowana treść odpowiada oczekiwanemu zasobowi. Przekierowanie, blokada, brak kodowania albo błąd curl nie stanowią pomiaru gzip. Dopiero po tych kontrolach:
gzip -t body.bin &&
gzip -dc body.bin > decoded.html &&
wc -c body.bin decoded.html
Pierwsze polecenie sprawdza integralność gzip; następne wykonują się tylko po sukcesie. Obie liczby bajtów dotyczą tej samej odpowiedzi. Dekodowanie może znacznie powiększyć dane, więc istotne są wolne miejsce i zaufane wejście. Brak Content-Encoding oznacza odpowiedź bez kodowania, a nie powód do wymuszenia gzip. Inne kodowania wymagają odpowiedniego dekodera.
Powiązane artykuły