English
 Deutsch
 Polski
Agenci AI w analityce internetowej: jak ruch agentowy zniekształca GA4 i jak oddzielić go po stronie serwera

Management Summary
Agenci AI to programy, które mogą odwiedzać i obsługiwać witryny zamiast człowieka. Ich wizyty mogą trafić do raportów, zwiększając ruch bez dodatkowych zakupów. Artykuł wyjaśnia znaczenie dla marketingu: spadek udziału wizyt zakończonych zakupem może częściowo wynikać ze zmiany rodzaju odwiedzających. Oddzielenie potwierdzonych wejść automatycznych pomaga interpretować wyniki. Samo odesłanie z AI nie dowodzi obsługi przez program, a część ruchu pozostaje nierozpoznana.
Spis treści
Agent przeglądarkowy może otwierać strony i wywoływać takie same zdarzenia analityczne jak wizyta człowieka. Liczba sesji może więc rosnąć bez dodatkowych zakupów. Skala zależy od witryny, agenta i konfiguracji pomiaru. Nie uzasadnia to ogólnego twierdzenia o większości stron.
Użyteczny raport oddziela dwa pytania: skąd pochodziła wizyta i jakie dowody wskazują na automatyzację. Odesłanie z AI odpowiada na pierwsze pytanie. Zweryfikowany identyfikator agenta dotyczy drugiego. Nierozpoznany ruch pozostaje nieznany.
Cztery rodzaje dostępu
- Człowiek klika link w odpowiedzi AI. Przeglądarka może uruchomić GA4, jeśli pomiar został załadowany i jest dozwolony.
- Usługa pobiera stronę na zlecenie użytkownika, na przykład ChatGPT-User. Bez wykonania tagu samo pobranie nie tworzy zdarzenia GA4.
- Agent przeglądarkowy obsługuje witrynę. JavaScript i zdarzenia analityczne są możliwe, lecz nie są gwarantowane dla każdego agenta i każdej konfiguracji.
- Robot wyszukiwarki lub crawler treningowy pobiera treść. Takie żądania powinny najpierw trafiać do osobnej analizy technicznej.
Kanał AI Assistant nie potwierdza działania człowieka
Google dokumentuje kanał AI Assistant od maja 2026. Rozpoznany referrer AI otrzymuje medium ai-assistant i kampanię (ai-assistant). Referrer to przesłany adres źródłowy. Nie dowodzi ani obsługi przez człowieka, ani tożsamości agenta: automatyczna przeglądarka również może przesłać pasujące źródło. Od czerwca Source Group łączy różne nazwy źródeł i według Google jest uzupełniany wstecznie. [1]
Bez źródła lub odpowiednich parametrów kampanii ruch może pojawić się jako Direct; inne sygnały przypisania mogą wpływać na wynik. Raport liczy zarejestrowane wizyty, a nie wszystkie wzmianki i linki w odpowiedziach AI. Więcej wejść bezpośrednich, porzucone koszyki czy regularne odstępy zdarzeń są wskazówkami do kontroli, a nie dowodem działania agenta.
Tożsamość i siła dowodu
User-Agent jest opisem przesłanym przez klienta. Ciąg taki jak Google-Agent łatwo podrobić. Google publikuje odpowiednie zakresy IP; weryfikacja musi korzystać z tych zakresów albo udokumentowanej procedury DNS. Procedura DNS obejmuje wyszukanie nazwy dla IP, sprawdzenie dozwolonej domeny i ponowne rozwiązanie nazwy na ten sam adres IP. Dowolny adres Google Cloud nie potwierdza tożsamości Google-Agent. [2]
Web Bot Auth może uwierzytelnić podpisującego operatora. Cloudflare opisuje podpisy HTTP i katalog kluczy publicznych oparte na nadal zmiennych projektach IETF. Poprawny podpis nie dowodzi automatycznie konkretnego polecenia człowieka, nieszkodliwości ani zamiaru zakupu. Same nagłówki podpisu również nie wystarczają. Weryfikacja wymaga zaufania do operatora, poprawnych podpisanych elementów, kontroli czasu i ochrony przed powtórzeniem żądania. [3]
CDN dostarcza treść przed serwerem źródłowym, a WAF sprawdza żądania według reguł bezpieczeństwa. Aplikacja może korzystać z ich oceny przez zabezpieczony kanał. Konieczne jest uniemożliwienie obejścia tej drogi; usługa pośrednia usuwa nadchodzące nagłówki klasyfikacji i ustawia własną wartość. Nagłówek z przeglądarki ani zwykła informacja o przekazanym IP nie są zaufanym wynikiem weryfikacji.
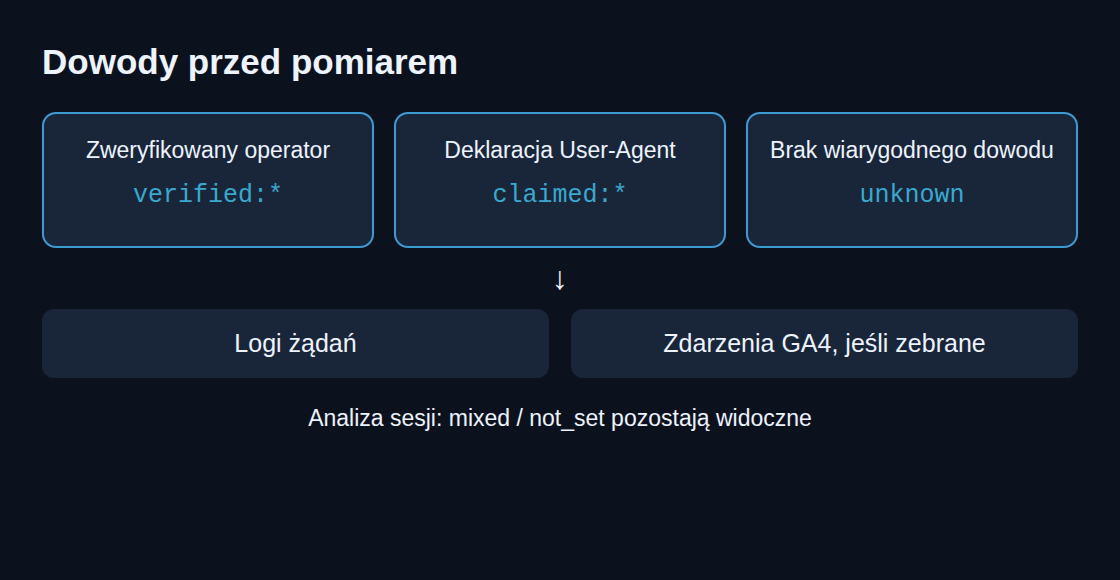
Mały klasyfikator z uczciwą kategorią nieznaną
Przykład PHP rozdziela potwierdzonych operatorów, deklaracje User-Agent i nieznane żądania. Drugi argument może pochodzić wyłącznie z wcześniej zweryfikowanej, zaufanej integracji serwerowej. Bez takiej integracji pozostaje null. Funkcja sama nie sprawdza podpisu ani IP. Surowy nagłówek HTTP nigdy nie powinien być przekazywany bezpośrednio jako drugi argument.
declare(strict_types=1);
function classifyTraffic(string $userAgent, ?string $verifiedClass = null): string
{
$verified = ['agent:google', 'fetcher:openai', 'fetcher:anthropic',
'fetcher:perplexity', 'crawler'];
if ($verifiedClass !== null && in_array($verifiedClass, $verified, true)) {
return 'verified:' . $verifiedClass;
}
$tokens = [
'Google-Agent' => 'agent:google',
'ChatGPT-User' => 'fetcher:openai',
'Claude-User' => 'fetcher:anthropic',
'Perplexity-User' => 'fetcher:perplexity',
'GPTBot' => 'crawler', 'OAI-SearchBot' => 'crawler',
'ClaudeBot' => 'crawler', 'PerplexityBot' => 'crawler',
];
foreach ($tokens as $token => $class) {
if (stripos($userAgent, $token) !== false) {
return 'claimed:' . $class;
}
}
return 'unknown';
}Stała lista blokuje dowolne nazwy klas i ogranicza liczbę wartości w raporcie. Zwykły User-Agent Chrome daje unknown, a nie human. Nieznany potwierdzony operator nie otrzymuje automatycznie znanej klasy. Klasy służą analizie i nie nadają uprawnień dostępu.
Logi i GA4 mierzą różne rzeczy
Logi serwera liczą żądania. GA4 liczy zebrane zdarzenia i wyznaczone z nich sesje. Dziesięć pobrań obrazów nie oznacza więc dziesięciu osób ani sesji. Serwer źródłowy nie widzi żądań obsłużonych bezpośrednio z pamięci CDN, dlatego potrzebne są także logi CDN. Do podsumowania często wystarczają czas, ścieżka bez parametrów zapytania, status, klasa i metoda weryfikacji. Osobowe lub tajne dane z adresów nie powinny bez kontroli trafiać do dodatkowych logów analitycznych.
Klasa może trafić do dataLayer jako traffic_class przed pierwszym zdarzeniem analitycznym, a potem towarzyszyć każdemu odpowiedniemu zdarzeniu. Nadal obowiązuje konfiguracja zgody i pomiaru. Raporty GA4 wymagają definicji niestandardowej o zakresie zdarzenia. Rejestracja nie działa wstecz, lecz wcześniej wyeksportowane surowe parametry mogą niezależnie pozostać dostępne do analizy w BigQuery. [4]
Wspólny bufor HTML nie może zawierać stałej klasy konkretnego odwiedzającego. Odpowiednie rozwiązania to bezpieczne uzupełnienie każdej odpowiedzi albo kontrolowany klucz cache z klasą z ograniczonego zbioru. Tagowanie serwerowe wymaga również wiarygodnej klasyfikacji żądania pomiarowego. Podpis żądania strony nie uwierzytelnia automatycznie późniejszego żądania analitycznego.
Liczenie sesji bez fałszywego łączenia
Przykład BigQuery dotyczy dziennych tabel eksportu GA4. Projekt, zbiór danych i daty są wartościami przykładowymi. Grupowanie obejmuje razem strumień, pseudonimowy identyfikator i numer sesji. Zdarzenia bez tych identyfikatorów są pomijane i wymagają osobnego licznika zdarzeń nieprzypisywalnych. Inaczej wiele niepowiązanych zdarzeń połączyłoby się w jedną wymyśloną sesję. [5]
WITH events AS (
  SELECT
    stream_id, user_pseudo_id,
    (SELECT value.int_value FROM UNNEST(event_params)
      WHERE key = 'ga_session_id') AS session_id,
    NULLIF((SELECT value.string_value FROM UNNEST(event_params)
      WHERE key = 'traffic_class'), '') AS traffic_class,
    event_name
  FROM `my-project.analytics_123456789.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
), sessions AS (
  SELECT stream_id, user_pseudo_id, session_id,
    CASE
      WHEN COUNT(DISTINCT traffic_class) = 0 THEN 'not_set'
      WHEN COUNT(DISTINCT traffic_class) = 1 THEN MAX(traffic_class)
      ELSE 'mixed'
    END AS traffic_class,
    COUNTIF(event_name = 'purchase') > 0 AS purchased
  FROM events
  WHERE stream_id IS NOT NULL
    AND user_pseudo_id IS NOT NULL
    AND session_id IS NOT NULL
  GROUP BY stream_id, user_pseudo_id, session_id
)
SELECT traffic_class, COUNT(*) AS sessions,
  COUNTIF(purchased) AS purchasing_sessions,
  ROUND(100 * SAFE_DIVIDE(COUNTIF(purchased), COUNT(*)), 2) AS purchase_rate_pct
FROM sessions
GROUP BY traffic_class
ORDER BY sessions DESC;
Sesja z kilkoma różnymi klasami otrzymuje mixed. MAX jest używane dopiero po stwierdzeniu dokładnie jednej różnej wartości. Brakujące pojedyncze klasy w oznaczonej sesji są tutaj pomijane; kompletność oznaczeń wymaga osobnej kontroli. Zakres dat ogranicza obserwowane zdarzenia i może ucinać sesje na granicach. Współczynnik zakupów oznacza sesje z co najmniej jednym zdarzeniem purchase podzielone przez obserwowane sesje możliwe do przypisania. Nie jest udziałem przychodu ani dowodem przyczynowym zniekształcenia.
WebMCP mierzy wywołanie narzędzia
WebMCP udostępnia agentom przeglądarkowym określone funkcje witryny. Aktualna dokumentacja Chrome używa document.modelContext. API nadal się rozwija; dostępność i warunki testowego wdrożenia wymagają kontroli w dokumentacji źródłowej przed zastosowaniem. Wykonany handler jest mierzalnym wywołaniem funkcji, a nie kryptograficznym dowodem tożsamości wykonawcy. [6]
export async function registerSearchTool(doc, search, record) {
  if (!doc.modelContext?.registerTool) return false;
  await doc.modelContext.registerTool({
    name: 'search_products',
    description: 'Wyszukiwanie produktów według frazy i opcjonalnej ceny maksymalnej.',
    inputSchema: {
      type: 'object',
      properties: {
        query: { type: 'string', minLength: 1, maxLength: 200 },
        max_price: { type: 'number', minimum: 0 }
      },
      required: ['query'],
      additionalProperties: false
    },
    async execute(input) {
      if (!input || typeof input.query !== 'string' ||
          !input.query.trim() || input.query.length > 200 ||
          Object.keys(input).some(k => !['query', 'max_price'].includes(k)) ||
          (input.max_price !== undefined &&
           (!Number.isFinite(input.max_price) || input.max_price < 0))) {
        throw new Error('Invalid search input');
      }
      const params = new URLSearchParams({ q: input.query.trim() });
      if (input.max_price !== undefined) {
        params.set('max', String(input.max_price));
      }
      const result = await search(params);
      record({ event: 'webmcp_tool_success', tool_name: 'search_products' });
      return JSON.stringify(result);
    }
  });
  return true;
}
Moduł przyjmuje trzy zależności: dokument, funkcję wyszukiwania i funkcję pomiaru. Wyszukiwanie musi wywołać rzeczywisty endpoint, sprawdzić błędy HTTP i zweryfikować odpowiedź. Pomiar uwzględnia zgodę i powinien przechwytywać błędy pomiarowe bez przerywania udanego wyszukiwania. webmcp_tool_success jest zgłaszane dopiero po udanym wyszukiwaniu. Cena maksymalna równa zero pozostaje poprawna. Frazy i wyniki wyszukiwania nie trafiają do zdarzenia pomiarowego. Kontrola wejścia nie zastępuje autoryzacji i walidacji na serwerze.
Filtry i żądania maszynowe
Filtry Hostname Include mogą ograniczać napływające dane GA4 do zatwierdzonych nazw hostów. Google wskazuje, że puste nazwy są objęte filtrem, natomiast zdarzenia Measurement Protocol są wyłączone z jego działania. Tryb testowy pomaga przed aktywacją; aktywny filtr danych trwale usuwa dane i nie jest wstecznym widokiem raportu. Nazwa hosta nie potwierdza tożsamości agenta. [1, 7]
Google dokumentuje zdarzenia Analytics wysyłane między serwerami przez Data Manager API. Nie oznacza to potrzeby przesyłania każdego pobrania crawlera do GA4. Dla surowych żądań maszynowych osobny zbiór logów bywa czytelniejszy i nie wymaga wymyślonych identyfikatorów użytkowników ani sesji. Osobna usługa GA4 wymagałaby odpowiedniego modelu pomiaru, poprawnych identyfikatorów i właściwych warunków ochrony danych.
Pytania i odpowiedzi
Czy zebrany już ruch można rozdzielić później?
Tak, jeśli przydatne cechy zostały wcześniej zapisane. Filtry raportu lub BigQuery mogą później podzielić te dane. Brakujących dowodów tożsamości nie da się jednak wiarygodnie odtworzyć. Rejestracja nowego wymiaru GA4 oraz wsteczna analiza istniejących surowych danych to różne czynności.
Dlaczego inny współczynnik zakupów nie wystarcza?
Grupy mogą obejmować inne produkty, źródła lub zadania; możliwe są również błędy klasyfikacji. Inny współczynnik zakupów opisuje najpierw różnicę między obserwowanymi grupami. Nawet udział żądań do stron checkoutu nie wskazuje bezpośrednio przychodu ani ukończonych zakupów.
Jaki przypadek kontrolny jest najważniejszy?
Żądanie bez wiarygodnego dowodu musi pozostać nieznane. Osobnych prób wymagają także podrobione nagłówki klasyfikacji, zmiany klasy w obrębie sesji i strony z pamięci CDN. Dopiero takie kontrole pokazują poprawność przekazywania klasy do raportu.
Źródła
- Informacje o wersjach Google Analytics
- Pobrania Google na żądanie użytkownika
- Cloudflare: Web Bot Auth
- Niestandardowe wymiary zdarzeń
- Schemat eksportu BigQuery
- Chrome: imperatywne API WebMCP
- Filtry nazw hostów
Źródła sprawdzone: 26 października 2026.
Powiązane artykuły