English
 Deutsch
 Polski
Q4, Q8, FP16 i długi kontekst: dlaczego lokalny model LLM nie działa mimo odpowiedniego rozmiaru pliku?

Spis treści
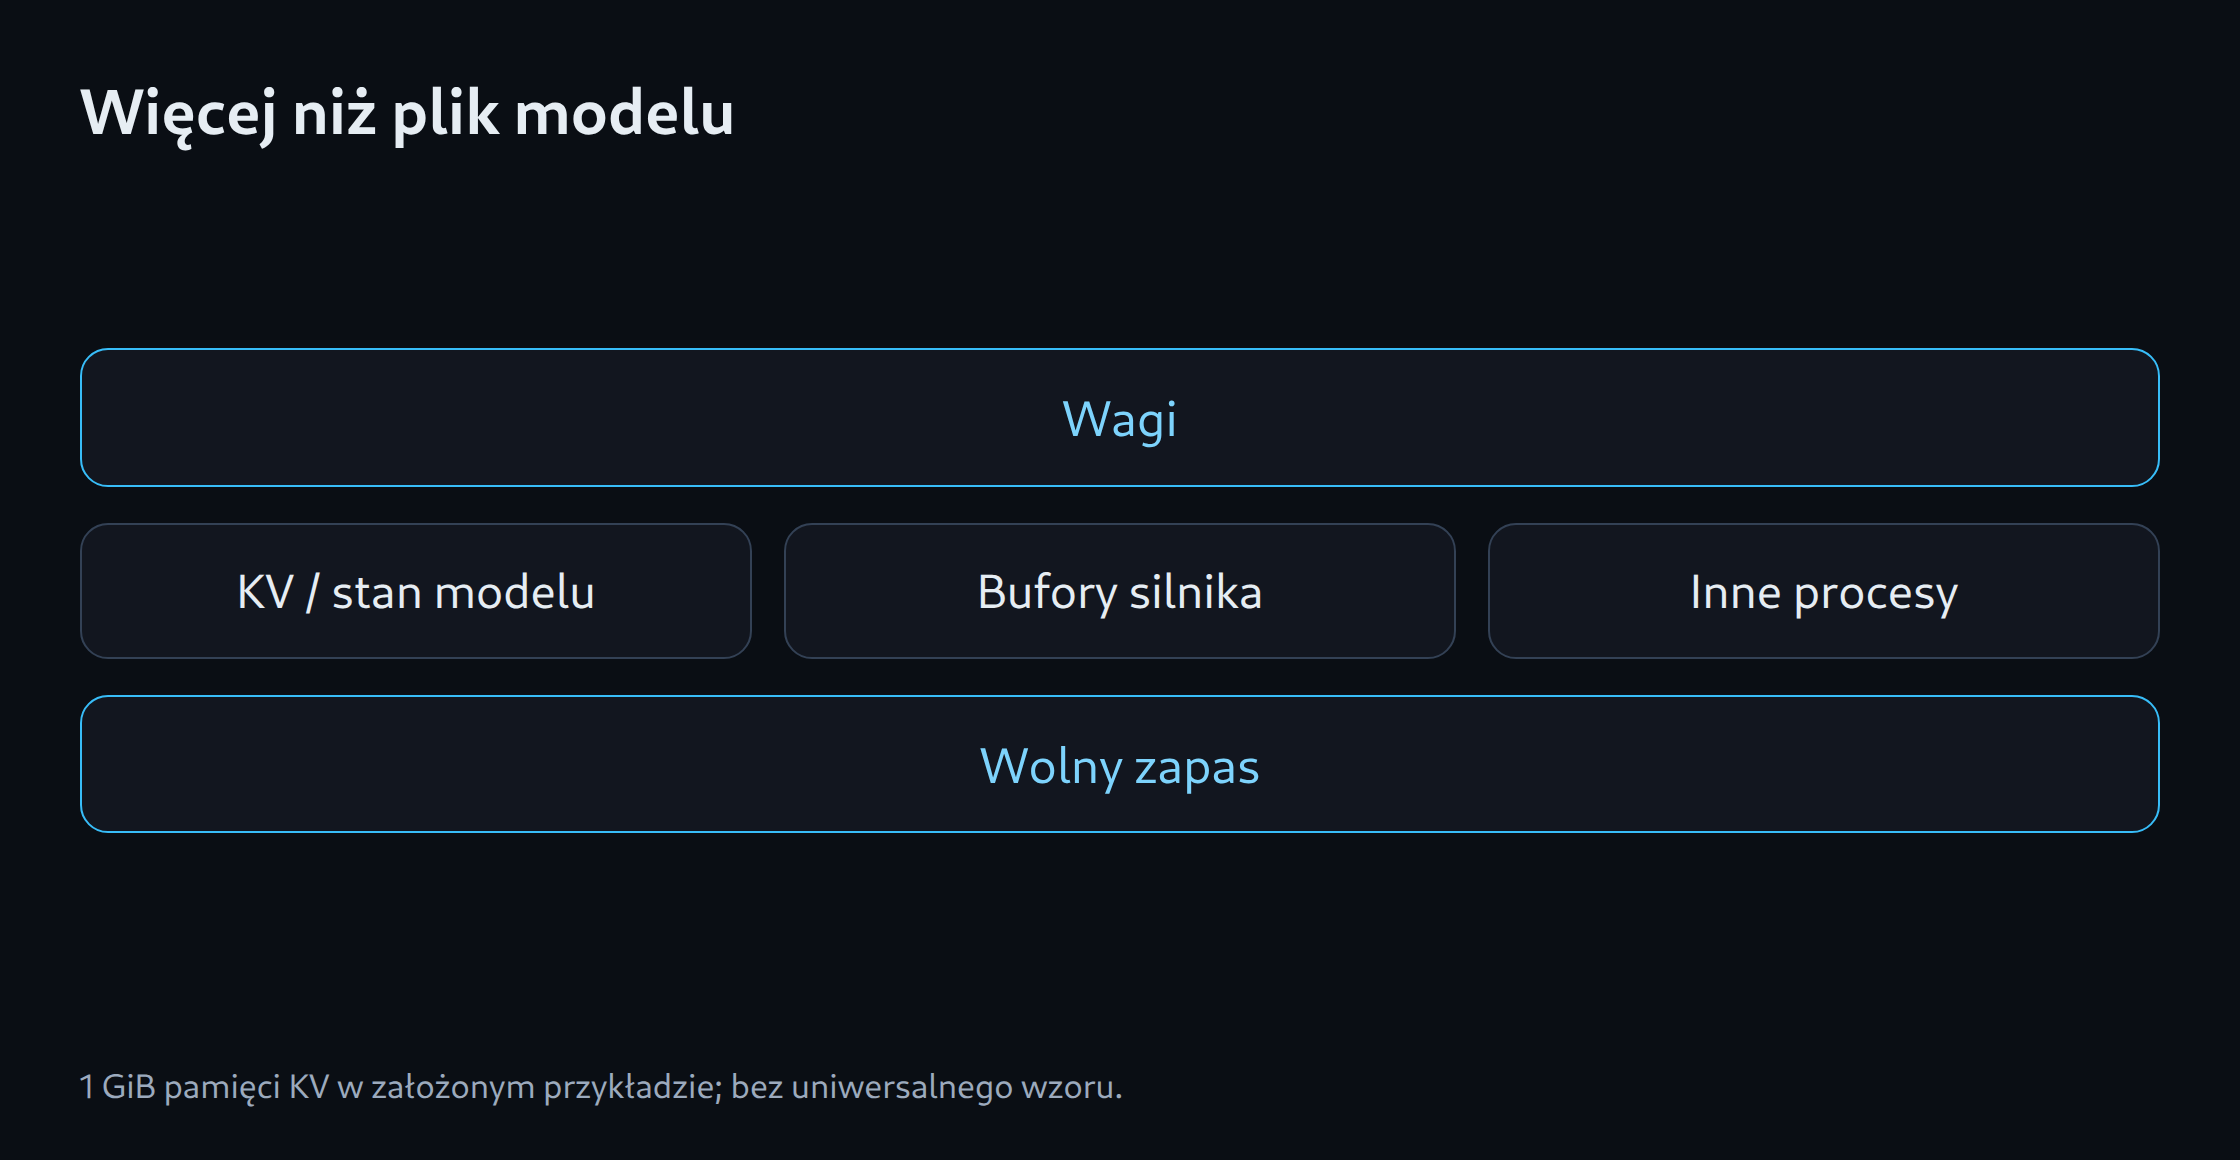
Plik modelu o rozmiarze 20 GB nie musi zmieścić się na karcie z 24 GB pamięci. Pobierany plik opisuje zapisane wagi i metadane. Podczas działania dochodzą stan kontekstu, bufory tymczasowe i inne alokacje. Dostępna pojemność jest także niższa od deklarowanej, gdy GPU obsługuje pozostałe aplikacje.
Kwantyzacja i kontekst wymagają wspólnego planowania. Porównanie wyjaśnia mechanizmy pamięci i obliczenia, bez wyprowadzania zmierzonego rankingu jakości lub szybkości.
Q4, Q8 i FP16 oznaczają różne budżety
| Przykład idealizowany | Obliczenie dla 30 miliardów wag | Same wagi |
|---|---|---|
| 4 bity | 30 miliardów × 0,5 bajta | 15 GB |
| 8 bitów | 30 miliardów × 1 bajt | 30 GB |
| 16 bitów | 30 miliardów × 2 bajty | 60 GB |
To teoretyczne wartości dziesiętne, nie rozmiary plików konkretnego modelu. Skale, bloki, mieszana precyzja i elementy bez kwantyzacji zmieniają wynik. GB i GiB także różnią się: 15 miliardów bajtów to około 13,97 GiB. Plik Q4 nie musi zawierać dokładnie czterech bitów na każdy parametr.
Kontekst zajmuje pamięć podczas pracy
Przy klasycznym mechanizmie uwagi pamięć KV przechowuje wcześniejsze klucze i wartości. Uproszczony wzór dla gęstego bufora KV to: dwa × warstwy × głowy KV × wymiar głowy × tokeny × bajty na wartość × sekwencje. Wzór wymaga właściwych założeń dotyczących architektury i środowiska.
Założony przykład z 32 warstwami, ośmioma głowami KV, wymiarem 128, 8192 tokenami i dwoma bajtami na wartość wymaga 1 GiB dla sekwencji. Cztery całkowicie zajęte podobne sekwencje wymagają 4 GiB. Wagi i bufory dochodzą osobno. Stronicowanie, kwantyzacja pamięci KV i inne wzorce uwagi zmieniają praktyczne alokacje.
Architektury hybrydowe wymagają własnych profili
Qwen3.5 wykorzystuje strukturę hybrydową z różnymi typami warstw. Wzór dla wyłącznie klasycznej uwagi nie powinien obejmować automatycznie każdej warstwy. Stan rekurencyjny, pamięć uwagi i elementy multimodalne wymagają danych z konfiguracji modelu oraz środowiska.
MoE także rozdziela aktywne obliczenia od wszystkich wag. Mała liczba aktywnych parametrów nie gwarantuje małego pliku. Planowanie na podstawie samej nazwy pomija takie różnice.
Przenoszenie danych zmienia profil pracy
llama.cpp obsługuje wykonanie hybrydowe na CPU i GPU. Częściowe przeniesienie wag może umożliwić uruchomienie większego modelu. To jednak inna konfiguracja niż pełna praca na GPU. RAM, wydajność CPU i transfery wpływają na odpowiedzi.
W porównaniu warto zapisać zajętość GPU, RAM, czas do pojawienia się pierwszego tokenu i tempo generowania. Poprawny start jest dopiero pierwszą kontrolą. Długie dokumenty i równoległe sesje mogą później ujawnić ograniczenie, którego nie widać podczas krótkiego czatu.
Kontrola jakości przed oszczędzaniem pamięci
Większy model Q4 nie wygrywa automatycznie jakością z mniejszym Q8. Trening, architektura i zadanie nadal mają znaczenie. Wspólny zestaw z oczekiwanymi odpowiedziami ujawnia błędy, pominięcia i problemy formatu; sam rozmiar nie potwierdza użyteczności.
Istniejący kalkulator pamięci zapewnia wstępną selekcję. Dane wejściowe powinny zawierać rewizję, backend, wolny zapas, kontekst i równoległość. Ostateczna konfiguracja wymaga kontroli rzeczywistej pamięci i krótkiego testu jakości. Nieznana architektura potrzebuje widocznej granicy szacowania zamiast pozornie dokładnej liczby.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Dlaczego plik modelu o rozmiarze 20 GB nie zawsze mieści się na GPU z 24 GB?
Bufory środowiska, stan modelu lub pamięć KV oraz inne alokacje zwiększają zapotrzebowanie ponad rozmiar pliku. Zużycie pamięci zależy od środowiska, architektury, kontekstu i równoległości.
Czy większy model Q4 jest zawsze lepszy od mniejszego Q8?
Sama precyzja nie wyznacza rankingu jakości. Rodzina modelu, trening i zadanie nadal mają kluczowe znaczenie. Porównanie wymaga tych samych zadań, udokumentowanych konfiguracji i oceny błędów zamiast samego rozmiaru pliku.
Źródła
- llama.cpp: Projekt und Backends
- Qwen: Qwen3.5-9B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- vLLM: GPU installation
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły