

 English
 Deutsch
 Polski
Wyrażenia regularne: zachłanna kropka, brak kotwic i zagnieżdżone powtórzenia

Management Summary
Wyrażenia regularne to zwięzłe reguły wyszukiwania lub sprawdzania wzorców tekstu, na przykład wymaganego formatu w formularzu. Na stronach i w przetwarzaniu danych jedna reguła może opisywać wiele możliwych wpisów. Wzorzec może jednak zaakceptować tylko poprawny fragment, objąć za dużo tekstu albo zbyt długo przetwarzać trudne dane. Artykuł wyjaśnia te typowe pułapki i znaczenie wyraźnych granic, gdy reguła wyszukiwania służy także do oceny dopuszczalności informacji.
Przejdź do interaktywnego przykładu ↓
Spis treści
Wyrażenie regularne opisuje wzorzec tekstu. Silnik to program interpretujący ten wzorzec, a flagi zmieniają wybrane reguły, np. rozróżnianie wielkich i małych liter. Poprawność zależy także od silnika, flag i wywołanej metody. Znalezienie fragmentu jest innym zadaniem niż sprawdzenie całego wejścia.
Jeden poprawny przykład nie potwierdza właściwych granic dopasowania ani akceptowalnego czasu pracy. Poniższe przykłady dotyczą JavaScriptu, chyba że wskazano inny język.
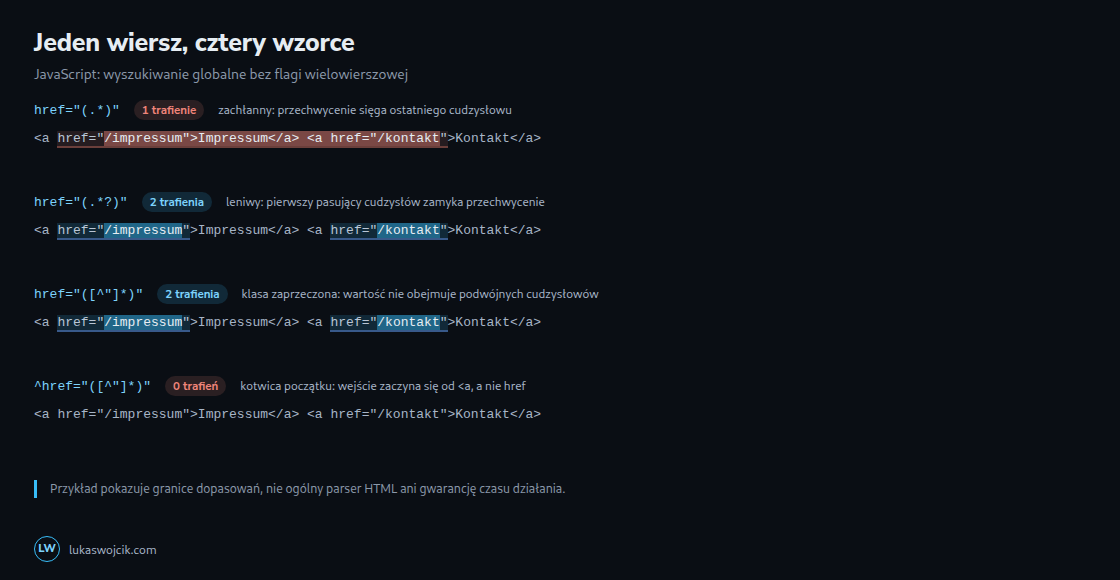
Zachłanność dotyczy kwantyfikatora
Kwantyfikator określa, ile razy może wystąpić część wzorca. Zachłanne powtórzenie najpierw próbuje objąć jak najwięcej pasującego tekstu, a leniwe zaczyna od jak najmniejszej ilości. Oba mogą zmienić ten wybór, aby dopasować resztę wzorca.
Kropka . dopasowuje znak, a * zachłannie powtarza dopasowanie. W JavaScripcie kropka pomija separatory wierszy bez flagi dotAll s. Dosłowną kropkę oznacza \.. Przy dwóch odnośnikach w podwójnych cudzysłowach href="(.*)" może przechwycić tekst od pierwszego otwierającego do ostatniego zamykającego cudzysłowu, razem ze znacznikami pomiędzy nimi.
href="(.*?)" najpierw próbuje krótszych przechwyceń. href="([^"]*)" jawnie wyklucza podwójny cudzysłów z wartości. W pokazanym wejściu oba wzorce dają po dwa dopasowania, jeśli metoda wyszukuje wszystkie wystąpienia. Żaden nie zastępuje parsera HTML: inne cudzysłowy, encje i struktura dokumentu wymagają odpowiedniego parsera.
Klasa zaprzeczona nie gwarantuje ogólnie braku nawrotów. Na przykład [^,]+a może oddać wcześniej pochłonięty znak, aby dopasować końcowe a. W przykładzie odnośników zaletą jest jawna granica na cudzysłowie.
Flaga wielowierszowa nie ogranicza klasy znaków
[^&] obejmuje znaki końca wiersza, ponieważ nie są ampersandami. Flaga m zmienia kotwice, a nie zbiór znaków pochłanianych przez klasę. Pierwszy wzorzec daje więc jedno dopasowanie przez oba wiersze. Jawne wykluczenie CR i LF daje dwa:
const text = 'utm_source=newsletter\nutm_medium=email';
const broad = [...text.matchAll(/^utm_([a-z_]+)=([^&]+)$/gm)];
const bounded = [...text.matchAll(/^utm_([a-z_]+)=([^&\r\n]+)$/gm)];
console.log(broad.length);   // 1
console.log(bounded.length); // 2
console.log(broad[0][2] === 'newsletter\nutm_medium=email'); // true
console.log(/^[0-9]+$/.test('123\n')); // false (JavaScript, no m)
console.log(/^[0-9]+$/m.test('bad\n123\nbad')); // true: one valid line
Ograniczony przykład opisuje celowo prosty format wierszy z niepustą wartością. Spacje pozostają dozwolone; [^&\s]+ wykluczałoby także spacje i pozostałe białe znaki, czyli ustalało inną regułę. Obsługa CRLF i dopuszczalnych pustych wartości wymaga osobnych testów. Rzeczywiste parametry URL lepiej odczytywać parserem URL i URLSearchParams, z uwzględnieniem dekodowania oraz powtarzających się kluczy.
Walidacja wymaga sprawdzenia całego wejścia
Wyszukanie [0-9]+ powiedzie się wewnątrz abc123def. JavaScriptowe /^[0-9]+$/ bez m ogranicza całą wartość do cyfr ASCII. Dodanie m pozwala znaleźć poprawny wiersz w niepoprawnym wejściu. Alternatywy wymagają też grupowania: ^(?:yes|no)$ stosuje obie kotwice do obu wariantów.
Kotwice sprawdzają pozycję, np. początek lub koniec wejścia, bez pochłaniania znaku. Reguły kotwic zależą od języka. Pythonowe $ dopasowuje także pozycję przed końcowym znakiem nowego wiersza; re.fullmatch(r"[0-9]+", value) jawnie sprawdza cały tekst. PCRE2/PHP pozwala użyć \A[0-9]+\z. W Ruby ^ i $ zawsze są kotwicami wierszy; granice całego wejścia oznaczają \A i \z. Ruby używa flagi m do dotAll, inaczej niż JavaScript.
Niejednoznaczne powtórzenia mogą wymagać nadmiernej pracy
Nawrót oznacza powrót do wcześniejszej decyzji i próbę innego wyboru, gdy reszta wzorca nie pasuje. W ten sposób silnik może sprawdzać wiele podziałów tego samego tekstu. ^(a+)+$ wobec ciągu liter a zakończonego ! to typowa ryzykowna konstrukcja. Usunięcie zbędnego zewnętrznego powtórzenia daje ^a+$ z tym samym zbiorem poprawnych wejść. Czas zależy od silnika, optymalizacji, danych i limitów; nie istnieje uniwersalny próg trzydziestu znaków.
Samo zagnieżdżenie nie dowodzi wykładniczego czasu i nie jest jedyną przyczyną powolnego wyszukiwania. Wyszukiwanie niezakotwiczonego a+$ może próbować wielu pozycji początkowych w długim niepasującym tekście. Usunięcie zagnieżdżenia nie uzasadnia zatem ogólnej obietnicy liniowości. Znaczenie mają też nakładające się alternatywy i kosztowna nieudana gałąź przed udaną.
Wzorce takie jak (.*,)*$ dopuszczają zero powtórzeń i podczas wyszukiwania mogą zwrócić puste dopasowanie na końcu. Podział na zawsze szybkie dopasowania i wyłącznie powolne całkowite niepowodzenia pomija ten przypadek. Leniwy kwantyfikator zmienia kolejność prób, ale nie usuwa ogólnie niejednoznacznych podziałów.
Testy i limity są częścią projektu
Przydatne przypadki obejmują poprawne dane, dwa wystąpienia, błędne prefiksy i sufiksy, puste wejście, CR/LF, cyfry Unicode, brakujące delimitery i długie teksty prawie zgodne ze wzorcem. Oczekiwany wynik powinien obejmować wartości grup oraz pozycje dopasowań, nie tylko wartość logiczną. Trzy przykłady są początkiem, a nie dowodem kompletności.
Potencjalnie kosztowne wzorce wymagają izolowanych testów z początkowo krótkimi danymi i ścisłym zewnętrznym limitem czasu lub obsługiwanym timeoutem silnika. Przydatne pozostają limity długości wejścia i wielkości wzorca. Przekroczenie czasu jest błędem do obsłużenia, a nie dowodem niepoprawności tekstu.
Pytania i odpowiedzi
Czy grupy atomowe lub kwantyfikatory zaborcze rozwiązują każdy problem?
Nie. Obsługa zależy od silnika; Python dodał obie funkcje w 3.11. Zablokowanie nawrotów może zmienić akceptowane wejścia: zachłanny zaborczy fragment może pochłonąć znaki potrzebne następnemu elementowi. Równoważność wymaga testów.
Co gwarantuje silnik liniowy?
RE2 i Go regexp dokumentują liniowe dopasowywanie względem długości wejścia przy stałym wzorcu. Rust regex podaje O(m × n) dla pojedynczego wyszukiwania, gdzie m oznacza wielkość wzorca, a n długość wejścia; iteratory po wielu dopasowaniach mogą mieć koszt kwadratowy względem n. Znaczenie nadal mają nieobsługiwane funkcje, kompilacja, limity rozmiaru i wybrana metoda. Biblioteki te nie obsługują dowolnych odwołań wstecznych ani lookaround.
Czy \d zawsze oznacza cyfry ASCII?
W JavaScripcie \d dopasowuje 0–9. Wzorce tekstowe Pythona i domyślne zachowanie .NET obejmują także cyfry dziesiętne Unicode; flaga ASCII w Pythonie i opcja ECMAScript w .NET zmieniają odpowiednie reguły. [0-9] jednoznacznie określa wymaganie cyfr ASCII.
Zrozum przez eksperyment
Które nazwy przepuszcza Twój regex?
Szukamy dokładnie error.log. Dodaj kotwice i potraktuj kropkę dosłownie: które niepożądane nazwy przestaną pasować?
Stałe, jednowierszowe przykłady JavaScript bez flag. Kropka pasuje do dowolnego znaku poza znakami końca wiersza; \. oznacza dosłowną kropkę. Bez własnych wzorców oraz testowania wydajności lub bezpieczeństwa regexu.
Ten moduł działa w przeglądarce i nie wysyła ani nie zapisuje wpisanych danych.
Zrozum przez eksperyment
Jedna minuta: znajdziesz błąd?
Dlaczego ^error.log$ pasuje również do errorXlog?
^ i $ określają pozycję dopasowania, ale nie zmieniają znaczenia kropki. Dopiero ^error\.log$ wymaga w tym przykładzie dosłownej kropki.
Kod krok po kroku
Odkrywaj
Kod krok po kroku
Jedna ustalona funkcja JavaScript, pięć kroków. Wybierz nazwę i zobacz, kiedy każda zmienna otrzymuje wartość.
function validate() {}
inputpatternmatchvalidreturn
Stałe, jednowierszowe przykłady JavaScript bez flag. Nie edytujesz dowolnego wykonywalnego kodu. Inne odmiany regexu i wejście wielowierszowe nie są częścią ćwiczenia.
Przeczytaj powiązany artykuł →
PNG z ustawieniami, wynikiem i adresem artykułu. Powstaje lokalnie dopiero po kliknięciu.
Ćwiczenia obliczają wyniki w przeglądarce. Moduł nauki nie wysyła Twoich odpowiedzi.
Powiązane artykuły


