English
 Deutsch
 Polski
Porównanie kosztów modeli AI: API w chmurze czy lokalne DeepSeek i Qwen?

Spis treści
Najniższa cena tokenów nie oznacza automatycznie najtańszego zakończonego zadania. Powtórzenia, budżet rozumowania, narzędzia i poprawki zmieniają rachunek. Porównanie z 6 października 2026 zestawia aktualne taryfy API z oddzielną oceną lokalnych wariantów DeepSeek i Qwen.
Przejrzyste porównanie taryf
Przykład zakłada łącznie milion niebuforowanych tokenów wejściowych i 200.000 rozliczanych tokenów wyjściowych, rozłożonych na krótkie pojedyncze żądania. Rozliczane wyjście musi zawierać tokeny rozumowania. Kwoty dotyczą USD bez podatków, narzędzi, cache, batch i rabatów specjalnych. Dla OpenAI obowiązuje standardowa kolumna krótkiego kontekstu. [10]
| Model | Wejście / wyjście na milion | Suma przykładowa |
|---|---|---|
| GPT-6 Astra | 10 / 50 USD | 20 USD |
| GPT-6.1 Sol | 2 / 10 USD | 4 USD |
| Claude Opus 5.5 | 4 / 20 USD | 8 USD |
| Claude Sonnet 5.5 | 2 / 10 USD | 4 USD |
| Gemini 3.8 Flash | 0,75 / 3,75 USD | 1,50 USD |
| DeepSeek V4.1 Flash, peak | 0,30 / 1,20 USD | 0,54 USD |
| DeepSeek V4.1 Flash, off-peak | 0,15 / 0,60 USD | 0,27 USD |
Stawki Claude pochodzą z przeglądu modeli. Podana standardowa taryfa Google obowiązuje według cennika do końca 2026. DeepSeek rozróżnia peak i off-peak; rzeczywiste użycie wymaga właściwego okresu rozliczeniowego. Rachunek porównuje jednakowe ilości tokenów, bez jednakowej jakości ani zmierzonej szybkości. [3, 11, 13]
Brak wspólnej taryfy otwartych wag
Lokalny model Qwen nie ma stałej ceny tokenów API. Rachunek obejmuje udział zakupu sprzętu, energię, utrzymanie i ewentualne przestoje. Wagi DeepSeek też są dostępne, lecz pełny model może wymagać innej klasy infrastruktury. Niewielka liczba aktywnych parametrów nie zmienia pobranego modelu MoE w mały model komputerowy. [7, 8]
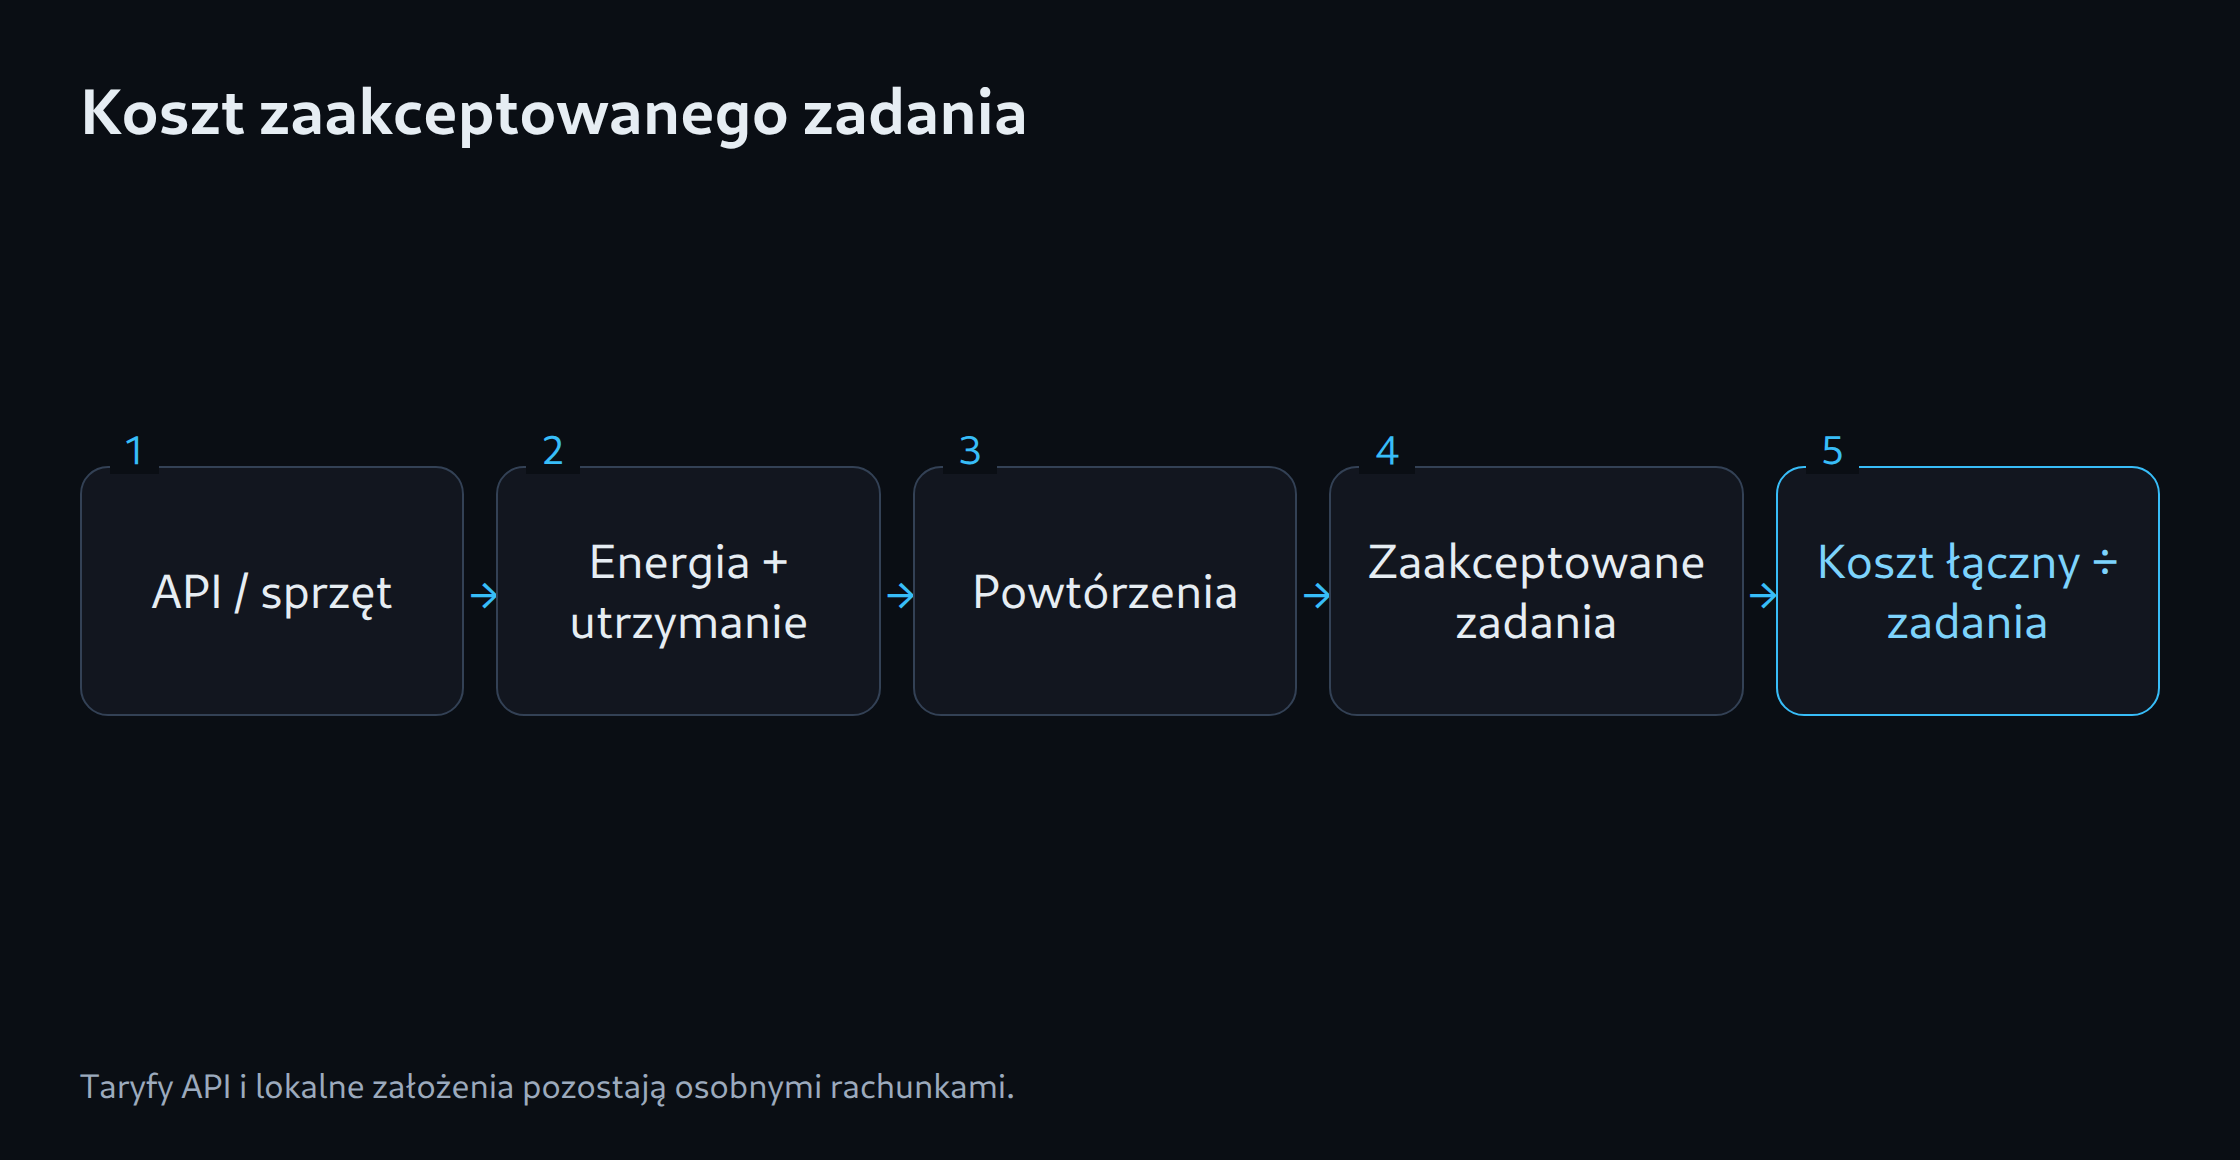
Jawnie założony przykład przyjmuje 50 euro miesięcznego udziału sprzętu, 20 euro energii i 30 euro pracy utrzymaniowej. Przy 1.000 zaakceptowanych zadaniach powstaje koszt 0,10 euro za zadanie. Bez wspólnych warunków jakości i zadań ta kwota nie jest bezpośrednio porównywalna z tabelą taryf USD.
Jakość w rachunku
Wskaźnik to koszt całkowity podzielony przez zaakceptowane zadania. Błędne odpowiedzi zwiększają liczbę powtórzeń i czas korekty. Droższy kandydat może w rezultacie okazać się bardziej opłacalny. Mniejszy lokalny checkpoint może natomiast wystarczyć do prostych częstych zadań. To hipoteza eksploatacyjna do sprawdzenia, bez zmierzonego rankingu opłacalności.
Eksploatacja mieszana
Pilotaż może obsługiwać rutynowe zadania lokalnie i kierować określone trudne przypadki do API w chmurze. Routing należy do protokołu. Funkcje chmurowe Ollama dodatkowo pokazują potrzebę osobnego sprawdzania nazwy środowiska i miejsca danych. [9]
Istniejący kalkulator kosztów obsługuje założenia lokalne, a rejestr testów modeli zapisuje akceptację i błędy. Wspólnie zapewniają weryfikowalną decyzję. Taryfy i wersje modeli wymagają ponownej kontroli przed późniejszą publikacją.
Powiązane narzędzia
Pytania i odpowiedzi
Czy przykładowe sumy są cenami miesięcznych abonamentów?
Sumy opisują założone ilości tokenów API przy podanych warunkach taryfowych. Subskrypcje czatowe i eksploatacja lokalna mają odrębne rachunki.
Kiedy model lokalny jest tańszy?
Decydują wykorzystanie, udział sprzętu, energia, utrzymanie i zaakceptowane wyniki. Sama niska cena energii nie wystarcza.
Źródła
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
- Google: Gemini API pricing
Źródła sprawdzone: 6 października 2026.
Powiązane artykuły