English
 Deutsch
 Polski
Progi danych w GA4: czym różnią się od próbkowania i jak odzyskać wiersze

Spis treści
Brak wiersza w raporcie GA4 może mieć kilka przyczyn. Progi prywatności, próbkowanie, wiersz (other) i obcięty zakres dat opisują różne ograniczenia. Przed zmianą zbierania danych lub konfiguracji kampanii potrzebne jest rozpoznanie mechanizmu dotyczącego konkretnej odpowiedzi.
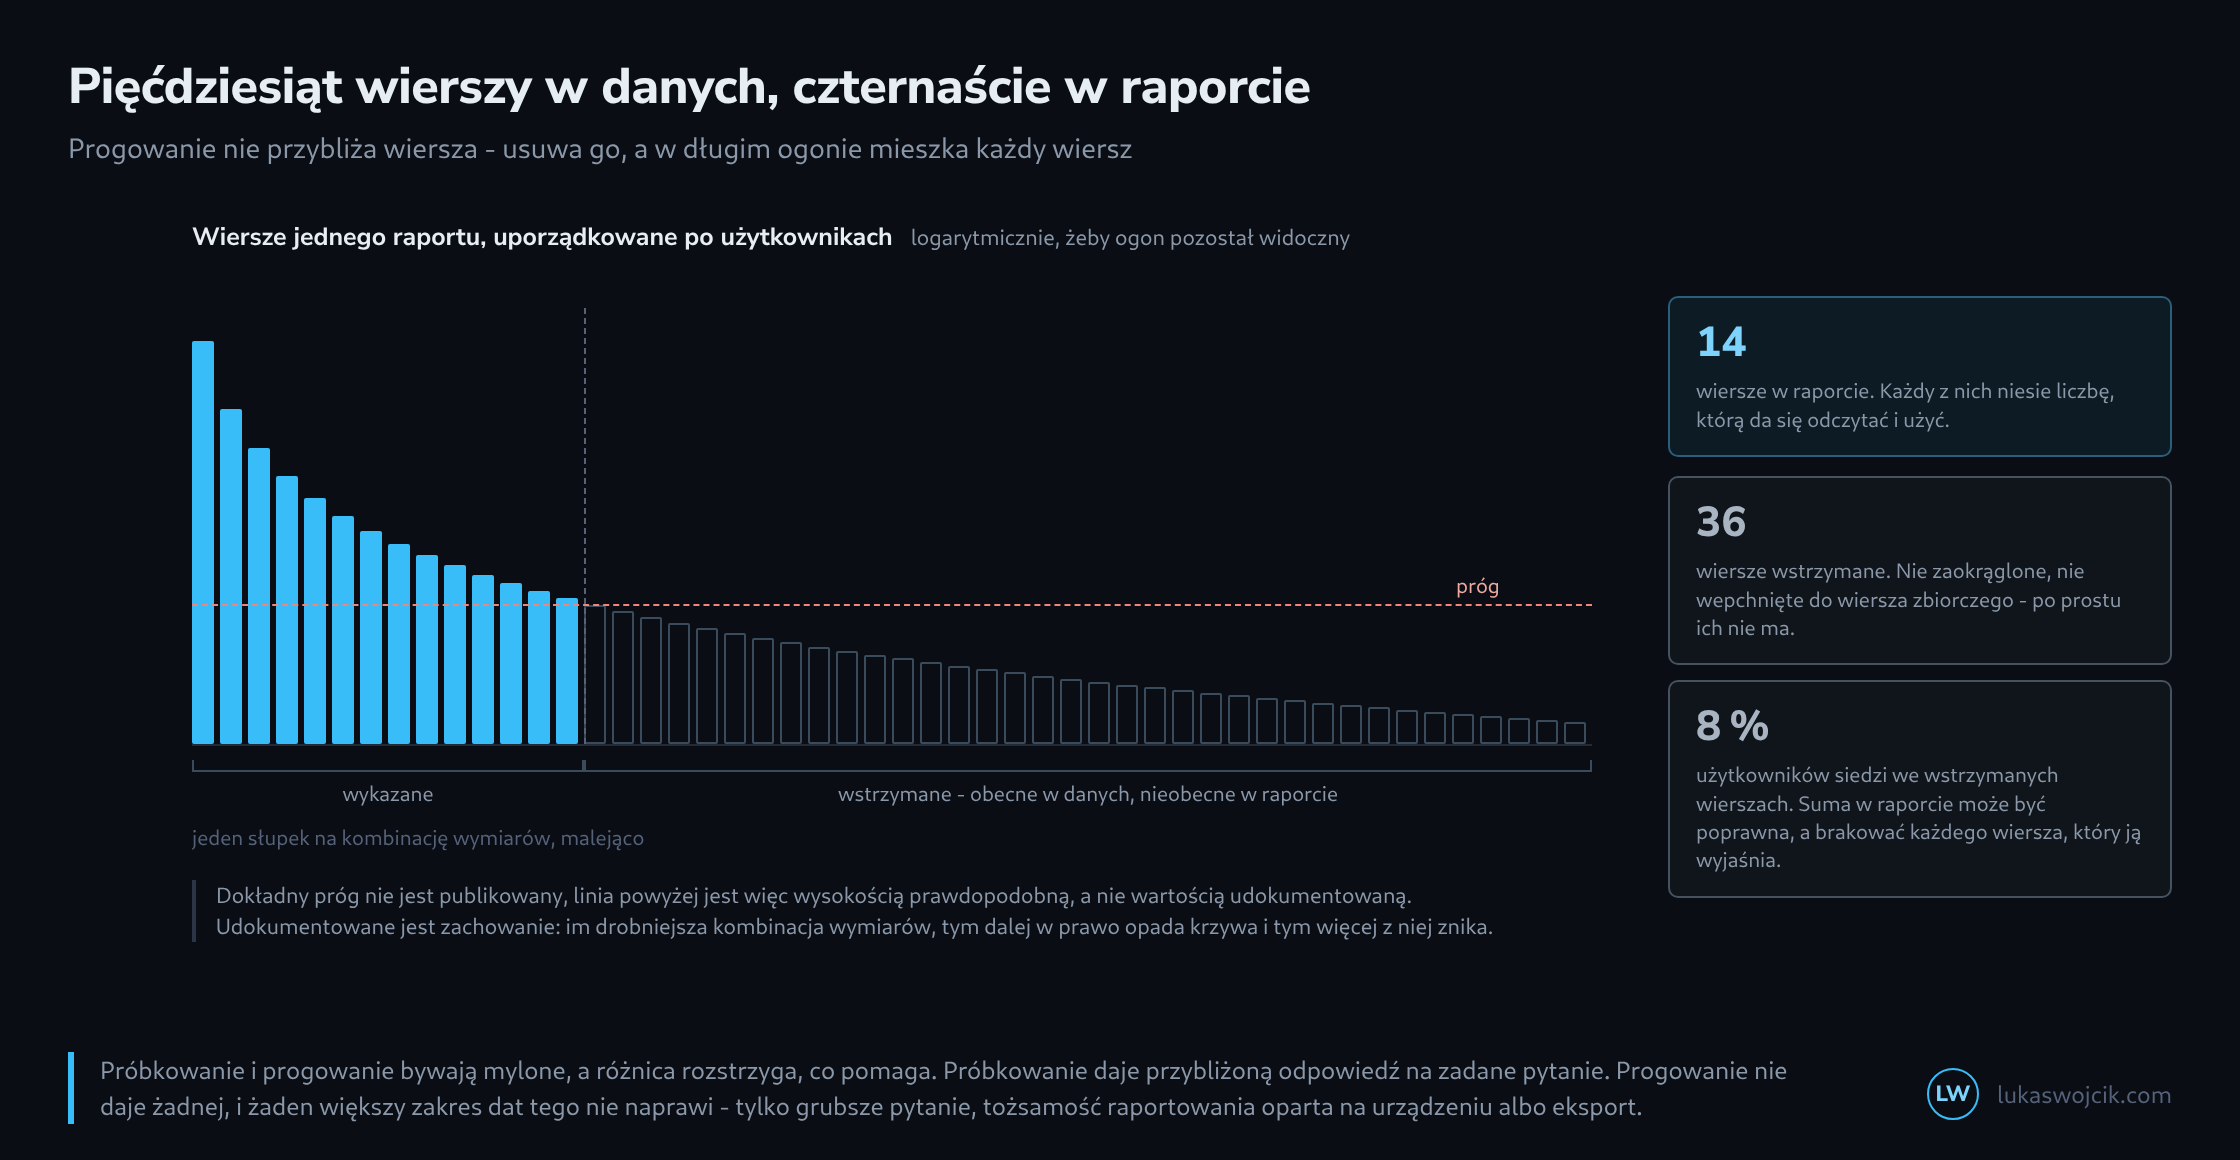
Poniższy diagram jest uproszczoną ilustracją ukrywania wierszy. Pięćdziesiąt kombinacji i czternaście widocznych wierszy to liczby fikcyjne. Nie przedstawiają opublikowanego progu Google ani pomiaru z usługi klienta.
Co chronią progi prywatności
Google stosuje progi ustalane przez system, aby ograniczać możliwość identyfikacji osób i wnioskowania o informacjach wrażliwych. Udokumentowane przypadki obejmują dane demograficzne, grupy odbiorców zdefiniowane na ich podstawie oraz informacje o wyszukiwanych hasłach. Mały raport nie jest automatycznie objęty ograniczeniem. Sam szczegółowy podział również nie dowodzi przyczyny braku wiersza. Lepszym punktem wyjścia są wskaźnik jakości raportu i metadane odpowiedzi. [1]
Cztery mechanizmy i różne pytania
- Progi: czy raport podlega minimalnym wymaganiom agregacji?
- Próbkowanie: czy obliczenia oparto na części zdarzeń?
- Kardynalność: czy kombinacje wymiarów połączono w
(other)? - Obcięcie: czy część żądanych danych, na przykład dla danego okresu, była niedostępna?
Warunki mogą występować jednocześnie. Dłuższy okres może pomóc w jednej analizie, a zarazem zmienić zakres drugiej. Pojedyncza etykieta „brak danych” ukrywałaby te różnice.
Wrześniowa zmiana API: przyczyny obcięcia
Metadane Data API zawierają teraz dataTruncationReasons. Wpis może przekazywać typ, wyjaśnienie i daty objęte ograniczeniem. Takie informacje są bardziej przydatne niż zgadywanie, która część długiego okresu raportowego pozostaje dostępna. Odpowiedź zawiera także liczniki próbkowania i aktywne ograniczenia dotyczące metryk. [2]
{
  "metadata": {
    "subjectToThresholding": true,
    "dataTruncationReasons": [{
      "dataTruncationType": "DATA_TRUNCATION_TYPE_DATE_RANGE",
      "dataTruncationMessage": "Synthetic example"
    }]
  }
}
Ten celowo krótki przykład przedstawia strukturę, a nie wynik rzeczywistego zapytania. Ważna różnica: subjectToThresholding: true nie dowodzi ukrycia wierszy. Wszystkie wiersze mogą spełniać próg. Natomiast dataLossFromOtherRow może mieć wartość true nawet wtedy, gdy filtr usuwa sam wiersz (other) z wyniku. [2]
Powtarzalna analiza
Przydatny zapis obejmuje razem żądanie, zakres dat, wymiary, filtry i odpowiedź. Następny krok to odczyt metadanych. Jeżeli zwrócono mniej wierszy niż wskazuje rowCount, konieczna jest kontrola stronicowania żądania. Sama różnica nie dowodzi próbkowania. Zapytanie porównawcze powinno zmieniać jeden istotny element naraz, aby efekt pozostał zrozumiały. [4]
Przykładowo analiza wykorzystująca dane demograficzne może zostać porównana z dłuższym okresem albo raportem bez wrażliwego wymiaru. Porównanie odpowiada wtedy na zmienione pytanie i wymaga takiego opisu. Zmiana tożsamości na potrzeby raportowania nie jest uniwersalną metodą usuwania wszystkich progów prywatności.
BigQuery udostępnia inny zbiór danych
Eksport pozwala analizować surowe zdarzenia, ale nie odtwarza wszystkich wzbogaceń dostępnych w raportach GA4. Dane Google Signals nie są eksportowane. Występują również ograniczenia dostępności, konfiguracji i przetwarzania; przesyłanie strumieniowe nie gwarantuje kompletności. Zapewnienie, że każde zdarzenie ze wszystkimi polami jest zawsze dostępne, byłoby więc zbyt szerokie. Różnice między interfejsem a wynikiem SQL wymagają porównania definicji i rzeczywiście dostępnych danych. [1, 3]
Inspektor odpowiedzi jako pomoc
Powiązany inspektor oddziela ustalenia dotyczące metadanych od limitów API. Zużycie limitu opisuje budżet zapytań, a nie kompletność raportu. Brak obiektu limitu nie oznacza zera; brak metadanych nie oznacza braku problemów. Narzędzie lokalnie interpretuje wklejony JSON. Nie sprawdza usługi ani poprawności zbierania jej zdarzeń.
Inspektor odpowiedzi API GA4 · Kontroler progów danych i modelowania behawioralnego GA4
Pytania i odpowiedzi
Dlaczego dłuższy okres może znieść próg, a zarazem stworzyć nowe problemy?
Dłuższy okres gromadzi w każdym wierszu więcej użytkowników, więc więcej wierszy spełnia minimalne wymagania agregacji. Ten sam krok zmienia jednak trzy inne rzeczy:
- Kardynalność: w ciągu większej liczby dni zbiera się więcej różnych wartości wymiaru, na przykład ścieżek stron lub nazw kampanii. Rośnie przez to prawdopodobieństwo, że rzadkie kombinacje zostaną połączone w (other).
- Próbkowanie: Explorations, czyli swobodnie konfigurowane analizy w GA4, opierają się w usłudze standardowej na próbie, gdy zapytanie przekracza limit zdarzeń. Dłuższy okres obejmuje więcej zdarzeń i szybciej przekracza tę granicę.
- Obcięcie: jeśli okres takiej analizy sięga dalej wstecz niż ustawiony czas przechowywania danych o zdarzeniach, brakuje w niej starszych dni.
Dochodzi do tego strona merytoryczna, na którą zwraca uwagę artykuł: kwartał zamiast tygodnia odpowiada na inne pytanie. Zapytanie porównawcze, które zmienia wyłącznie zakres dat, pokazuje więc w metadanych, który mechanizm zadziałał.
Czy pomaga przełączenie tożsamości na potrzeby raportowania na „Device-based”?
W części przypadków. Progów związanych z Google Signals często da się uniknąć przy tożsamości „Device-based”, która opiera się wyłącznie na identyfikatorze urządzenia; w pozostałych udokumentowanych przypadkach nie jest to pewne. Poza tym użytkownicy są potem liczeni inaczej, więc liczba sprzed zmiany i po niej odpowiada na inne pytanie.
Powiązane artykuły