English
 Deutsch
 Polski
Mac Studio M5 jako lokalna stacja AI: porównanie M5 Max, M5 Ultra i Maca mini M6

Management Summary
Mac Studio i Mac mini mogą służyć jako własne stanowiska dla modeli językowych, czyli systemów AI przetwarzających tekst i tworzących odpowiedzi. Artykuł omawia przydatność tych komputerów do takich zadań. Wspólna pamięć obsługuje również inne programy i nie jest w całości dostępna dla AI. Liczy się więc praca możliwa do wykonania na danej konfiguracji. Większa pamięć poszerza możliwości, lecz przy wyborze nadal ważne są szybkość, pobór prądu i hałas.
Spis treści
Mac Studio może uruchamiać duże modele językowe bezpośrednio na lokalnym komputerze. Kluczowe są odpowiednia ilość pamięci i program obsługujący sprzęt Apple. Wymienna karta graficzna, znana z wielu komputerów tower, nie jest częścią tej konstrukcji.
25 października 2026 r. Apple podaje Maca Studio z M5 Max lub M5 Ultra oraz Maca mini z M6 lub M5 Pro. Tabela obejmuje trzy wybrane warianty, a nie całą ofertę Maców. Liczby pochodzą ze specyfikacji; własne pomiary szybkości odpowiedzi nie są dostępne.
Trzy profile Apple
| Urządzenie | Pamięć zunifikowana | Udokumentowana przepustowość |
|---|---|---|
| Mac mini M6 | 16–32 GB | 153 lub 170 GB/s |
| Mac Studio M5 Max | 36–128 GB | 460 lub 614 GB/s |
| Mac Studio M5 Ultra | 96–512 GB | 1,2 TB/s |
Pojemność zależy od zamówionej konfiguracji. Apple podaje 128 GB dla M5 Max w wariancie z 40 rdzeniami GPU, a 512 GB dla M5 Ultra wymaga wariantu z 80 rdzeniami GPU. Mac mini M6 ma niższy limit pamięci mimo wyższego numeru generacji. Przepustowość określa możliwy transfer danych na sekundę, a nie szybkość gotowych odpowiedzi.
Pamięć zunifikowana to wspólny budżet
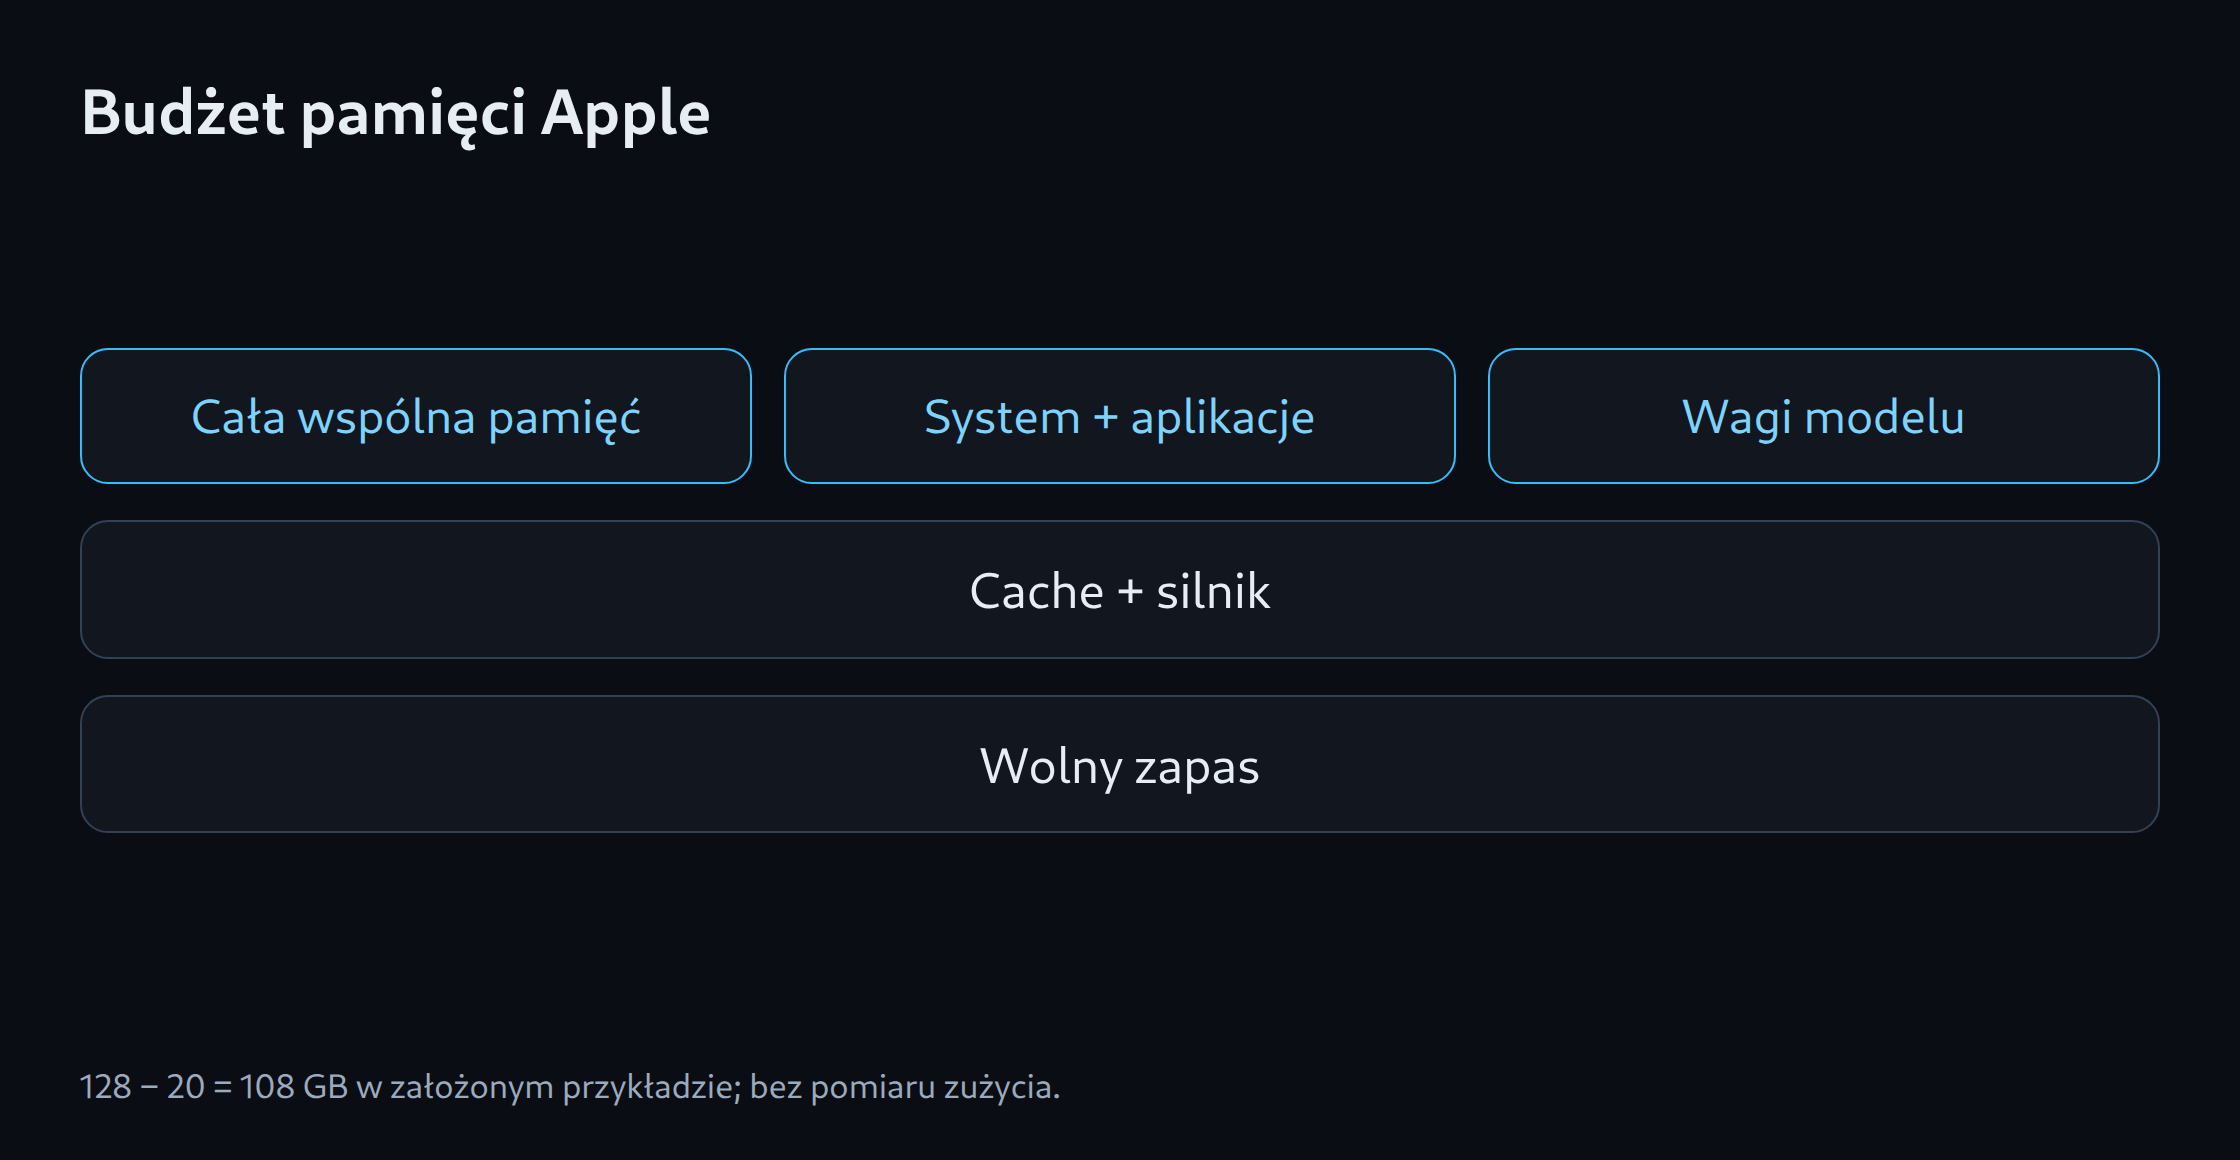
Pamięć zunifikowana oznacza wspólną pamięć roboczą. Korzystają z niej procesor główny i graficzny; miejsce zajmują także system i inne programy. Wagi modelu, czyli zapisane wartości liczbowe modelu, to tylko część potrzeb. Pamięci wymagają też wyniki pośrednie i tymczasowy obszar pracy. Łączne 512 GB nie oznacza więc 512 GB swobodnego miejsca na model.
Przykład zakłada rezerwę 20 GB ze 128 GB na system i inne aplikacje. Rachunkowo pozostaje 108 GB na model i program wykonujący obliczenia. Wartość 20 GB jest umownym założeniem, a nie minimum Apple. Pozostałe 108 GB również nie jest gwarantowanym przydziałem dla GPU: macOS i aplikacja mogą narzucać dodatkowe ograniczenia. Stała usługa wymaga pomiaru przy typowych wejściach i innych uruchomionych programach.
MLX, llama.cpp i Ollama
MLX LM generuje tekst przy użyciu modeli dla Apple Silicon. llama.cpp może korzystać z GPU przez interfejs Metal; Ollama także dokumentuje obsługę Metal. Podlinkowany artykuł Ollama o MLX opisuje konkretną wersję testową z określonym modelem i wymaga więcej niż 32 GB pamięci. Nie jest to obietnica obsługi każdego modelu Ollama ani późniejszej wersji.
Plik modelu dla MLX i plik GGUF dla llama.cpp nie są po prostu zamienne. Uczciwe porównanie zaczyna się od tej samej pierwotnej wersji modelu. Kwantyzacja zapisuje wartości z mniejszą dokładnością, aby ograniczyć zajęte miejsce; to ustawienie również wymaga zapisania. Szablon czatu określa sposób połączenia instrukcji systemowych i wiadomości dla modelu. Różnice mogą zmieniać odpowiedzi nawet na identycznym sprzęcie.
Neural Engine i przyspieszenie GPU
Apple odróżnia Neural Accelerators wewnątrz GPU od osobnego Neural Engine. Program korzysta z takich jednostek obliczeniowych tylko przy odpowiedniej obsłudze programowej. Sama liczba rdzeni Neural Engine nie określa więc szybkości odpowiedzi dowolnego modelu językowego.
Test czatu mierzy czas od wysłania do pierwszego fragmentu odpowiedzi osobno od dalszego generowania tekstu. Długie wejścia wymagają dodatkowego przetwarzania przed rozpoczęciem odpowiedzi. Usługa dla kilku osób potrzebuje także testu równoczesnych żądań. Model może mieścić się w pamięci, a mimo to działać zbyt wolno do planowanego zastosowania.
Porównanie Maca, komputera tower i DGX Spark
Komputer tower, zależnie od konstrukcji, pozwala wymieniać kartę graficzną i inne części. Zgodna karta NVIDIA umożliwia używanie programów opartych na CUDA. DGX Spark także korzysta z GPU NVIDIA, lecz ma procesor Arm; programy i kontenery muszą obsługiwać tę platformę. Mac wymaga natomiast zgodnego formatu modelu i odpowiedniej wersji programu wykonującego obliczenia.
Wybór zaczyna się zatem od konkretnego zadania i potrzebnej pamięci. Mniejszy model na mini może wystarczyć; większy model lub dłuższe wejścia mogą wymagać więcej pamięci. Hałas, pobór mocy z gniazdka i czas odpowiedzi wymagają pomiarów na planowanym urządzeniu. Podlinkowany kalkulator pomaga we wstępnym oszacowaniu. Bez sprawdzenia rzeczywistych zadań takie oszacowanie nie potwierdza trafności zakupu.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy aktualne porównanie obejmuje Maca Studio M6?
Apple obecnie dokumentuje Maca Studio z M5 Max lub M5 Ultra oraz Maca mini z M6. Plan zachowuje ten podział produktów. Późniejszy model Studio wymaga osobnych potwierdzonych danych.
Czy całe 512 GB pamięci zunifikowanej jest dostępne dla modelu LLM?
Nie. System, inne programy i model korzystają ze wspólnej pamięci. Oprócz zapisanych wartości modelu miejsce zajmują również wyniki pośrednie. Ilość pamięci dostępnej dla modelu zależy od uruchomionych programów i ograniczeń macOS.
Źródła
- Apple: Mac Studio M5 Max / M5 Ultra – dane techniczne
- Apple: Mac mini M6 i dostępność Maca Studio M5
- MLX LM: projekt
- llama.cpp: projekt i backendy
- Ollama: Hardware support
- NVIDIA: DGX Spark Hardware Overview
- Apple: Mac mini – dane techniczne
- Ollama: MLX on Apple Silicon
Źródła sprawdzone: 25 października 2026.
Powiązane artykuły