English
 Deutsch
 Polski
Q4, Q8, FP16 und langer Kontext: Warum ein lokales LLM trotz passender Dateigröße scheitert

Management Summary
Ein lokales Sprachmodell ist ein KI-System für Texte und Antworten auf dem eigenen Rechner. Es braucht nicht nur Platz für seine Dateien, sondern auch freien Speicher für die aktuelle Arbeit. Deshalb kann ein kurzer Chat funktionieren, während ein langes Dokument das Gerät überfordert. Der Artikel erklärt diesen Unterschied und die Folgen platzsparender Modellfassungen. Das hilft, Software und Rechner passend auszuwählen: Weniger Speicherbedarf kann mit veränderter Qualität oder längerer Wartezeit verbunden sein.
Inhalt
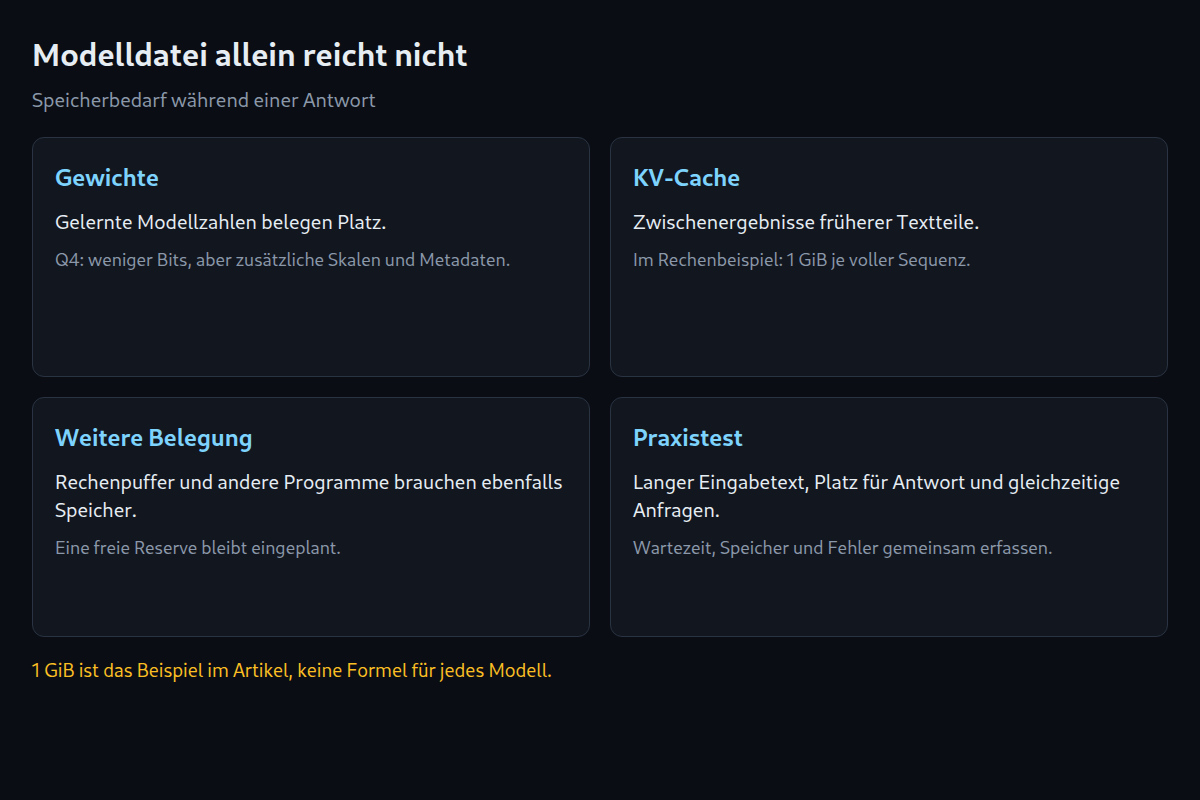
Eine Modelldatei mit 20 GB passt nicht automatisch in den Speicher einer Grafikkarte mit 24 GB. Die Datei enthält vor allem Gewichte: die beim Training erlernten Zahlen des Modells. Beim Antworten braucht die Software zusätzlich Platz für den bisherigen Text und Zwischenergebnisse. Andere Programme können ebenfalls Grafikspeicher belegen. Dateigröße und Speicherbedarf während der Ausführung sind deshalb zwei verschiedene Werte.
Quantisierung speichert Modellzahlen mit weniger Bits. Dadurch sinkt meist der Platzbedarf, möglicherweise aber auch die Qualität. Kontext bezeichnet die Eingabe und die bisher erzeugte Antwort, die das Modell berücksichtigt. Lange Dokumente und mehrere gleichzeitige Anfragen können zusätzlichen Speicher brauchen. Die folgenden Rechnungen sind Beispiele, keine Messung eines bestimmten Modells.
Q4, Q8 und FP16 beschreiben verschiedene Budgets
| Idealisiertes Beispiel | Rechnung für 30 Milliarden Gewichte | Reiner Gewichtsspeicher |
|---|---|---|
| 4 Bit | 30 Milliarden × 0,5 Byte | 15 GB |
| 8 Bit | 30 Milliarden × 1 Byte | 30 GB |
| 16 Bit | 30 Milliarden × 2 Byte | 60 GB |
Q4 und Q8 bezeichnen hier Quantisierungsverfahren mit ungefähr vier beziehungsweise acht Bit je Gewicht. FP16 speichert Zahlen in einem 16-Bit-Gleitkommaformat. Die Tabelle zeigt nur das idealisierte Gewichtspaket. Zusätzliche Skalierungswerte, unterschiedlich gespeicherte Teile und Metadaten verändern echte Dateigrößen. Außerdem ist ein GB eine Milliarde Byte, ein GiB dagegen 1.073.741.824 Byte. Die 15 GB aus der Tabelle entsprechen ungefähr 13,97 GiB.
Kontext kostet während der Ausführung
Der KV-Cache ist ein Zwischenspeicher für berechnete Schlüssel und Werte früherer Textteile. Dadurch muss das Modell bei jedem neuen Textstück nicht alles erneut berechnen. Ein Token ist ein solches Textstück, beispielsweise ein Wortteil. Für einen einfachen Cache mit gleich großen Schlüssel- und Wertvektoren gilt: 2 × Schichten × KV-Köpfe × Kopfbreite × gespeicherte Token × Byte je Wert × unabhängige Sequenzen. Schichten sind Verarbeitungsstufen; Köpfe und Kopfbreite beschreiben Anzahl und Größe der gespeicherten Zahlenreihen. Diese Werte stammen aus der Modellkonfiguration.
Beispiel: 2 × 32 Schichten × 8 KV-Köpfe × 128 Werte × 8.192 Token × 2 Byte × 1 Sequenz ergeben 1.073.741.824 Byte, also 1 GiB. Vier voneinander unabhängige, gleich volle Sequenzen benötigen in dieser Rechnung 4 GiB Cache. Die Gewichte werden dabei nicht zwangsläufig viermal geladen. Die Rechnung zählt nur Cache-Nutzdaten, keine Verwaltungsdaten oder Rechenpuffer. Manche Programme reservieren den eingestellten Maximalumfang schon beim Start; andere lassen den Cache wachsen. Geteilte Textanfänge, kleinere Zahlenformate oder ein begrenztes Aufmerksamkeitsfenster verändern den Bedarf.
Hybride Architekturen brauchen eigene Profile
Nicht jedes Modell speichert jede Verarbeitungsstufe auf diese Weise. Qwen3.5-9B kombiniert beispielsweise 24 lineare mit acht vollständigen Attention-Schichten. Die linearen Schichten führen einen anderen laufenden Zustand. Die einfache KV-Rechnung darf deshalb nicht für alle 32 Schichten verwendet werden. Auch die Bildverarbeitung benötigt eigene Gewichte und Arbeitsbereiche. Entscheidend sind die konkrete Modellkonfiguration und die eingesetzte Software.
MoE bedeutet Mixture of Experts: Bei einem Rechenschritt wird nur ein Teil mehrerer Expertengruppen verwendet. Trotzdem können die Gewichte aller Gruppen im Speicher bleiben müssen. Eine Angabe wie „aktive Parameter“ beschreibt daher nicht automatisch den Platzbedarf aller Gewichte. Das ist ein weiterer Architekturfall; Qwen3.5-9B ist kein MoE-Modell.
Auslagerung verändert das Einsatzprofil
llama.cpp kann ein Modell zwischen Hauptprozessor und Grafikkarte aufteilen. Teile bleiben dann im normalen Arbeitsspeicher, statt vollständig im Grafikspeicher zu liegen. So kann ein Modell starten, das allein nicht auf die Grafikkarte passt. Der Preis kann längeres Warten sein: CPU-Berechnung und Datenübertragung sind Teil des Ablaufs. Welche Aufteilung funktioniert, hängt auch von der unterstützten Hardware und Softwareversion ab.
Ein praktischer Test erfasst deshalb belegten Grafikspeicher, normalen Arbeitsspeicher, Wartezeit bis zum ersten ausgegebenen Token und die danach erzeugten Token pro Sekunde. Zur Prüfung gehören der geplante lange Eingabetext, Platz für die Antwort und die erwartete Zahl gleichzeitiger Anfragen. Ein kurzer erfolgreicher Chat beweist nicht, dass auch diese größere Last passt.
Qualität und Speicher gemeinsam prüfen
Ein größeres Q4-Modell ist nicht automatisch besser als ein kleineres Q8-Modell. Training und Aufgabe beeinflussen die Antworten ebenfalls. Ein kleiner Testsatz kann beispielsweise drei Fragen zu einem Dokument und die erwarteten Fundstellen enthalten. Der Vergleich zählt falsche Angaben, Auslassungen und unbrauchbare Ausgabeformate. Neue, bisher unbenutzte Fälle helfen zu prüfen, ob ein Ergebnis über den ersten Test hinaus trägt.
Der verlinkte Speicherrechner kann die erste Auswahl unterstützen. Für eine nachvollziehbare Planung werden Modellrevision, Zahlenformat, Ausführungssoftware, geplanter Kontext, gleichzeitige Anfragen und freier Speicher dokumentiert. Fehlen passende Angaben für eine Architektur, bleibt das Ergebnis eine grobe Schätzung. Erst die tatsächliche Speichermessung unter geplanter Last und ein Qualitätstest bestätigen eine brauchbare Konfiguration.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Warum passt eine 20-GB-Modelldatei nicht immer auf eine 24-GB-GPU?
Die Datei enthält vor allem Gewichte. Beim Antworten braucht das Programm zusätzlichen Platz für den Textzustand und Zwischenergebnisse. Ein langer Text oder mehrere gleichzeitige Anfragen können deshalb den übrigen Speicher aufbrauchen.
Ist ein größeres Q4-Modell immer besser als ein kleineres Q8-Modell?
Nein. Weniger Bits sparen Platz, sagen aber allein wenig über richtige Antworten aus. Gleiche Dokumente und Fragen zeigen im Test, welches Modell weniger Fehler macht. Auch Wartezeit und tatsächlich belegter Speicher gehören zum Vergleich.
Quellen
- llama.cpp: Projekt und Hardwareunterstützung
- Qwen: Qwen3.5-9B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- vLLM: GPU installation
- Hugging Face Transformers: How caching works
- Hugging Face Transformers: Cache strategies
- Qwen3.5-9B: config.json
Quellen erneut geprüft: 25. Oktober 2026. Rechenbeispiele, keine eigenen Hardwaremessungen.
Verstehen durch Ausprobieren
Das Modell passt. Und der Kontext?
Ein fiktives 7B-Modell: Ändere Präzision und Kontextlänge. Beobachte, wie der KV-Cache das Budget aufbraucht.
- Gewichte
- KV-Cache
- Laufzeitreserve
Rechenbeispiel, keine Hardware-Zusage: 7 Mrd. Gewichte; 32 Layer, 8 KV-Heads, Head-Dimension 128, KV in FP16, Batch 1, volle Kontextbelegung; 1 GiB Laufzeitreserve. Metadaten, Architektur und Backend ändern den Bedarf.
Dieses Modul rechnet im Browser und sendet oder speichert Deine Eingaben nicht.
Begriffe zum Ausprobieren
Entdecken
Begriffe zum Ausprobieren
Eine kurze Erklärung und ein kleines Experiment machen den Begriff greifbar.
Quantisierung
Gewichte eines Modells werden mit weniger Bits dargestellt. Das spart Speicher für die Gewichte; Genauigkeit und weiterer Speicherbedarf müssen separat betrachtet werden.
Die Übungen rechnen im Browser. Deine Antworten werden vom Lernmodul nicht versendet.
Passend dazu