English
 Deutsch
 Polski
Q4, Q8, FP16 i długi kontekst: dlaczego lokalny model LLM nie działa mimo odpowiedniego rozmiaru pliku?

Management Summary
Lokalny model językowy to system AI do tekstów i odpowiedzi działający na własnym komputerze. Potrzebuje miejsca na pliki oraz wolnej pamięci na bieżącą pracę. Krótki czat może więc działać, gdy długi dokument przekracza możliwości tego samego urządzenia. Artykuł wyjaśnia tę różnicę i skutki bardziej oszczędnych wersji modeli. Pomaga to dopasować program do komputera: mniejsze wymagania pamięciowe mogą wiązać się ze zmianą jakości odpowiedzi lub dłuższym oczekiwaniem.
Przejdź do interaktywnego przykładu ↓
Spis treści
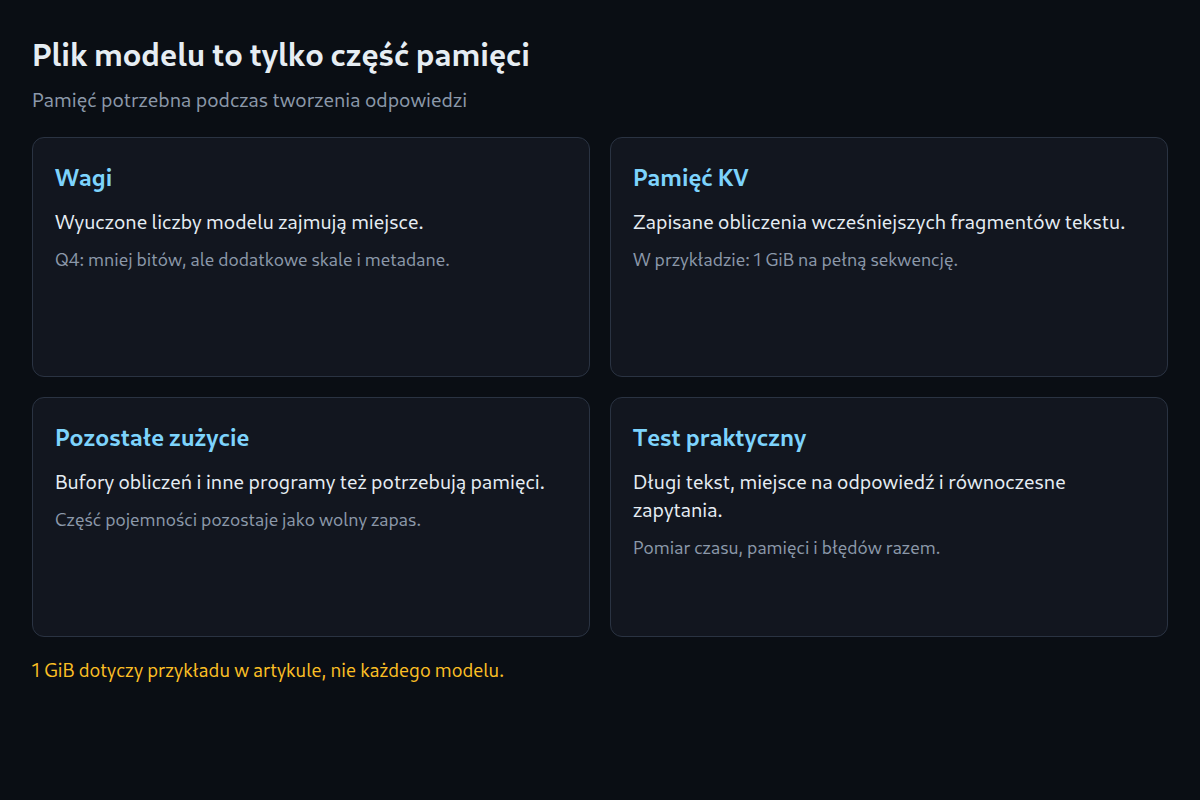
Plik modelu o rozmiarze 20 GB nie musi zmieścić się w pamięci karty graficznej o pojemności 24 GB. Plik zawiera przede wszystkim wagi, czyli liczby wyuczone podczas treningu. Podczas odpowiedzi program potrzebuje też miejsca na wcześniejszy tekst i wyniki pośrednie. Inne programy również mogą zajmować pamięć karty. Rozmiar pliku i pamięć potrzebna podczas pracy to różne wielkości.
Kwantyzacja zapisuje liczby modelu przy użyciu mniejszej liczby bitów. Zwykle oszczędza miejsce, lecz może wpływać na jakość. Kontekst obejmuje dane wejściowe i wygenerowaną odpowiedź uwzględniane przez model. Długie dokumenty i równoczesne zapytania mogą wymagać dodatkowej pamięci. Poniższe obliczenia są przykładami, a nie pomiarami konkretnego modelu.
Q4, Q8 i FP16 oznaczają różne budżety
| Przykład idealizowany | Obliczenie dla 30 miliardów wag | Same wagi |
|---|---|---|
| 4 bity | 30 miliardów × 0,5 bajta | 15 GB |
| 8 bitów | 30 miliardów × 1 bajt | 30 GB |
| 16 bitów | 30 miliardów × 2 bajty | 60 GB |
Q4 i Q8 oznaczają tutaj metody kwantyzacji wykorzystujące około czterech i ośmiu bitów na wagę. FP16 zapisuje liczby w 16-bitowym formacie zmiennoprzecinkowym. Tabela obejmuje tylko idealizowany zapis wag. Dodatkowe skale, części zapisane inaczej i metadane zmieniają rzeczywiste rozmiary plików. GB to miliard bajtów, a GiB to 1 073 741 824 bajty. Podane 15 GB odpowiada więc około 13,97 GiB.
Kontekst zajmuje pamięć podczas pracy
Pamięć KV zachowuje obliczone klucze i wartości wcześniejszego tekstu. Dzięki temu każdy nowy fragment nie wymaga powtarzania całej pracy. Token to taki fragment tekstu, na przykład część słowa. Dla prostego bufora z równymi rozmiarami wektorów kluczy i wartości wzór wynosi: 2 × warstwy × głowy KV × wymiar głowy × zapisane tokeny × bajty na wartość × niezależne sekwencje. Warstwy to etapy przetwarzania, a głowy i ich wymiar opisują liczbę i długość zapisywanych ciągów liczb. Wartości pochodzą z konfiguracji modelu.
Przykład: 2 × 32 warstwy × 8 głów KV × 128 wartości × 8192 tokeny × 2 bajty × 1 sekwencja daje 1 073 741 824 bajty, czyli 1 GiB. Cztery niezależne, jednakowo pełne sekwencje potrzebują w tym obliczeniu 4 GiB pamięci KV. Nie oznacza to koniecznie czterokrotnego załadowania wag. Wzór liczy tylko dane KV, bez danych zarządzających i buforów obliczeń. Niektóre programy rezerwują ustawione maksimum przy starcie, inne powiększają bufor w miarę potrzeb. Wspólne początki tekstu, mniejsze formaty liczb i ograniczone okno uwagi zmieniają zapotrzebowanie.
Architektury hybrydowe wymagają własnych profili
Nie każdy model zapisuje w ten sposób każdy etap. Qwen3.5-9B łączy na przykład 24 warstwy uwagi liniowej z ośmioma warstwami pełnej uwagi. Warstwy liniowe utrzymują inny stan bieżący. Prosty wzór KV nie może więc obejmować wszystkich 32 warstw. Przetwarzanie obrazu także wymaga własnych wag i obszarów roboczych. Potrzebna jest konkretna konfiguracja modelu i programu wykonującego obliczenia.
MoE oznacza Mixture of Experts: pojedynczy krok korzysta tylko z części kilku grup ekspertów. Wagi wszystkich grup nadal mogą wymagać miejsca w pamięci. Liczba aktywnych parametrów nie opisuje więc automatycznie miejsca dla wszystkich wag. To inny przypadek architektury; Qwen3.5-9B nie jest modelem MoE.
Przenoszenie danych zmienia profil pracy
llama.cpp może podzielić model między procesor i kartę graficzną. Część pozostaje wtedy w zwykłej pamięci RAM zamiast zajmować pamięć karty. Dzięki temu może uruchomić się model większy niż jej pojemność. Ceną może być dłuższe oczekiwanie, ponieważ do pracy dochodzą obliczenia procesora i przesyłanie danych. Dostępny podział zależy też od obsługi sprzętu i wersji programu.
Praktyczny test zapisuje więc zajętość pamięci karty, RAM, czas do pierwszego tokenu odpowiedzi i późniejszą liczbę tokenów generowanych na sekundę. Test obejmuje planowany długi tekst wejściowy, miejsce na odpowiedź i oczekiwaną liczbę równoczesnych zapytań. Udany krótki czat nie dowodzi, że większe obciążenie również się zmieści.
Wspólna kontrola jakości i pamięci
Większy model Q4 nie jest automatycznie lepszy od mniejszego Q8. Na odpowiedzi wpływają też trening i zadanie. Mały zestaw próbny może zawierać trzy pytania do dokumentu i oczekiwane fragmenty źródłowe. Porównanie liczy błędne informacje, pominięcia i nieprzydatne formaty odpowiedzi. Nowe, wcześniej nieużywane przypadki pomagają sprawdzić, czy wynik wykracza poza pierwszy test.
Podlinkowany kalkulator pamięci może pomóc we wstępnym wyborze. Plan opisuje rewizję modelu, format liczb, program wykonujący obliczenia, planowany kontekst, równoczesne zapytania i dostępną pamięć. Bez odpowiednich danych architektury wynik pozostaje przybliżeniem. Dopiero rzeczywisty pomiar pamięci pod planowanym obciążeniem i test jakości potwierdzają użyteczną konfigurację.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Dlaczego plik modelu o rozmiarze 20 GB nie zawsze mieści się na GPU z 24 GB?
Plik zawiera przede wszystkim wagi. Odpowiedź wymaga też pamięci na stan tekstu i wyniki pośrednie. Długie dane wejściowe lub równoczesne zapytania mogą więc wyczerpać pozostałe miejsce.
Czy większy model Q4 jest zawsze lepszy od mniejszego Q8?
Nie. Mniej bitów oszczędza miejsce, ale nie potwierdza poprawności odpowiedzi. Te same dokumenty i pytania pozwalają porównać liczbę błędów modeli. Do oceny należą też czas oczekiwania i rzeczywiste zużycie pamięci.
Źródła
- llama.cpp: projekt i obsługa sprzętu
- Qwen: oficjalna karta modelu Qwen3.5-9B
- Mistral: oficjalna karta modelu Ministral 3 14B Instruct
- vLLM: GPU installation
- Hugging Face Transformers: How caching works
- Hugging Face Transformers: Cache strategies
- Qwen3.5-9B: config.json
Źródła ponownie sprawdzone: 25 października 2026. Przykłady obliczeń, nie własne pomiary sprzętu.
Zrozum przez eksperyment
Model się mieści. A kontekst?
Hipotetyczny model 7B: zmień precyzję i długość kontekstu. Zobacz, jak pamięć KV zużywa budżet.
- Wagi
- Pamięć KV
- Rezerwa wykonawcza
Przykład, nie gwarancja sprzętowa: 7 mld wag; 32 warstwy, 8 głów KV, wymiar głowy 128, KV w FP16, batch 1, pełny kontekst; rezerwa 1 GiB. Metadane, architektura i backend zmieniają zapotrzebowanie.
Ten moduł działa w przeglądarce i nie wysyła ani nie zapisuje wpisanych danych.
Pojęcia do wypróbowania
Odkrywaj
Pojęcia do wypróbowania
Krótkie wyjaśnienie i mały eksperyment pomagają zrozumieć pojęcie.
Kwantyzacja
Wagi modelu są przedstawiane mniejszą liczbą bitów. To oszczędza pamięć wag; dokładność i pozostałe użycie pamięci trzeba rozpatrywać osobno.
Ćwiczenia obliczają wyniki w przeglądarce. Moduł nauki nie wysyła Twoich odpowiedzi.
Powiązane artykuły