English
 Deutsch
 Polski
Tutorial: Tokenverbrauch je Anfrage messen und ein Monatsbudget durchsetzen

Inhalt
Eine Rechnung für eine API kommt einmal im Monat und nennt eine Summe. Zwischen dieser Summe und dem Code, der sie erzeugt hat, steht meist gar nichts – kein Vermerk, welche Funktion was verbraucht hat, und keine Möglichkeit, eine teure Woche von einer teuren Gewohnheit zu unterscheiden.
Die Lücke lässt sich leicht schliessen, denn die Angabe steckt bereits in jeder Antwort. Die folgende Arbeit besteht aus zwanzig Zeilen Protokoll, einer Preistabelle und einer Prüfung, die vor der Anfrage läuft statt danach.
Wo die wahre Zahl längst steht
Jede Antwort einer Chat-Vervollständigung trägt einen usage-Block. Er ist keine Schätzung und keine Rundung, sondern das, was der Zähler festgehalten hat.
{
  "usage": {
    "input_tokens": 12400,
    "cache_creation_input_tokens": 8200,
    "cache_read_input_tokens": 96000,
    "output_tokens": 1850
  }
}
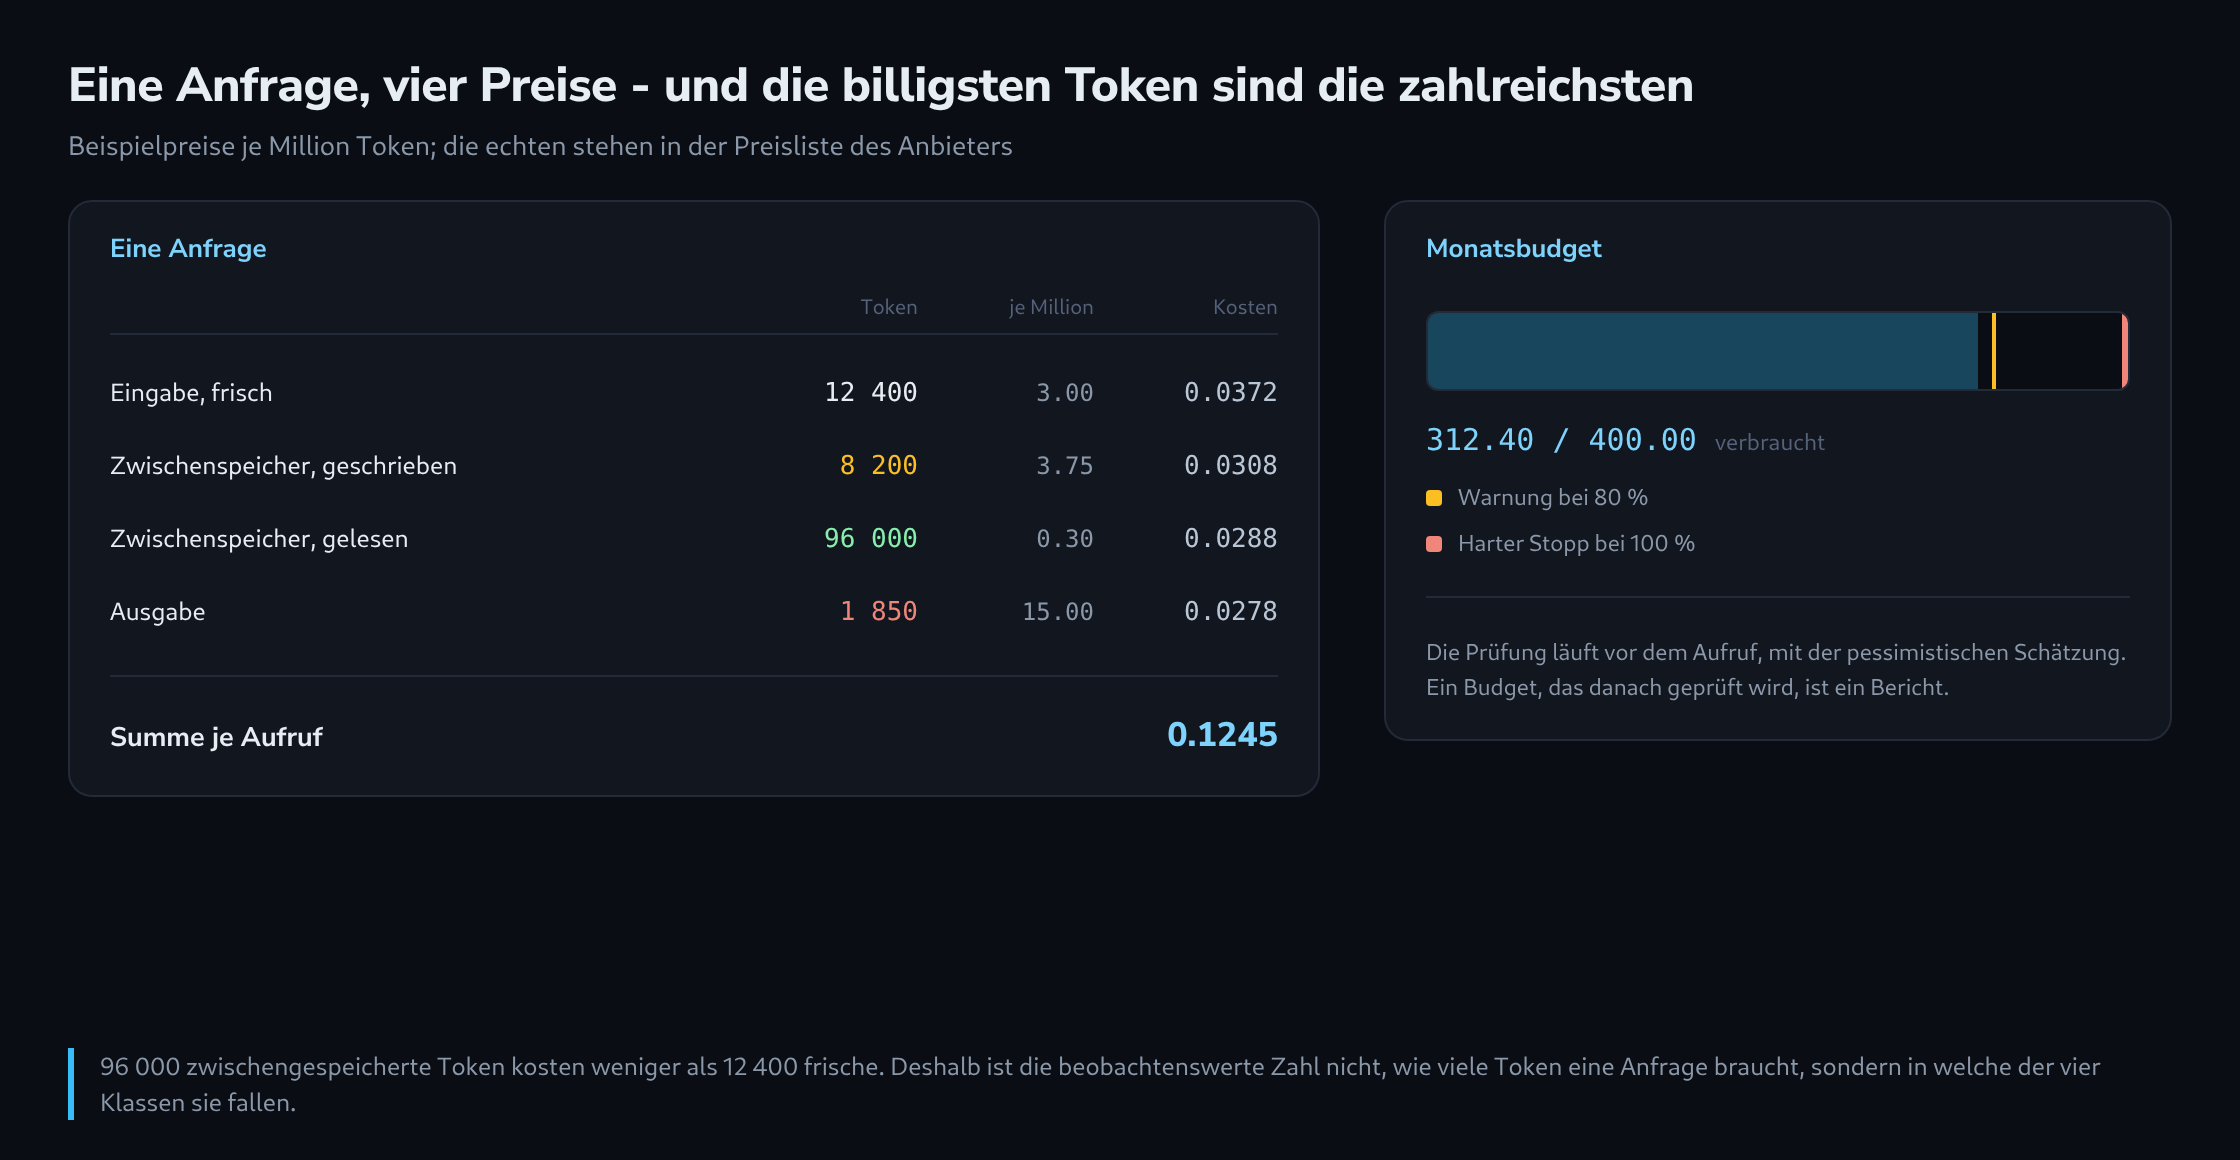
Die vier Felder sind vier verschiedene Preise, und die Aufteilung wiegt schwerer als die Summe. Frisch gesendete Eingabe ist der Grundpreis. Token, die in einen Prompt-Cache geschrieben werden, kosten einmalig einen Aufschlag. Token, die daraus wieder gelesen werden, kosten einen Bruchteil des Grundpreises. Die Ausgabe ist die teuerste Klasse überhaupt, meist ein Mehrfaches des Eingabepreises.
Andere Anbieter benennen dieselben Dinge anders – prompt_tokens, completion_tokens und ein verschachteltes cached_tokens sind die übliche Alternative -, aber der Aufbau ist derselbe und die Folgerung auch: Eine einzelne Zahl mit der Beschriftung „Token” lässt sich nicht in Geld umrechnen.
Für das Streaming gehört eine Anmerkung dazu. Der usage-Block kommt nicht mit dem ersten Stück, sondern am Ende, im Abschlussereignis des Stroms. Code, der den Text liest und den Rest verwirft, verliert also genau den Teil, der etwas kostet.
Zählen, bevor gesendet wird
Manchmal wird die Zahl gebraucht, bevor die Anfrage existiert – um zu entscheiden, ob ein Dokument noch passt oder ob ein Gespräch gekürzt werden muss. Dafür gibt es einen Zählendpunkt, der kostenlos ist und zurückgibt, was das Modell sehen würde.
curl https://api.anthropic.com/v1/messages/count_tokens \
  -H "x-api-key: $API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5",
    "messages": [{"role": "user", "content": "..." }]
  }'
Ein örtlicher Tokenizer beantwortet dieselbe Frage ohne Netzaufruf und reicht für eine Längenprüfung, aber er ist nicht der Zähler. Systemvorgaben, Werkzeugdefinitionen und Bildblöcke bringen alle Token mit, die ein Texttokenizer nie sieht, und der Unterschied geht bei einer Anfrage mit angehängten Werkzeugen in die Tausende. Für ein Budget zählt allein der usage-Block.
Eine Zeile je Anfrage
Das Protokollieren selbst ist unspektakulär, und sein Wert liegt vollständig in den Feldern, die den Zusammenhang beschreiben, nicht die Anfrage. Modell und Tokenzahlen allein beantworten nichts; eine Kennzeichnung, welche Funktion den Aufruf ausgelöst hat, beantwortet fast alles.
import json, logging, sqlite3, time, uuid

DB = sqlite3.connect("verbrauch.db")
DB.execute("""CREATE TABLE IF NOT EXISTS aufrufe (
    id TEXT PRIMARY KEY, zeit INTEGER, modell TEXT, zweck TEXT,
    ein INTEGER, cache_neu INTEGER, cache_gelesen INTEGER, aus INTEGER,
    kosten REAL, versuch INTEGER)""")

def buchen(antwort, modell, zweck, versuch=1):
    u = antwort["usage"]
    zeile = dict(
        id=str(uuid.uuid4()), zeit=int(time.time()), modell=modell, zweck=zweck,
        ein=u["input_tokens"],
        cache_neu=u.get("cache_creation_input_tokens", 0),
        cache_gelesen=u.get("cache_read_input_tokens", 0),
        aus=u["output_tokens"], versuch=versuch)
    zeile["kosten"] = kosten(modell, zeile)
    DB.execute("INSERT INTO aufrufe VALUES (:id,:zeit,:modell,:zweck,:ein,"
               ":cache_neu,:cache_gelesen,:aus,:kosten,:versuch)", zeile)
    DB.commit()
    return zeile["kosten"]
Die Spalte versuch ist die, die sich unerwartet auszahlt. Ein Wiederholungsversuch nach einer Zeitüberschreitung sendet die ganze Eingabe erneut und wird erneut berechnet, während die Anwendung einen einzigen logischen Aufruf sieht. Ohne diese Spalte verstecken sich Wiederholungen im Mittelwert, und ein schlechter Nachmittag sieht aus wie eine teure Funktion.
Aus Token Geld machen
Preise gehören an eine Stelle, je Modell und je Tokenklasse, angegeben je Million Token – denn so werden sie veröffentlicht.
# Beispielpreise je Million Token - die echten stehen in der
# Preisliste des Anbieters und ändern sich über die Zeit.
PREISE = {
    "claude-sonnet-5": {"ein": 3.00, "cache_neu": 3.75, "cache_gelesen": 0.30, "aus": 15.00},
}

def kosten(modell, z):
    p = PREISE[modell]
    return round(sum(z[k] * p[k] for k in ("ein", "cache_neu", "cache_gelesen", "aus")) / 1e6, 6)
Auf die Anfrage von oben angewandt, ergeben die vier Klassen 0,0372, 0,0308, 0,0288 und 0,0278 – zusammen 0,1245 je Aufruf. Der aufschlussreiche Vergleich ist der dritte Wert gegen den ersten: 96 000 aus dem Zwischenspeicher gelesene Token kosten weniger als 12 400 frisch gesendete. Ein Zwischenspeicher, der greift, senkt also nicht nur die Rechnung, sondern verschiebt auch, welcher Teil der Anfrage sie bestimmt.
Liegen ein paar Tage Zeilen in der Tabelle, lässt sich die eigentliche Frage mit einer Anweisung beantworten.
SELECT zweck,
       COUNT(*)                          AS aufrufe,
       ROUND(SUM(kosten), 2)             AS gesamt,
       ROUND(AVG(kosten), 4)             AS je_aufruf,
       ROUND(100.0 * SUM(cache_gelesen) /
             NULLIF(SUM(ein + cache_neu + cache_gelesen), 0), 1) AS cache_anteil
FROM aufrufe
WHERE zeit >= strftime('%s', 'now', 'start of month')
GROUP BY zweck ORDER BY gesamt DESC;
Die Sperre, die wirklich etwas aufhält
Ein Budget, das nur warnt, ist ein Bericht. Aufhalten setzt voraus, dass die Prüfung vor dem Aufruf steht – und dass die Zahl aktuell ist statt von letzter Nacht.
class BudgetErschoepft(Exception):
    pass

MONATSBUDGET = 400.0
WARNSCHWELLE = 0.80

def monatssumme():
    (s,) = DB.execute(
        "SELECT COALESCE(SUM(kosten), 0) FROM aufrufe "
        "WHERE zeit >= strftime('%s', 'now', 'start of month')").fetchone()
    return s

def pruefen(geschaetzte_kosten):
    verbraucht = monatssumme()
    if verbraucht + geschaetzte_kosten > MONATSBUDGET:
        raise BudgetErschoepft(f"{verbraucht:.2f} von {MONATSBUDGET:.2f} verbraucht")
    if verbraucht > MONATSBUDGET * WARNSCHWELLE:
        logging.warning("Budget zu %.0f %% verbraucht", 100 * verbraucht / MONATSBUDGET)
Drei Entscheidungen machen daraus mehr als eine Formalität. Die übergebene Schätzung sollte die pessimistische sein – höchstmögliche Ausgabetoken zum Ausgabepreis -, denn ein Aufruf ist entweder erlaubt oder nicht, und eine Erlaubnis auf optimistischer Grundlage ist der Weg, ein Budget um genau eine Anfrage zu überschreiten.
Die zweite betrifft das, was nach der Ausnahme geschieht. Ein Stapellauf sollte anhalten und sagen, wo er angehalten hat. Eine Funktion im Dialog sollte nachgeben statt zu scheitern: ein kleineres Modell, ein kürzerer Zusammenhang oder eine Warteschlange, die im nächsten Monat weiterläuft. Beides ist besser als ein Fehlerbericht, der bis zum Leser durchschlägt.
Die dritte: Ein geteiltes Budget braucht einen geteilten Zähler. Mehrere Prozesse mit je eigener Summe bleiben jeder für sich unter der Grenze und überschreiten sie gemeinsam. Eine einzige Tabelle mit einer Transaktion um Lesen und Schreiben, oder ein Zähler in einem gemeinsamen Speicher, ist die ganze Abhilfe.
Was die Sperre nicht sieht
Drei Arten von Ausgaben laufen nie durch die Prüfung, und jede hat ihren eigenen Weg, doch erfasst zu werden.
Die Stapelverarbeitung wird mit Rabatt berechnet und läuft oft im Hintergrund, sodass der usage-Block Stunden später mit den Ergebnissen eintrifft. Diese Kosten gehören in dieselbe Tabelle, eingetragen beim Abholen der Ergebnisse, aber mit dem Zeitpunkt der Einreichung – sonst landet die Ausgabe an einer Monatsgrenze im falschen Monat.
Fehlgeschlagene Anfragen sind der zweite Fall. Ein Aufruf, der in eine Zeitüberschreitung läuft, nachdem das Modell den grössten Teil seiner Antwort bereits erzeugt hat, wird trotzdem berechnet und liefert keinen usage-Block zum Auslesen. Was er liefert, ist eine Anfragekennung in den Antwort-Headern, und der Verbrauchsbericht des Anbieters führt sie. Ein monatlicher Abgleich zwischen der eigenen Tabelle und diesem Bericht kostet zehn Minuten und findet genau diese Klasse von Abweichung.
Der dritte Fall ist alles, was keine Chat-Vervollständigung ist: Einbettungen, Transkriptionen, Bilderzeugung, ein serverseitig aufgerufenes Suchwerkzeug. Jedes hat seinen eigenen Zähler und seinen eigenen Preis, und keines davon taucht im hier protokollierten usage-Block auf. Der Abgleich fängt auch diese ein – und das ist der praktische Grund, ihn überhaupt zu führen.
Fragen und Antworten
Hält die Budgetprüfung, wenn mehrere Anfragen gleichzeitig laufen?
Nicht in der Form aus dem Artikel. pruefen() liest die Monatssumme, buchen() schreibt die Kosten erst nach der Antwort. Dazwischen liegt die ganze Laufzeit des Aufrufs, und alle Anfragen, die in diesem Fenster geprüft werden, sehen dieselbe alte Summe. Parallele Aufrufe, deren Schätzung einzeln noch passt, kommen deshalb alle durch, auch wenn das restliche Budget nur für einen von ihnen gereicht hätte.
Abhilfe schafft eine Reservierung. Die Prüfung bucht die pessimistische Schätzung sofort als vorläufige Zeile, in derselben Transaktion, in der sie die Summe liest. Nach der Antwort ersetzt die tatsächliche Zeile aus dem usage-Block die Reservierung. Die Summe enthält dann auch die Aufrufe, die noch unterwegs sind.
Zwei Einzelheiten gehören dazu. Wird ein Aufruf abgewiesen, bevor das Modell etwas erzeugt, lässt sich die Reservierung auflösen. Bricht er dagegen nach einer Zeitüberschreitung ab, ist er nach dem Artikel womöglich trotzdem berechnet worden; dann bleibt die Reservierung besser stehen, bis der monatliche Abgleich den tatsächlichen Betrag zeigt. Und bei SQLite sorgt erst eine Schreibsperre schon vor dem Lesen, etwa mit BEGIN IMMEDIATE, dafür, dass zwei Prozesse nicht im selben Moment dieselbe Summe lesen und beide darauf reservieren.
In welcher Zeitzone beginnt der Monat in den SQL-Abfragen?
In UTC: SQLite rechnet 'now' und 'start of month' in koordinierter Weltzeit, und auch der Unix-Zeitstempel in der Spalte zeit kennt keine Zeitzone. In Deutschland beginnt der Budgetmonat damit um 1 Uhr Ortszeit, während der Sommerzeit um 2 Uhr. Rechnet der Verbrauchsbericht des Anbieters in einer anderen Zeitzone, verschieben sich beim monatlichen Abgleich die Stunden an der Monatsgrenze.
Was geschieht, wenn ein Modell aufgerufen wird, das in der Preistabelle fehlt?
Der Aufruf wird berechnet, landet aber nicht in der Tabelle. kosten() greift mit PREISE[modell] zu und löst bei einem unbekannten Namen einen KeyError aus; da buchen() die Kosten vor dem INSERT berechnet, bricht die Funktion ab, ohne eine Zeile zu schreiben. Die Monatssumme bleibt zu niedrig, und die Sperre lässt genau die Aufrufe durch, die sie nicht kennt.
Der sichere Ort für diese Prüfung liegt vor dem Aufruf. Die pessimistische Schätzung braucht ohnehin den Preis des Modells; schlägt sie für einen unbekannten Namen fehl, scheitert die Anfrage, bevor sie etwas kostet. Das betrifft vor allem den Tag, an dem ein neues Modell oder ein neuer Aliasname in Gebrauch kommt, ohne dass die Preistabelle nachgezogen wurde.
Quellen
Passend dazu