English
 Deutsch
 Polski
Tutorial: Pomiar zużycia tokenów na żądanie i egzekwowanie budżetu miesięcznego

Spis treści
Faktura za API przychodzi raz w miesiącu i podaje sumę. Między tą sumą a kodem, który ją wytworzył, zwykle nie stoi nic – żadnej notatki, która funkcja ile zużyła, i żadnej możliwości odróżnienia drogiego tygodnia od drogiego nawyku.
Lukę da się łatwo domknąć, bo informacja tkwi już w każdej odpowiedzi. Poniższa praca to dwadzieścia linii zapisu, jedna tabela cen i jedno sprawdzenie działające przed żądaniem, a nie po nim.
Gdzie prawdziwa liczba już stoi
Każda odpowiedź uzupełnienia czatu niesie blok usage. Nie jest to szacunek ani zaokrąglenie, lecz to, co zapisał licznik.
{
  "usage": {
    "input_tokens": 12400,
    "cache_creation_input_tokens": 8200,
    "cache_read_input_tokens": 96000,
    "output_tokens": 1850
  }
}
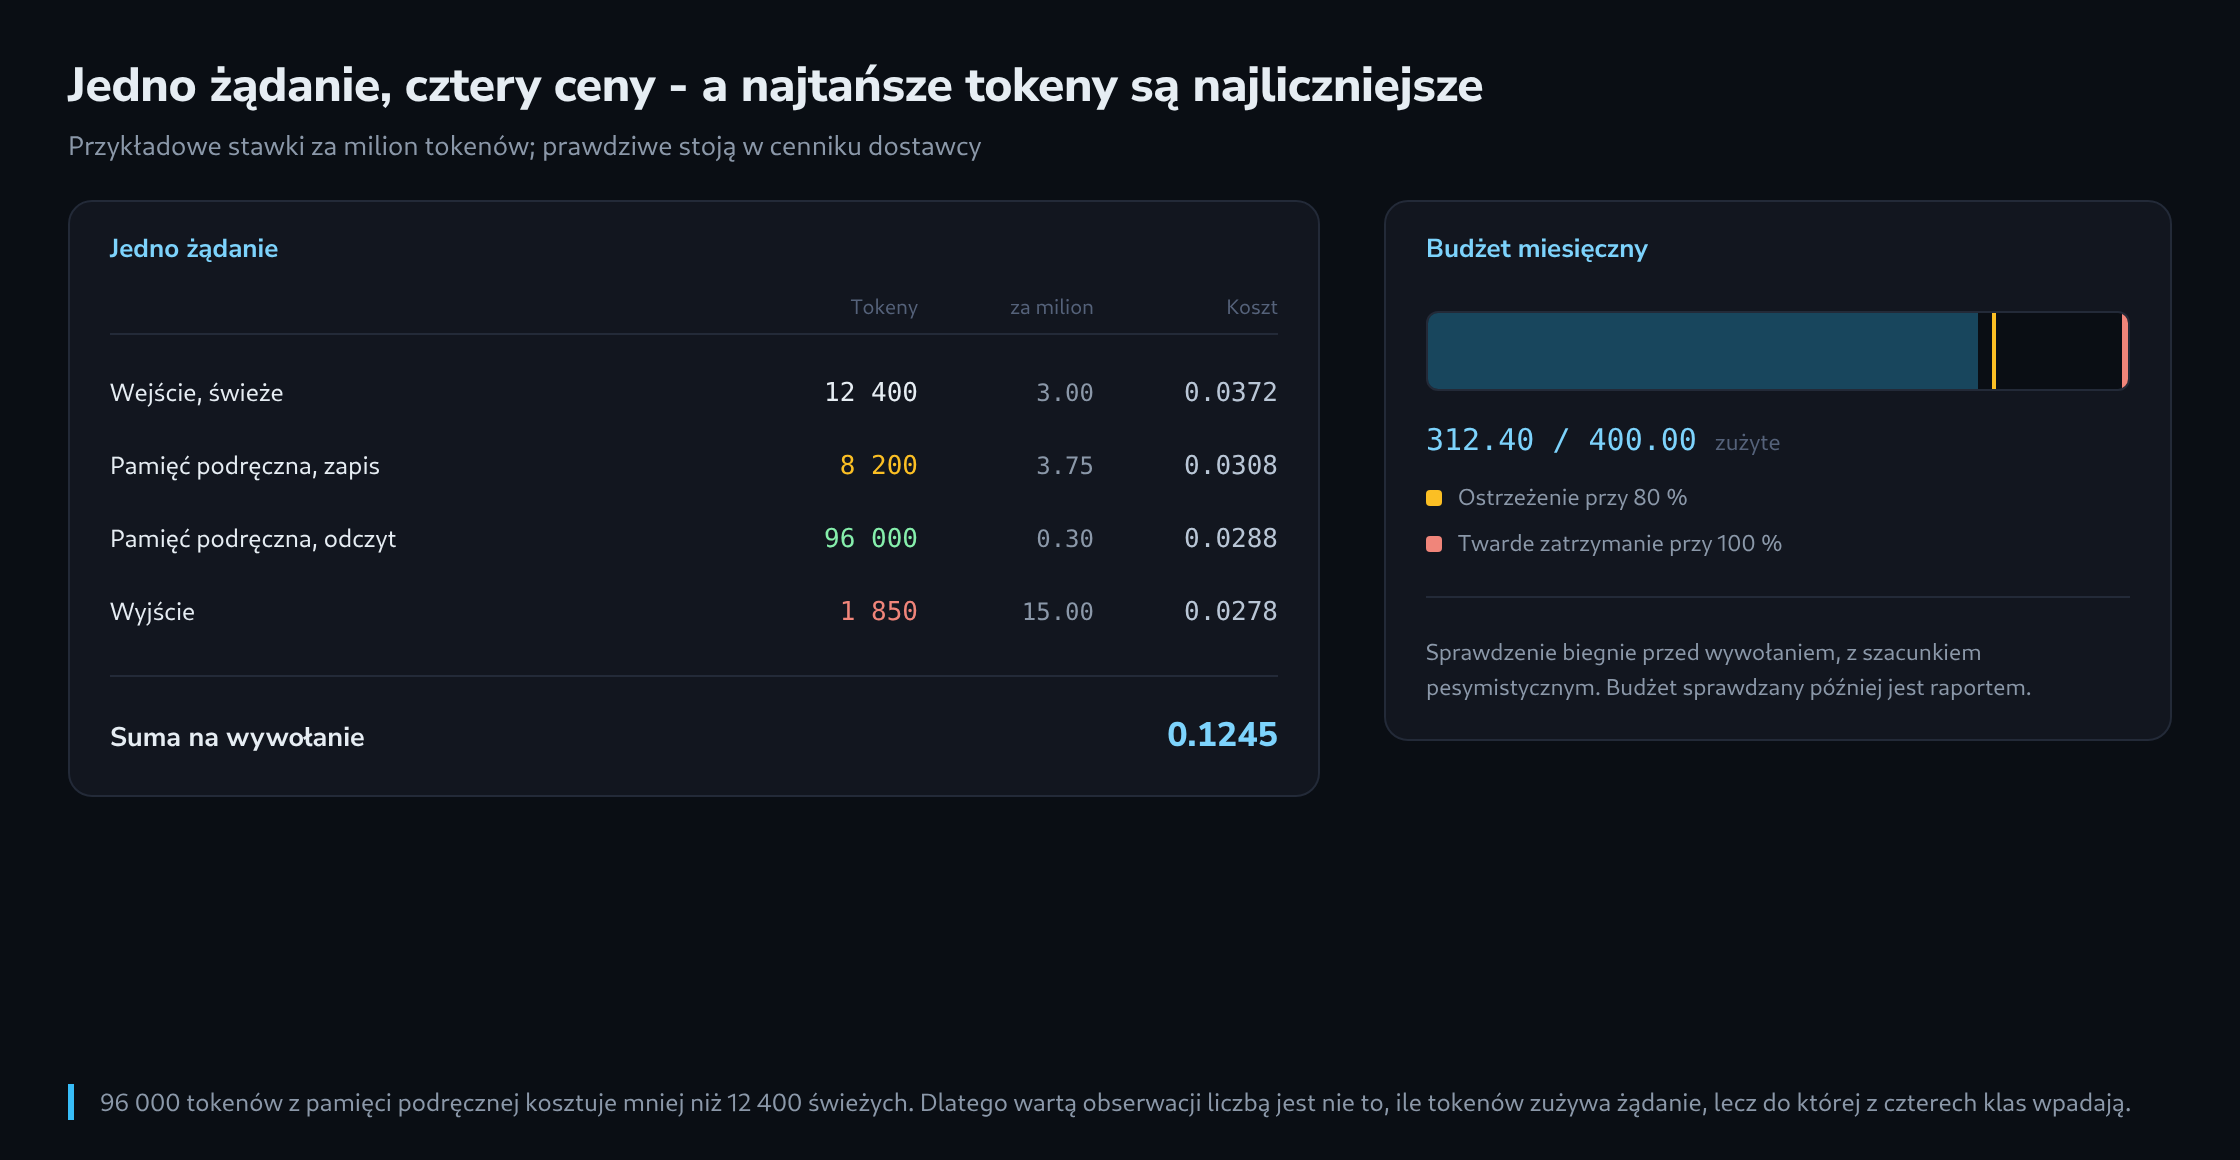
Te cztery pola to cztery różne ceny, a podział waży więcej niż suma. Świeżo wysłane wejście to stawka podstawowa. Tokeny zapisane do pamięci podręcznej promptu kosztują jednorazową dopłatę. Tokeny z niej odczytane kosztują ułamek stawki podstawowej. Wyjście jest klasą najdroższą ze wszystkich, zwykle wielokrotnością ceny wejścia.
Inni dostawcy nazywają te same rzeczy inaczej – prompt_tokens, completion_tokens i zagnieżdżone cached_tokens to zwykła odmiana – lecz budowa jest ta sama, a wniosek również: pojedynczej liczby z etykietą „tokeny” nie da się przeliczyć na pieniądze.
Do strumieniowania należy jedna uwaga. Blok usage nie przychodzi z pierwszym kawałkiem, lecz na końcu, w zdarzeniu zamykającym strumień. Kod czytający tekst i odrzucający resztę traci więc dokładnie tę część, która coś kosztuje.
Liczenie przed wysłaniem
Czasem liczba potrzebna jest, zanim żądanie w ogóle powstanie – aby rozstrzygnąć, czy dokument jeszcze się mieści albo czy rozmowę trzeba skrócić. Służy do tego punkt zliczający, bezpłatny i zwracający to, co zobaczyłby model.
curl https://api.anthropic.com/v1/messages/count_tokens \
  -H "x-api-key: $API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5",
    "messages": [{"role": "user", "content": "..." }]
  }'
Lokalny tokenizer odpowiada na to samo pytanie bez wywołania sieciowego i wystarcza do sprawdzenia długości, ale nie jest licznikiem. Instrukcje systemowe, definicje narzędzi i bloki obrazów wnoszą tokeny, których tokenizer tekstu nigdy nie widzi, a różnica przy żądaniu z dołączonymi narzędziami idzie w tysiące. Dla budżetu liczy się wyłącznie blok usage.
Jeden wiersz na żądanie
Sam zapis jest niewidowiskowy, a jego wartość leży w całości w polach opisujących kontekst, a nie żądanie. Model i liczby tokenów same z siebie nie odpowiadają na nic; oznaczenie, która funkcja wywołała żądanie, odpowiada niemal na wszystko.
import json, logging, sqlite3, time, uuid

DB = sqlite3.connect("verbrauch.db")
DB.execute("""CREATE TABLE IF NOT EXISTS aufrufe (
    id TEXT PRIMARY KEY, zeit INTEGER, modell TEXT, zweck TEXT,
    ein INTEGER, cache_neu INTEGER, cache_gelesen INTEGER, aus INTEGER,
    kosten REAL, versuch INTEGER)""")

def buchen(antwort, modell, zweck, versuch=1):
    u = antwort["usage"]
    zeile = dict(
        id=str(uuid.uuid4()), zeit=int(time.time()), modell=modell, zweck=zweck,
        ein=u["input_tokens"],
        cache_neu=u.get("cache_creation_input_tokens", 0),
        cache_gelesen=u.get("cache_read_input_tokens", 0),
        aus=u["output_tokens"], versuch=versuch)
    zeile["kosten"] = kosten(modell, zeile)
    DB.execute("INSERT INTO aufrufe VALUES (:id,:zeit,:modell,:zweck,:ein,"
               ":cache_neu,:cache_gelesen,:aus,:kosten,:versuch)", zeile)
    DB.commit()
    return zeile["kosten"]
Kolumna versuch zwraca się w sposób nieoczekiwany. Ponowna próba po przekroczeniu czasu wysyła całe wejście jeszcze raz i zostaje naliczona jeszcze raz, podczas gdy aplikacja widzi jedno logiczne wywołanie. Bez tej kolumny powtórki chowają się w średniej, a zły popołudniowy przebieg wygląda jak droga funkcja.
Zamiana tokenów na pieniądze
Ceny należą do jednego miejsca, według modelu i klasy tokenów, podane za milion tokenów – bo tak są publikowane.
# Przykładowe stawki za milion tokenów - prawdziwe stoją
# w cenniku dostawcy i zmieniają się w czasie.
PREISE = {
    "claude-sonnet-5": {"ein": 3.00, "cache_neu": 3.75, "cache_gelesen": 0.30, "aus": 15.00},
}

def kosten(modell, z):
    p = PREISE[modell]
    return round(sum(z[k] * p[k] for k in ("ein", "cache_neu", "cache_gelesen", "aus")) / 1e6, 6)
Zastosowane do powyższego żądania, cztery klasy dają 0,0372, 0,0308, 0,0288 oraz 0,0278 – razem 0,1245 na wywołanie. Pouczające jest zestawienie trzeciej wartości z pierwszą: 96 000 tokenów odczytanych z pamięci podręcznej kosztuje mniej niż 12 400 wysłanych na świeżo. Działająca pamięć podręczna nie tylko obniża więc rachunek, lecz przesuwa też to, która część żądania go wyznacza.
Gdy w tabeli leży kilka dni wierszy, właściwe pytanie daje się rozstrzygnąć jedną instrukcją.
SELECT zweck,
       COUNT(*)                          AS aufrufe,
       ROUND(SUM(kosten), 2)             AS gesamt,
       ROUND(AVG(kosten), 4)             AS je_aufruf,
       ROUND(100.0 * SUM(cache_gelesen) /
             NULLIF(SUM(ein + cache_neu + cache_gelesen), 0), 1) AS cache_anteil
FROM aufrufe
WHERE zeit >= strftime('%s', 'now', 'start of month')
GROUP BY zweck ORDER BY gesamt DESC;
Blokada, która naprawdę coś zatrzymuje
Budżet, który jedynie ostrzega, jest raportem. Zatrzymanie wymaga, by sprawdzenie stało przed wywołaniem – i by liczba była bieżąca, a nie z ostatniej nocy.
class BudgetErschoepft(Exception):
    pass

MONATSBUDGET = 400.0
WARNSCHWELLE = 0.80

def monatssumme():
    (s,) = DB.execute(
        "SELECT COALESCE(SUM(kosten), 0) FROM aufrufe "
        "WHERE zeit >= strftime('%s', 'now', 'start of month')").fetchone()
    return s

def pruefen(geschaetzte_kosten):
    verbraucht = monatssumme()
    if verbraucht + geschaetzte_kosten > MONATSBUDGET:
        raise BudgetErschoepft(f"{verbraucht:.2f} von {MONATSBUDGET:.2f} verbraucht")
    if verbraucht > MONATSBUDGET * WARNSCHWELLE:
        logging.warning("Budget zu %.0f %% verbraucht", 100 * verbraucht / MONATSBUDGET)
Trzy rozstrzygnięcia czynią z tego coś więcej niż formalność. Przekazywany szacunek powinien być pesymistyczny – najwyższa możliwa liczba tokenów wyjścia po cenie wyjścia – bo wywołanie jest albo dozwolone, albo nie, a zgoda na podstawie optymistycznej to droga do przekroczenia budżetu o dokładnie jedno żądanie.
Drugie dotyczy tego, co dzieje się po zgłoszeniu wyjątku. Przebieg wsadowy powinien się zatrzymać i powiedzieć, gdzie stanął. Funkcja w dialogu powinna ustąpić, a nie polec: mniejszy model, krótszy kontekst albo kolejka wznawiana w następnym miesiącu. Jedno i drugie jest lepsze niż ślad błędu docierający do czytelnika.
Trzecie: wspólny budżet potrzebuje wspólnego licznika. Kilka procesów z własnymi sumami każdy z osobna zmieści się pod granicą i wspólnie ją przekroczy. Jedna tabela z transakcją obejmującą odczyt i zapis albo licznik we wspólnej pamięci to cała naprawa.
Czego blokada nie widzi
Trzy rodzaje wydatków nigdy nie przechodzą przez sprawdzenie, a każdy ma własną drogę, by mimo to zostać ujęty.
Przetwarzanie wsadowe naliczane jest z rabatem i biegnie często w tle, więc blok usage przychodzi wiele godzin później wraz z wynikami. Jego koszt należy do tej samej tabeli, wpisany przy odbiorze wyników, ale z czasem zgłoszenia, a nie odbioru – inaczej na granicy miesięcy wydatek trafi do niewłaściwego miesiąca.
Drugim przypadkiem są żądania nieudane. Wywołanie wpadające w przekroczenie czasu po tym, jak model wytworzył już większość odpowiedzi, i tak zostaje naliczone, a bloku usage do odczytu nie dostarcza. Dostarcza natomiast identyfikator żądania w nagłówkach odpowiedzi, a raport zużycia u dostawcy go prowadzi. Comiesięczne uzgodnienie własnej tabeli z tym raportem kosztuje dziesięć minut i znajduje dokładnie tę klasę rozbieżności.
Trzecim przypadkiem jest wszystko, co nie jest uzupełnieniem czatu: osadzenia, transkrypcje, generowanie obrazów, narzędzie wyszukiwania wywołane po stronie serwera. Każde ma własny licznik i własną cenę, a żadne z nich nie pojawia się w zapisywanym tutaj bloku usage. Uzgodnienie wyłapuje i te – i to praktyczny powód, by je w ogóle prowadzić.
Pytania i odpowiedzi
Czy sprawdzenie budżetu wytrzymuje, gdy kilka żądań biegnie jednocześnie?
Nie w postaci pokazanej w artykule. pruefen() odczytuje sumę miesięczną, a buchen() zapisuje koszt dopiero po nadejściu odpowiedzi. Pomiędzy leży cały czas trwania wywołania, a każde żądanie sprawdzane w tym oknie widzi tę samą starą sumę. Wszystkie równoległe wywołania, których szacunek z osobna jeszcze się mieści, przechodzą więc, nawet jeśli pozostały budżet wystarczyłby tylko na jedno z nich.
Zaradzić temu da się rezerwacją. Sprawdzenie od razu księguje pesymistyczny szacunek jako wiersz tymczasowy, w tej samej transakcji, w której odczytuje sumę. Po nadejściu odpowiedzi rzeczywisty wiersz z bloku usage zastępuje rezerwację. Suma obejmuje wtedy także wywołania, które są jeszcze w drodze.
Należą do tego dwa szczegóły. Jeśli wywołanie zostaje odrzucone, zanim model cokolwiek wytworzy, rezerwację da się zwolnić. Jeśli natomiast urywa się po przekroczeniu czasu, mogło zostać naliczone mimo to, jak opisuje artykuł; rezerwację lepiej wtedy zostawić do comiesięcznego uzgodnienia, które pokaże rzeczywistą kwotę. W SQLite dopiero blokada zapisu założona przed odczytem, na przykład przez BEGIN IMMEDIATE, gwarantuje, że dwa procesy nie odczytają w tej samej chwili tej samej sumy i nie zarezerwują obu kwot na jej podstawie.
W jakiej strefie czasowej zaczyna się miesiąc w zapytaniach SQL?
W UTC: SQLite oblicza 'now' i 'start of month' w uniwersalnym czasie koordynowanym, a uniksowy znacznik czasu w kolumnie zeit również nie zna strefy. W Polsce miesiąc budżetowy zaczyna się więc o 1:00 czasu lokalnego, a w czasie letnim o 2:00. Jeśli raport zużycia dostawcy liczy w innej strefie, przy comiesięcznym uzgodnieniu przesuwają się godziny na granicy miesiąca.
Co się dzieje, gdy wywoływany jest model, którego brakuje w tabeli cen?
Wywołanie zostaje naliczone, ale do tabeli nie trafia. kosten() sięga po PREISE[modell] i przy nieznanej nazwie zgłasza KeyError; ponieważ buchen() oblicza koszt przed INSERT, przerywa działanie, nie zapisując wiersza. Suma miesięczna pozostaje za niska, a blokada przepuszcza dokładnie te wywołania, których nie zna.
Bezpieczne miejsce na to sprawdzenie leży przed wywołaniem. Pesymistyczny szacunek i tak potrzebuje ceny modelu; jeśli dla nieznanej nazwy się nie powiedzie, żądanie kończy się błędem, zanim cokolwiek kosztuje. Dotyczy to przede wszystkim dnia, w którym pojawia się nowy model albo nowy alias, a tabela cen nie zostaje uzupełniona.
Źródła
Powiązane artykuły