English
 Deutsch
 Polski
Verhaltensmodellierung in GA4: Die zwei Voraussetzungen und wo modellierte Werte erscheinen

Management Summary
Die Verhaltensmodellierung in GA4 schätzt einen Teil der Websiteaktivität, die bei fehlender Analytics-Einwilligung nicht vollständig messbar ist. Bestimmte Berichte sollen dadurch trotz Lücken aussagekräftiger werden; eine lückenlose Wiederherstellung einzelner Besuche entsteht nicht. Die Funktion braucht genügend einwilligende Nutzer, Ereignisse ohne Zustimmung und weitere Qualitätsvoraussetzungen. Schätzwerte erscheinen nur in ausgewählten Berichten und nicht im Ereignisexport. Unterschiedliche Ansichten können deshalb berechtigt voneinander abweichen.
Inhalt
Consent Mode schließt Lücken durch fehlende Analytics-Einwilligungen nicht automatisch. Die Verhaltensmodellierung in GA4 schätzt Nutzer- und Sitzungsaktivität nur bei geeigneten Properties. Die beiden veröffentlichten Mengenschwellen sind Mindestanforderungen, keine Einschaltgarantie.
Ereignisse und Nutzer sind unterschiedliche Größen
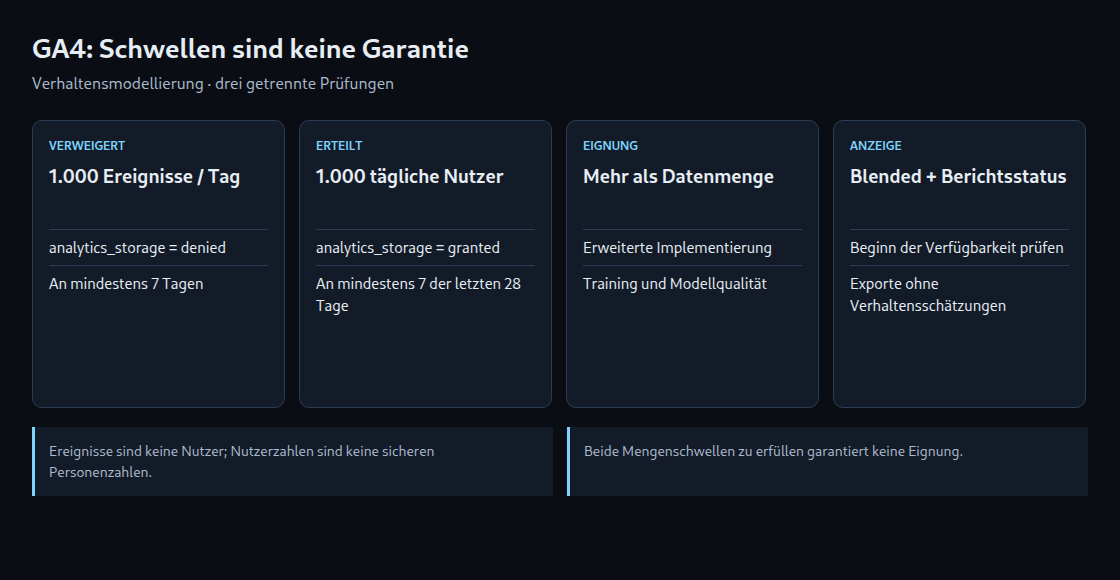
Die erste Schwelle verlangt mindestens 1.000 Ereignisse pro Tag mit analytics_storage='denied' an mindestens sieben Tagen. Die zweite verlangt mindestens 1.000 tägliche Nutzer, die Ereignisse mit analytics_storage='granted' senden, an mindestens sieben der vorherigen 28 Tage. Google nennt das 28-Tage-Fenster ausdrücklich für die zweite Bedingung. Ein solches Fenster oder aufeinanderfolgende Tage auch für die erste vorauszusetzen, geht über den veröffentlichten Wortlaut hinaus.
Tausend Ereignisse können aus vielen Besuchen oder aus wiederholten Aktionen weniger Besuche stammen. Umgekehrt entspricht ein Analytics-Nutzer nicht garantiert genau einer natürlichen Person. Eine Summe von Seitenaufrufen oder eine Zustimmungsquote des Banners ersetzt deshalb keine der beiden Größen.
Erhebung, Eignung und Anzeige
Im Web setzt die Funktion den erweiterten Consent Mode auf allen Seiten voraus: Tags laden auch ohne Einwilligung, mit dem passenden Standardzustand vor Beginn der Messung. Der einfache Modus blockiert Google-Tags bei fehlender Einwilligung und liefert deshalb diese Ereignisse mit verweigerter Analytics-Speicherung nicht. Consent Mode steuert das Tag-Verhalten; daraus entsteht keine eigenständige Erlaubnis zur Datenerhebung.
Auch ausreichende Mengen garantieren keine Eignung. Training und zusätzliche Qualitätskriterien des Modells spielen ebenfalls eine Rolle. Die Anzeige der Verhaltensschätzungen erfordert die Identität für die Berichterstellung Blended. Observed und Device-based lassen diese Verhaltensmodellierung weg. Ein Wechsel dieser Einstellung verändert weder die Erhebung noch dauerhaft die zugrunde liegenden Daten.
Berichte erfordern unterschiedliche Lesarten
In Berichten betrifft die Modellierung Größen wie Nutzer und Sitzungen, statt Ereigniszahlen einfach hochzurechnen. Pfad- und Trichteranalysen behandeln first_visit und session_start anders: Dort können diese Ereignisse modelliert werden. Eine pauschale Einordnung dieser Analysen als nicht unterstützt wäre deshalb irreführend.
Verhaltensschätzungen fehlen in Zielgruppen, Nutzer-, Kohorten- und Nutzer-Lifetime-Explorationen, Sequenzsegmenten, Bindungsberichten, Vorhersagemetriken und BigQuery-Exporten. Daraus folgt nicht, dass jede Differenz zwischen Bericht und Export an der Modellierung liegt. Zeitraum, Metrikdefinition und Abfrage bleiben prüfbedürftig. Fehlende Schätzungen beweisen außerdem nicht, dass keine Ereignisse ohne Cookies erhoben wurden.
Der Status gehört zur Messung
Das Datenqualitätssymbol nennt den Modellierungsstatus und den Beginn der Verfügbarkeit. Google beschreibt außerdem Hinweise in der Oberfläche und Mitteilungen zu Änderungen mit großen Datenauswirkungen. Nach einem Verlust und erneuten Erreichen der Eignung stehen Schätzungen erst ab dem neuen Eignungsdatum bereit. Ein rückwirkendes Füllen der Lücke ist nicht zugesagt.
Eine aussagekräftige Prüfung hält Property, Zeitraum, Berichtsidentität, Statusmeldung und Berichtstyp gemeinsam fest. Eigene Zählungen können zu geringe Mengen oder Fehler in der Erhebung zeigen, aber Googles interne Eignungsentscheidung nicht bestätigen.
Fragen und Antworten
Was folgt aus einer hohen Ablehnungsquote?
Bei gleicher Gesamtmenge und ansonsten gleichen Bedingungen verbleiben mit einem höheren Ablehnungsanteil weniger einwilligende Nutzer. Welche Schwelle zuerst zum Hindernis wird, steht damit nicht fest. Beispielsweise verfehlen 1.500 einwilligende Nutzer bei nur 500 Ereignissen mit verweigerter Speicherung weiterhin die Ereignisschwelle. Bei vertauschten Mengen fehlt es an Nutzern.
Hilft die Rechnung 1.000 / (1 − q)?
Als vereinfachtes Planungsbeispiel ist die Rechnung brauchbar. Dabei bezeichnet q den Ablehnungsanteil derselben täglich gezählten Nutzer. Jeder Nutzer muss eindeutig zu einer Einwilligungsgruppe gehören, und die Zähldefinitionen müssen zusammenpassen. Bei 60 Prozent Ablehnung sind insgesamt 2.500 Nutzer nötig, bei 80 Prozent insgesamt 5.000, um 1.000 Einwilligende zu erreichen. Die Rechnung sagt nichts über die Ereignismenge bei Ablehnung oder die Modellqualität. Eine Quote je Bannereinblendung hat einen anderen Nenner.
Fehlende Käufe schätzt diese Formel ebenfalls nicht. In einem Beispiel mit je 1.000 einwilligenden und ablehnenden Nutzern können 100 beobachteten Käufen sowohl 20 als auch 200 Käufe der anderen Gruppe gegenüberstehen. Gleiche Gruppengrößen belegen kein gleiches Kaufverhalten.
Passend dazu