English
 Deutsch
 Polski
Vier Arten von Zahlen im Conversion-Bericht: Gezählt, modelliert, hochgerechnet und geschätzt mit Bereich

Management Summary
Vertriebs- und Werbeberichte enthalten unterschiedliche Zahlenarten: erfasste Vorgänge, Schätzungen für Messlücken, Hochrechnungen und Bereiche für Unsicherheit. Diese Angaben beantworten verschiedene Fragen zu beobachteten Ergebnissen und erwarteten Entwicklungen. Das Verständnis der jeweiligen Bedeutung verhindert, dass scheinbar präzise Berichte falsche Sicherheit für Geschäftsentscheidungen erzeugen. Schätzungen können sich mit gezählten Käufen überschneiden; die Addition aller Werte kann denselben Erfolg doppelt zählen.
Finde die versteckten Probleme ↓
Inhalt
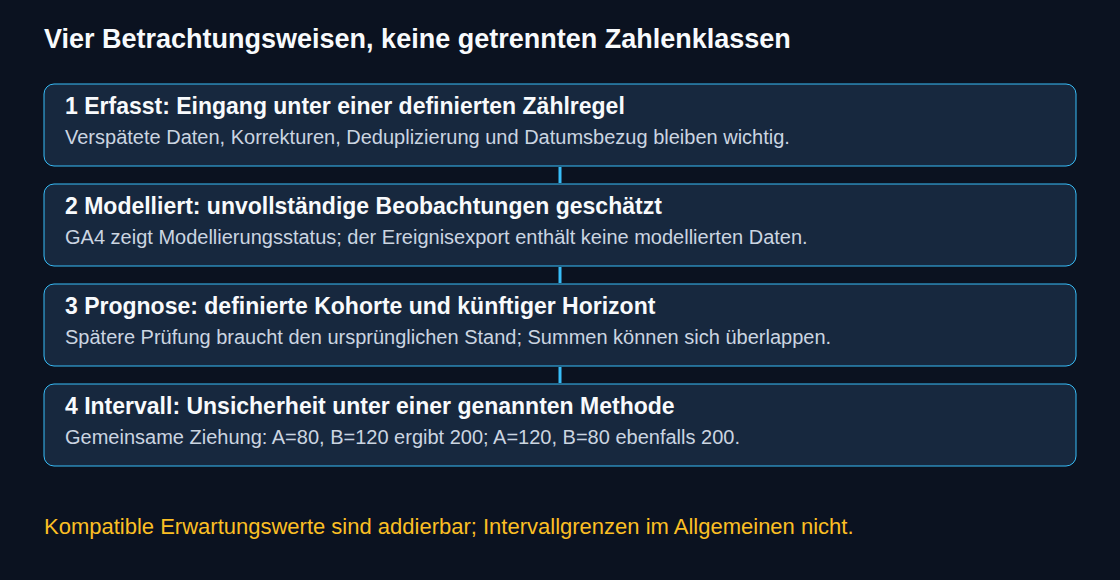
Ein Conversion-Bericht kann erfasste Ereignisse, Schätzungen für Beobachtungslücken, Prognosen und Schätzungen mit Unsicherheitsbereich enthalten. Das sind vier nützliche Betrachtungsweisen, keine vier statistisch überschneidungsfreien Kategorien. Eine Prognose ist ebenfalls modelliert; sowohl vergangenheitsbezogene Schätzungen als auch Zukunftsprognosen können Intervalle besitzen.
Verständlich wird eine Zahl durch Angaben zu Messung oder Schätzung, der betrachteten Gruppe von Personen oder Ereignissen, Zeitraum, Berechnungsregeln und Abrufstand. Die Darstellung in einer Spalte beantwortet diese Fragen nicht.
Gezählt: unter festgelegten Regeln erfasst
Ein erfasstes Ereignis belegt den Eingang im Messsystem, nicht die vollständige und genau einmalige Erfassung jedes tatsächlichen Abschlusses. Doppelte Ereignisse, Messlücken und die Conversion-Definition bleiben relevant. Google Ads unterscheidet beispielsweise die Zählung jedes Abschlusses von einer Conversion je Anzeigeninteraktion für eine Conversion-Aktion.
Zählwerte können durch verspätete Verarbeitung und Korrekturen verändert werden. Google Ads unterscheidet dabei Rücknahmen mit Wirkung auf die Anzahl von Wertanpassungen. Auch ein geschlossenes Attributionsfenster macht nicht jede veröffentlichte Zahl dauerhaft unveränderlich. Reproduzierbarkeit erfordert einen gesicherten Datenstand samt Abfrage, Konfiguration und Definition.
Zählwerte aus überschneidungsfreien Zeiträumen sind bei gleichen Regeln und gleichem Datumsbezug addierbar. Unterschiedliche Personen lassen sich dagegen nicht einfach monatsweise aufsummieren, wenn dieselbe Person in beiden Monaten vorkommt. Für Quoten braucht die Zusammenfassung Zähler und Nenner statt einer Addition angezeigter Prozentsätze.
Modelliert: eine unvollständig beobachtete Größe geschätzt
Consent Mode kann verschiedene Modellierungen unterstützen. Die GA4-Verhaltensmodellierung schätzt Verhalten bei fehlenden dauerhaften Kennungen anhand ähnlich beobachteter Nutzergruppen. Conversion-Modellierung ist ein anderer Modelleinsatz; dafür gelten nicht automatisch die Eignungsschwellen der Verhaltensmodellierung.
In GA4 hängen Verhaltensmodellierung und Darstellung von Eignung und Berichtsidentität ab. Das Datenqualitätssymbol und auf manchen Seiten Hinweise zeigen eingeschlossene, ausgeschlossene oder nicht verfügbare geschätzte Nutzerdaten an. Ein Bericht kann Beobachtungen und Schätzungen kombinieren, ohne für jede Zeile einen eigenen Modellierungsanteil auszuweisen. Das bedeutet jedoch nicht, dass jeglicher Hinweis fehlt.
Der GA4-Ereignisexport nach BigQuery enthält keine modellierten GA4-Daten. Das ist eine Grenze dieses Exports, keine Einschränkung von BigQuery als Speichersystem: Ergebnisse anderer Modelle können dort gespeichert werden. Eine Abweichung zur Oberfläche beweist ebenfalls keine Modellierung. Zeitzonen, Kennzahlenebene, Filter, Exportvollständigkeit, Verarbeitungsstand und Berechnungsmethode können Unterschiede verursachen.
Projiziert: ein definiertes Ziel in der Zukunft
Eine Prognose schätzt ein künftiges Ergebnis anhand der zu einem bestimmten Zeitpunkt verfügbaren Informationen. Google beschreibt Qualified Future Conversions (QFC) als Signal, das Werbekontakt und nachfolgende frühe Handlungen wie Markensuchen mit erwarteten künftigen Conversions verbindet. Die veröffentlichte Übersicht zur Leadgenerierung nennt einen Horizont von bis zu sechs Monaten.
Vor Verwendung benötigen konkrete Kontokennzahl, Horizont, Verfügbarkeit und Berichtsdefinition eine Bestätigung. Die allgemeine Ankündigung belegt weder identische Spalten noch einen aktuellen Pilotstatus für jedes Konto. Eine Prognose sämtlicher Ergebnisse unterscheidet sich von einer Prognose noch ausstehender Ergebnisse. Eine pauschale Addition zu erfassten Conversions kann deshalb doppelt zählen.
Eine Prognose lässt sich nach Ablauf des Zielzeitraums und unter Berücksichtigung der Berichtsverzögerung bewerten. Dafür braucht die Prüfung den ursprünglichen Prognosestand, die betrachtete Gruppe von Fällen (Zielkohorte), das Zieldatum und die Bewertungsregel. Ein späterer Wert derselben Spalte kann bereits eine überarbeitete Prognose sein. Fehlende Beobachtungen späterer Ergebnisse begrenzen auch die Prüfung; eine attribuierte Prognose beweist nicht automatisch einen ursächlichen Werbemehrwert.
Geschätzt mit Bereich: Unsicherheit braucht eine Definition
Ein Marketing-Mix-Modell kann einen zusätzlichen Beitrag schätzen und einen Zentralwert mit Intervall ausgeben. Intervallart und Niveau gehören zur Zahl. Bei einem bayesianischen 90-%-Glaubwürdigkeitsintervall beträgt die Wahrscheinlichkeit im Modell 90 %, dass die unbekannte Größe innerhalb des Bereichs liegt. Grundlage sind die beobachteten Daten zusammen mit den Vorannahmen. Ein frequentistisches 90-%-Konfidenzverfahren bedeutet dagegen: Bei vielen wiederholten Stichproben würden etwa 90 % der berechneten Bereiche den festen wahren Wert enthalten, sofern die Annahmen des Verfahrens gelten. Ein Vorhersageintervall bezieht sich auf eine künftige Beobachtung statt allein auf einen Modellparameter.
Kein Intervall deckt automatisch sämtliche Fehlerquellen ab. Fehlende Einflussfaktoren, mangelhafte Messung oder ein ungeeignetes Modell können auch einen engen Bereich irreführend machen. Google Meridian empfiehlt deshalb die Prüfung von Modellannahmen und Ergebnissen statt allein der Vorhersagegüte. Ein Intervall liefert wertvolle Information, aber kein automatisches Qualitätssiegel.
Was lässt sich addieren?
Erwartete Anzahlen kompatibler, überschneidungsfreier Gruppen sind addierbar, auch bei Modellierung oder Prognose. Für Erwartungswerte benötigt E(A+B)=E(A)+E(B) keine Unabhängigkeit. Daraus folgt keine Erlaubnis zur Addition überlappender attribuierter Conversions, verschiedener Zielgrößen, Quoten oder inkompatibler Prognosen.
Die Unsicherheit hängt auch davon ab, welche Werte gemeinsam auftreten können. Das beschreibt die gemeinsame Verteilung. Quantile und Intervallgrenzen sind im Allgemeinen nicht addierbar. Ein vereinfachtes Beispiel verwendet vier gleich gewichtete gemeinsame Szenarien: Kanal A erhält 80, 90, 110, 120, Kanal B 120, 110, 90, 80. Jede paarweise Summe ist 200. Getrennt addierte Minima und Maxima ergeben 160–240; das ist nicht der Wertebereich der paarweisen Summen. Das Beispiel veranschaulicht Abhängigkeit, kein angepasstes Marketingmodell und kein Glaubwürdigkeitsintervall.
Bei posterioren Stichproben werden kompatible Ergebnisse zunächst innerhalb jeder gemeinsamen Ziehung addiert. Aus diesen Summen entsteht anschließend das Intervall. Ein unabhängiges Umsortieren der Kanalwerte zerstört die Abhängigkeit. Das gemeinsame Modell bestimmt außerdem, ob Beiträge überhaupt additiv definiert sind.
Fragen und Antworten
Erkennt eine Exportabweichung eine modellierte Zahl?
Nein. Auch eine gezählte Kennzahl kann wegen eines unvollständigen Exports oder anderer Abfrageregeln abweichen. Umgekehrt kann eine Modellschätzung bei gesicherten Daten, Modell, Software und Zufallszustand reproduzierbar sein. Definition und Verarbeitung liefern stärkere Belege als ein bloßer Gleichheitstest.
Sind Monate mit unterschiedlichem Modellierungsstatus vergleichbar?
Nur bei offengelegtem Methodenwechsel. Eine einheitlich definierte Reihe beobachteter Daten kann helfen; veränderte Einwilligungsquoten oder Messabdeckung können trotzdem die Zusammensetzung verändern. Ein Export macht zwei Zeiträume nicht automatisch vergleichbar.
Welches Datum gehört zu einer Conversion?
Die primären Conversion-Spalten in Google Ads ordnen Ergebnisse üblicherweise dem Anzeigenklickdatum zu. Separate Spalten „nach Conversion-Zeit“ verwenden den tatsächlichen Conversion-Zeitpunkt. Ein Kauf im Oktober nach einem Septemberklick kann deshalb in zwei gültigen Berichten unterschiedlichen Monaten zugeordnet sein. Datumsbezug und Abrufstand gehören in den Bericht.
Wie lässt sich das Ergebnis formulieren?
Beispielsweise: „620 erfasste Käufe nach Entfernung doppelter Meldungen im September, abgerufen am 10. Oktober nach Definition V3“, „geschätzte Gesamtsumme unter dem angegebenen Modell“ oder „erwartete Ergebnisse der definierten Kohorte bis zum genannten Horizont“. Ein Intervall braucht Niveau und Methode. Für eine vereinbarte Berichtskennzahl zählen Definition, Korrekturregel und Stichtag mehr als eine pauschale Beschränkung auf Zählwerte.
Quellen
- Google Ads: Zähloptionen für Conversions
- Google Ads: Conversion-Spalten und Conversion-Zeitpunkt
- Google Ads: Conversion-Korrekturen
- Google Analytics: Verhaltensmodellierung für Consent Mode
- Google Analytics: Berichte und BigQuery-Ereignisexport
- Google: Qualified Future Conversions
- Google: Neuerungen zur Leadgenerierung und Signale künftiger Conversions
- Google Meridian: Modellgüte und Ergebnisse nach Datenabgleich prüfen
- Google Meridian: Zusammenfassung und Glaubwürdigkeitsintervalle
- NIST: Konfidenzgrenzen und deren Bedeutung
Verstehen durch Ausprobieren
Bessere Kaufquote – oder nur andere Messlücken?
Die Wahrheit im Beispiel bleibt gleich: 1.000 Besuche, 100 Käufe. Verändere nur, was davon im Bericht ankommt.
- Gemessene Besuche
- Gemessene Käufe
- Kaufquote im Bericht
Spielmodell: 100 Käuferbesuche mit je einem Kauf und 900 Besuche ohne Kauf. Erfassungsanteile sind bekannte Modellwerte. Keine Nachbildung einer konkreten GA4-Metrik oder Googles Modellierung. Reale fehlende Käufe lassen sich aus der gemessenen Quote allein nicht zurückrechnen.
Dieses Modul rechnet im Browser und sendet oder speichert Deine Eingaben nicht.
Verstehen durch Ausprobieren
Eine Minute: Findest Du den Denkfehler?
Die gemessene Kaufquote steigt, nachdem sich die Erfassung verändert hat. Beweist das mehr echte Käufe?
Wenn Käuferbesuche häufiger erfasst werden als andere Besuche, steigt die gemessene Quote auch ohne echte Verbesserung. Für Vergleiche müssen Erfassung und Bezugsgröße zusammenpassen. Die bekannte Wahrheit gibt es hier nur, weil es ein konstruiertes Beispiel ist.
Finde die versteckten Probleme
Vereinfachtes Lernmodell
Finde die versteckten Probleme
Drei Fehler verbergen sich in jedem Beispiel. Klicke verdächtige Stellen an und begründe Deinen Verdacht.
Wähle eine Stelle. Ist sie ein Fehler oder im gezeigten Beispiel in Ordnung?
Fiktive, bewusst vereinfachte Beispiele. Der vollständige Kontext steht jeweils an der Stelle; keine Bewertung Deiner eigenen Website oder Geräte.
Diese Beispiele rechnen nur in Deinem Browser. Es werden keine echten Systeme gestört.
PNG mit Einstellungen, Ergebnis und Artikelverweis. Erst beim Klick lokal erstellt.
Passend dazu