English
 Deutsch
 Polski
Search Console: Suchanfrage-Cluster und KI-Sichtbarkeit

Management Summary
Thematisch gebündelte Suchbegriffe machen aus Daten der Google Search Console ein verständlicheres Bild der Nachfrage, etwa nach Preisen, Produktanbindungen oder Vergleichen. Das hilft bei der Einschätzung, welche Inhalte Aufmerksamkeit gewinnen und wie sich Interessen verändern. Sichtbarkeit in Googles KI-Antworten ergänzt dieses Bild, überschneidet sich aber mit allgemeinen Suchdaten und lässt sich den Themengruppen nicht verlässlich zuordnen. Sinkende Klickzahlen allein belegen daher keinen Verlust durch KI.
Inhalt
Suchanfrage-Cluster fassen Suchbegriffe nach Themen wie Preisen oder Integrationen zusammen. Regex-Filter erkennen passende Begriffe anhand von Textmustern; die Search Console unterstützt bereits solche Gruppen. Ein Dashboard ergänzt wiederverwendbare Kategorien und mehrere Trends in einer Ansicht. Diese Anleitung verbindet Suchanfrage-Cluster aus der Search Analytics API oder dem nativen Connector mit einer getrennten Ansicht der generativen KI-Impressionen von Google.
Die Daten beantworten unterschiedliche Fragen: Suchanfrage-Cluster beschreiben berichtete Suchnachfrage; der Bericht zur generativen KI-Leistung zeigt Impressionen in AI Overviews und AI Mode. Ein Klickrückgang allein misst keine KI-Sichtbarkeit.
1. Datenquelle und Aggregation wählen
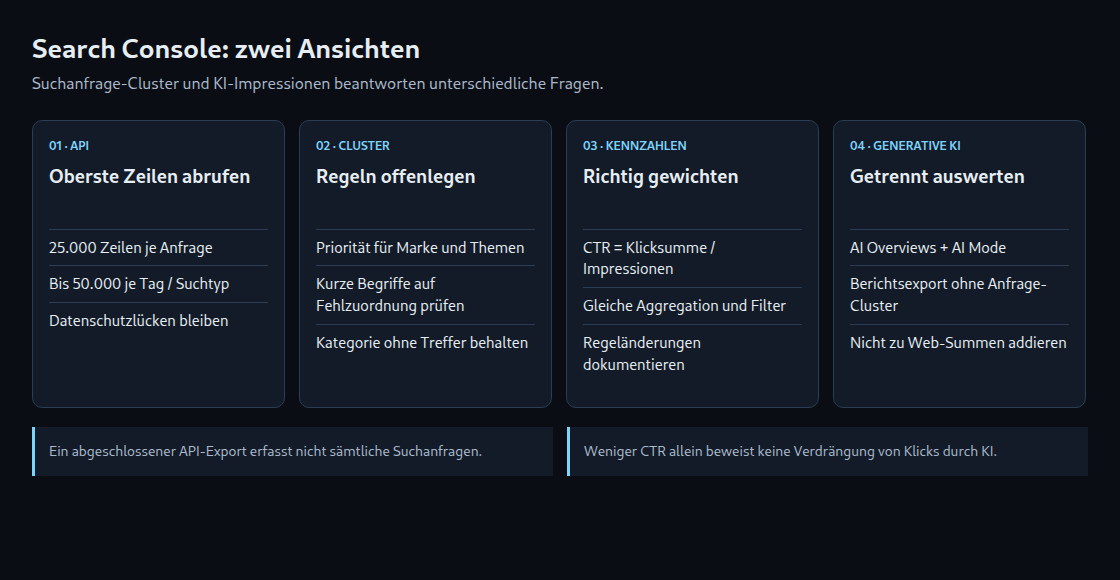
Die Oberfläche exportiert höchstens 1.000 Tabellenzeilen. Die API liefert bis zu 25.000 Zeilen je Anfrage und höchstens 50.000 je Tag und Suchtyp, nach Klicks sortiert. Pagination stellt nicht jede seltene Suchanfrage wieder her. Für regelmäßige Exporte machen einzelne abgeschlossene Tage die tägliche Grenze nachvollziehbar.
Die folgende Anfrage zeigt einen Beispielkörper für einen Tag, kein vollständiges Exportprogramm. Erforderlich ist ein OAuth-Zugriffstoken mit Zugriff auf die Property; ein Nur-Lese-Scope genügt. Die Property-Kennung muss zur Search Console passen, etwa eine URL-Präfix-Property oder sc-domain:example.com. API-Datumsgrenzen gelten in Pacific Time. Ein produktiver Job benötigt Pagination, Wiederholungslogik, eindeutige Schlüssel aus Property/Datum/Suchtyp und das Ersetzen bereits importierter Tage statt doppelter Einträge.
POST https://www.googleapis.com/webmasters/v3/sites/https%3A%2F%2Fexample.com%2F/searchAnalytics/query
Authorization: Bearer ACCESS_TOKEN
Content-Type: application/json

{
  "startDate": "2026-07-01",
  "endDate": "2026-07-01",
  "dimensions": [
    "query"
  ],
  "type": "web",
  "dataState": "final",
  "rowLimit": 25000,
  "startRow": 0
}
Für die nächste Seite bleiben Datum und Filter gleich; startRow steigt um 25.000. Weniger als 25.000 zurückgegebene Zeilen beenden den Abruf dieses Tages. Nach einer vollständig gefüllten letzten Seite folgt noch eine Anfrage, deren Ergebnis leer sein kann. Damit sind nur die von der API bereitgestellten Zeilen vollständig abgerufen, nicht verborgene oder abgeschnittene Suchhistorie.
Der native Search-Console-Connector ist eine Alternative zum API-Job. Site Impression fasst Daten je Property zusammen; URL Impression ermöglicht Auswertungen je Seite einschließlich Suchanfrage und Zielseite. Die Aggregationsebenen können unterschiedliche Summen liefern. Ein Vergleich benötigt getrennte Datenquellen mit gleichen Zeiträumen, Suchtypen und Filtern.
2. Regex-Regeln definieren und prüfen
Search Console und Looker Studio verwenden RE2-Syntax. Lookahead und Lookbehind werden nicht unterstützt. In der API schließt excludingRegex ein Muster aus; includingRegex schließt passende Werte ein. Zwei Filter derselben and-Gruppe verbinden Einschluss und Ausschluss.
REGEXP_MATCH prüft den vollständigen Feldwert. Für Teiltreffer sind Platzhalter erforderlich. Das Beispiel verwendet bewusst Buchstabengrenzen: Ein bloßes api würde auch Kapital treffen. Diese Grenzen passen zum Beispielwortschatz und benötigen sprachspezifische Tests.
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(^|[^a-ząćęłńóśźżäöüß])(acme|acmecorp|acme corp|acme app)([^a-ząćęłńóśźżäöüß]|$).*') THEN 'Marke'
  ELSE 'Nicht-Marke'
END
(?i) aktiviert ausdrücklich einen Abgleich ohne Beachtung der Groß- und Kleinschreibung. Markenvarianten und Produktnamen gehören in eine gepflegte Liste; zu breite Begriffe können fremde Suchanfragen als Markensuche einordnen. Die Klassifikation beschreibt Suchbegriffe und beweist keine Gewinnung durch Inhalte oder Werbung.
3. Suchanfragen in Cluster einordnen
Der erste passende CASE-Zweig gewinnt. Im Beispiel hat die Marke Vorrang vor Themen, anschließend Preise vor Integrationen und Vergleichen. Eine andere Regel ist möglich; die Priorität benötigt jedoch eine Dokumentation und Tests mit mehrfach passenden Suchanfragen.
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(^|[^a-ząćęłńóśźżäöüß])(acme|acmecorp|acme corp|acme app)([^a-ząćęłńóśźżäöüß]|$).*') THEN 'Marke'
  WHEN REGEXP_MATCH(Query, '(?i).*(^|[^a-ząćęłńóśźżäöüß])(preis[a-z]*|kosten|was kostet)([^a-ząćęłńóśźżäöüß]|$).*') THEN 'Preise'
  WHEN REGEXP_MATCH(Query, '(?i).*(^|[^a-ząćęłńóśźżäöüß])(integration[a-z]*|api|webhooks?|sync)([^a-ząćęłńóśźżäöüß]|$).*') THEN 'Integrationen'
  WHEN REGEXP_MATCH(Query, '(?i).*(^|[^a-ząćęłńóśźżäöüß])(vs|alternative[a-z]*|vergleich[a-z]*)([^a-ząćęłńóśźżäöüß]|$).*') THEN 'Vergleich'
  ELSE 'Ohne Treffer'
END
Ohne Treffer bedeutet, dass keines der hinterlegten Muster passt. Nach Impressionen sortierte Zeilen helfen bei der Suche nach fehlenden Begriffen und unerwünschten Treffern. Die Kategorien sind eine Berichtskonvention und keine vollständige Beschreibung der Suchabsicht.
4. Vergleichbare Kennzahlen berechnen
Sinnvoll sind Zeitreihen für Impressionen und Klicks je Cluster, eine Cluster-Tabelle und Suchanfragen ohne Treffer. Die Cluster-CTR lautet SUM(Clicks) / SUM(Impressions); bei null Impressionen bleibt der Wert leer. CTR bezeichnet den Anteil der Impressionen, der zu einem Klick führt. Ein Mittelwert einzelner CTR-Werte gibt einer Zeile mit 10 Impressionen dasselbe Gewicht wie einer Zeile mit 10.000 Impressionen. Das kann das Ergebnis verzerren. Versionierte Klassifikationsregeln verhindern, dass geänderte Regeln unbemerkt als historische Entwicklung erscheinen.
Getrennte Trends für Marke und Nicht-Marke können Entwicklungen sichtbar machen, die eine Gesamtsumme verdeckt. Markensuchen können mit Kampagnen, Saison und Bekanntheit schwanken; höhere Abschlussquoten sind nicht garantiert. Search-Console-Klicks entsprechen weder Analytics-Sitzungen noch abgeschlossenen Käufen.
5. Generativen KI-Bericht getrennt ergänzen
Seit dem 31. August 2026 dokumentiert Google einen weltweit verfügbaren Bericht zur generativen KI-Leistung in der Suche. Enthalten sind Impressionen in AI Overviews und AI Mode. Dokumentierte Aufteilungen umfassen Seiten, Länder, Datum und Geräte, keine Suchanfrage-Cluster. Ein Berichtsexport kann eine gesondert beschriftete Dashboard-Tabelle versorgen. Die dokumentierte Search Analytics API und der native Connector belegen keine gleichwertige generative KI-Dimension; die Beispielanfrage dieses Artikels ruft diesen Bericht nicht ab.
Der generative Bericht überschneidet sich mit den Web-Leistungsdaten. Eine Addition seiner Impressionen zu Web-Gesamtwerten zählt überlappende Beobachtungen doppelt. Eine sinkende Cluster-CTR bleibt ein Diagnosehinweis, kein Beweis für eine Verdrängung durch KI. Auch Snippets, Gerätemix und andere Suchanfragen können den Verlauf erklären. Ohne Suchanfrage-Dimension lässt sich eine KI-Impressionstabelle nicht verlässlich mit Suchanfrage-Clustern verknüpfen.
6. Datengrenzen dokumentieren
Datenschutzfilter verbergen bestimmte Suchanfragetexte; Zeilengrenzen lassen weitere Daten aus. Nach Suchanfragen gefilterte Summen können deshalb kleiner als ungefilterte Gesamtwerte sein. Cluster-Anteile beziehen sich auf die abgerufenen Zeilen unter den gewählten Filtern. Der fehlende Anteil lässt sich keinem Thema zuweisen. Die Differenz entsteht nicht immer ausschließlich durch Anonymisierung.
Die normale Leistungshistorie umfasst 16 Monate. Längere Vergleiche benötigen vor Ablauf gespeicherte Daten; ein neuer Export stellt abgelaufene Historie nicht wieder her. Durchschnittliche Positionen lassen sich nur über kompatible, überschneidungsfreie Zeilen nach Impressionen gewichten: SUM(Position * Impressions) / SUM(Impressions). Ein einfacher Mittelwert der Zeilenpositionen ist ungeeignet.
Fragen und Antworten
Wie lassen sich Markenbegriffe einschließen und Wettbewerber ausschließen?
Getrennte Filter oder geordnete Kategorien bilden zusammengesetzte Bedingungen ohne Lookahead ab. Entscheidend ist, ob Wettbewerbsanfragen entfernt oder als eigene Kategorie ausgewiesen werden sollen.
Ein Wettbewerbszweig vor dem Markenzweig ordnet eine Suchanfrage mit beiden Namen der Wettbewerbskategorie zu. Ein eigener Ausschlussfilter entfernt die Suchanfrage vollständig. Diese Schritte beantworten unterschiedliche Fragen und sind nicht austauschbar.
Die API kann includingRegex für die Marke mit excludingRegex für Wettbewerber in einer and-Gruppe kombinieren. Auch ein Diagramm kann Einschluss- und Ausschlussfilter verbinden. Dadurch ändern sich die Suchanfragen, die in die Berechnung von Anteilen und Vergleichen eingehen.
Die Feldbeschreibung sollte Musterversion, abgedeckte Sprachen und Priorität dokumentieren. Testanfragen sollten Marke plus Thema, fremde Wörter mit kurzen Schlüsselbegriffen, Großschreibung und fehlende Treffer abdecken. Weder ein bestandener Regex-Test noch eine vollständig abgerufene API-Seite beweist eine vollständige Erfassung der Suchnachfrage.
Quellen
- Search Analytics API: Anfrage, Anmeldung und Grenzen
- Täglicher Export und Zeilengrenzen
- Datenschutzfilter und Zusammenfassung von Daten
- Site Impression und URL Impression
- RE2 und Abgleich des vollständigen Feldwerts
- Search-Console-Filter und Vergleiche
- Leistungsbericht zur generativen KI
- Weltweite Einführung am 31. August 2026
- Historie und diagnostische Vergleiche
Passend dazu