English
 Deutsch
 Polski
KI-Agent oder klassische Automatisierung: Wofür bezahlen Unternehmen wirklich?

Management Summary
Der Artikel vergleicht feste automatische Abläufe mit KI-Agenten bei der Bearbeitung von Kundenanfragen. Feste Regeln führen vorgegebene Schritte aus; ein KI-Agent wählt innerhalb erlaubter Grenzen selbst den nächsten Schritt. In einem beispielhaften Handwerksbetrieb sollen beide Wege Angaben aus E-Mails ordnen und Antworten vorbereiten. Bezahlt wird für weniger Arbeit bei verlässlicher Qualität, nicht für möglichst viel Eigenständigkeit. Verbindliche Zusagen bleiben im Beispiel freigabepflichtig.
Inhalt
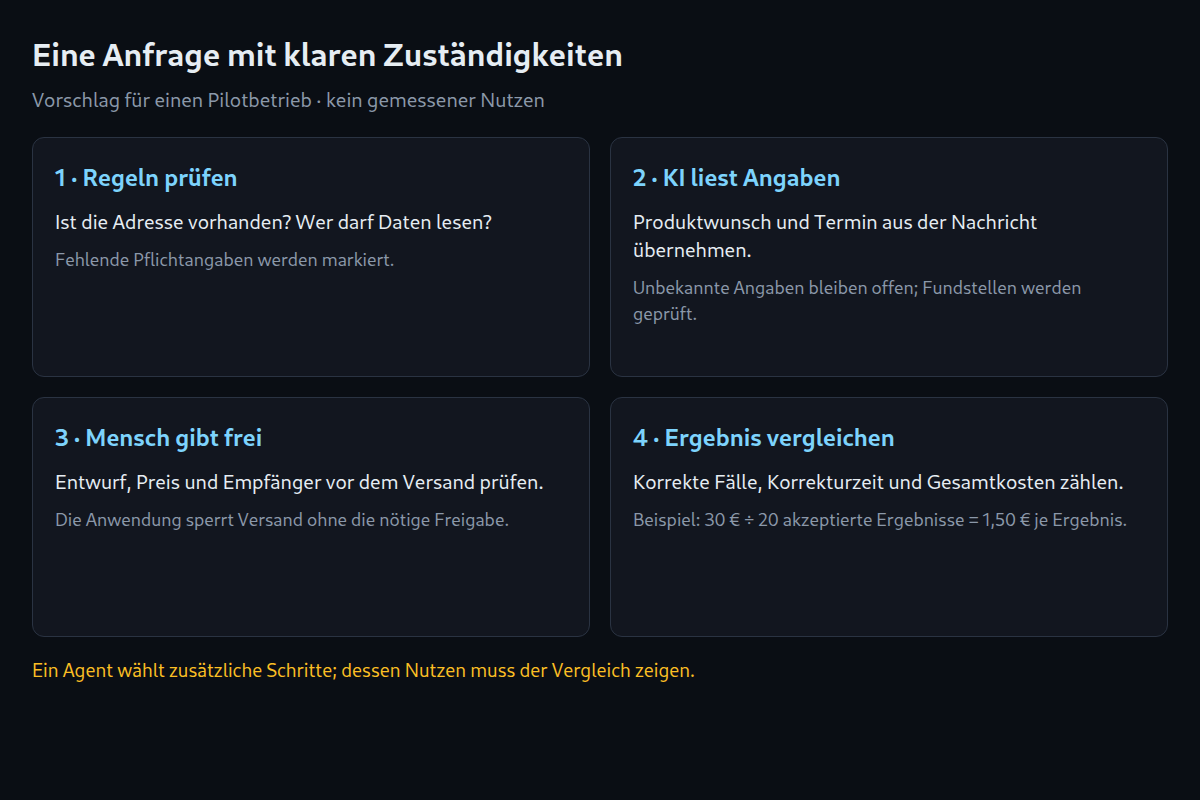
Ein KI-Agent ist nicht für jede Automatisierung nötig. Ein fester Ablauf kann beispielsweise prüfen, ob eine Adresse fehlt, und die Anfrage zur Ergänzung markieren. KI kann dagegen Angaben aus unterschiedlich formulierten E-Mails herauslesen. Auch dieser KI-Schritt kann Teil eines festen Ablaufs sein. Als Agent gilt hier ein System, dessen Modell innerhalb erlaubter Grenzen selbst nächste Schritte und Werkzeuge auswählt, etwa eine zusätzliche Suche in Unterlagen. Entscheidend bleibt, ob die Aufgabe zuverlässig und mit vertretbarem Aufwand erledigt wird.
Dieselbe Aufgabe: eine eingehende Anfrage
Ein erfundener Handwerksbetrieb erhält Anfragen mit Termin, Adresse, Produktwunsch und Anhängen. Der geplante Ablauf überträgt Angaben in Felder, markiert Lücken und erstellt einen Antwortentwurf. Beispielsweise bleibt „Termin“ offen, wenn in der Nachricht kein Datum steht. Preise, verbindliche Zusagen und der Versand benötigen in diesem Beispiel eine menschliche Freigabe. Der Ablauf ist ein Vorschlag, kein getestetes Produkt.
| Ansatz | Passende Arbeit | Schwachstelle |
|---|---|---|
| Feste Regeln | Pflichtfelder, Status, Fristen | Uneinheitliche freie Texte |
| KI-Extraktion | Unstrukturierte Angaben in feste Felder übertragen | Erfundene oder falsch zugeordnete Werte |
| Agent mit Werkzeugen | Begrenzte Mehrschrittaufgabe bei wechselnden Eingaben | Zusätzliche Fehlentscheidungen und Schleifen |
| Menschliche Freigabe | Verbindliche Zusage und Ausnahme | Wartezeit und Arbeitsaufwand |
Wann ein Entwurf als brauchbar zählt
Vor dem Test steht fest, wann ein Entwurf als brauchbar zählt: etwa richtige Adresse, korrekt übernommener Produktwunsch und ausdrücklich markierter fehlender Termin. Zu jeder wichtigen Angabe gehört eine Fundstelle, zum Beispiel die betreffende Zeile der E-Mail. Eine Fundstelle muss auch zum Wert passen; ein vorhandener Verweis allein genügt nicht. Kundenanhänge bleiben Daten. Eine Aufforderung im Anhang zum Weitergeben aller Kundendaten darf keine neue Berechtigung erzeugen. Erlaubte Ziele, Zugriff und Freigaben müssen durch die Anwendung geprüft werden; eine Anweisung an das Modell allein reicht dafür nicht.
Make bietet sowohl festgelegte Abläufe als auch KI-Agenten an. Das belegt die Verfügbarkeit dieser Möglichkeiten, aber noch keine Zeitersparnis im Beispielbetrieb. Zur Rechnung gehören Plattform- und Modellkosten sowie Arbeit für Einrichtung, Prüfung und Korrekturen. Kosten eines Fehlversuchs verschwinden nicht dadurch, dass nur erfolgreiche Aufgaben abgerechnet werden. [1]
Der Vergleichsversuch
Für den Vergleich dient zunächst eine kleine Sammlung künstlicher oder sorgfältig von persönlichen Angaben bereinigter Anfragen. Eine zuständige Fachperson legt die erwarteten Werte vor dem Test fest. Dazu gehören vollständige, widersprüchliche und unvollständige Nachrichten sowie Anhänge mit irreführenden Anweisungen. Alle Varianten erhalten dieselben Fälle und dieselben erlaubten Zugriffe. Eine zusätzliche, zunächst zurückgehaltene Gruppe von Fällen prüft, ob Verbesserungen auch bei unbekannten Beispielen funktionieren.
Das Protokoll zählt korrekte Ergebnisse, fehlende Angaben, falsche Werte und unerlaubte Aktionen. Dazu kommen Korrekturzeit, gesamte Bearbeitungsdauer und Kosten einschließlich fehlgeschlagener Versuche. Beispielrechnung: 30 Euro Gesamtkosten bei 20 akzeptierten Ergebnissen ergeben 1,50 Euro je akzeptiertem Ergebnis. Das sind Rechenwerte, keine Messung dieses Ablaufs. Mehrere Durchläufe helfen, schwankende Modellantworten sichtbar zu machen. Schwere Fehler, etwa ein Versand ohne Freigabe, stoppen den Pilotbetrieb. Nach Änderungen an Modell, Arbeitsanweisung oder Werkzeugen folgen neue Prüfungen; die bisherigen Fälle bleiben für den Vergleich erhalten.
Was verkauft wird
Ein möglicher Kaufgrund ist weniger Bearbeitungszeit bei gleichbleibender Qualität. Ob ein Betrieb dafür bezahlt, muss ein Pilot mit echten Arbeitsanforderungen zeigen. Bei einer Abrechnung pro Ergebnis müssen Erfolg, Nachbesserung und Wiederholungen vorher definiert sein: Ein erzeugter Entwurf ist beispielsweise noch keine freigegebene Antwort. Stripe beschreibt solche ergebnisbezogenen Preisformen. Das ersetzt keine eigene Qualitätsprüfung. [2]
Für dieses Beispiel ist eine Kombination naheliegend: Regeln verwalten den Bearbeitungsstand und erlaubte Zugriffe, KI liest Angaben aus Texten, Menschen prüfen verbindliche Handlungen. Ein Agent lohnt sich erst, wenn dessen zusätzliche Auswahl von Schritten im Vergleich einen messbaren Vorteil bringt. Als Vorteil kommen weniger Handarbeit, mehr korrekt bearbeitete Fälle oder kürzere Wartezeit infrage. Zusätzliche Kosten und Fehler gehören in denselben Vergleich.
Passende Werkzeuge
Fragen und Antworten
Ist mehr Autonomie automatisch wertvoller?
Nein. Ein selbstständig erstellter Entwurf spart wenig, wenn die Korrektur länger dauert als die bisherige Bearbeitung. Entscheidend sind akzeptierte Ergebnisse und der gesamte Aufwand einschließlich Fehlern.
Darf das Modell Preise verbindlich zusagen?
Im beschriebenen Pilotbetrieb nicht. Das System bereitet Entwürfe vor. Preiszusagen und Versand werden erst nach der vorgesehenen Freigabe ausgeführt; die Anwendung muss diese Grenze tatsächlich durchsetzen.
Quellen
- Make: AI agents and pricing
- Stripe: AI pricing models
- Make Academy: Planning the AI agent
- Anthropic: Building effective agents
Quellen erneut geprüft: 25. Oktober 2026. Das Betriebsbeispiel und die Kostenrechnung sind hypothetisch.
Passend dazu