English
 Deutsch
 Polski
meta_query in WP_Query: Joins, Indizes und Abfragekosten verstehen

Management Summary
WordPress kann Inhalte anhand zusätzlicher Angaben filtern, etwa nach Produkteigenschaften oder Zahlenwerten. Das ermöglicht flexible Übersichten, kann bei komplexen Filtern aber erhebliche Datenbankarbeit und langsame Seiten verursachen. Die passende Verbesserung hängt davon ab, wie die Website tatsächlich sucht und sortiert. Schnellere Suchstrukturen oder wiederverwendete Ergebnisse können helfen; besonders häufige Filter benötigen gegebenenfalls eine andere Datenablage. Die gewünschte Auswahl muss dabei erhalten bleiben.
Inhalt
Ein Filter mit drei individuellen Feldern kann drei Joins auf wp_postmeta erzeugen. Ein Join verknüpft Tabellenzeilen; ein Alias gibt einer Verwendung derselben Tabelle einen eigenen Namen. Die Anzahl hängt von den Bedingungen und deren Verknüpfung ab, nicht allein von der Zahl der Felder.
Metadaten speichern zusätzliche Angaben zu einem Beitrag, meist als Feldname und Wert. WP_Query erstellt WordPress-Beitragsabfragen; SQL ist die Abfragesprache der Datenbank. Ein Index ist eine zusätzliche Suchstruktur, die passende Zeilen schneller finden kann. Ein Cache hält frühere Ergebnisse zur Wiederverwendung bereit.
Entscheidend ist der Aufwand der tatsächlichen Abfrage. Datenverteilung, Indizes, Ergebnismenge, Sortierung und Cachetreffer beeinflussen die Kosten. Eine große Metadatentabelle ist ein Anlass zur Messung, noch kein Beweis für langsame Filter.
Was WP_Query aus dem Array erzeugt
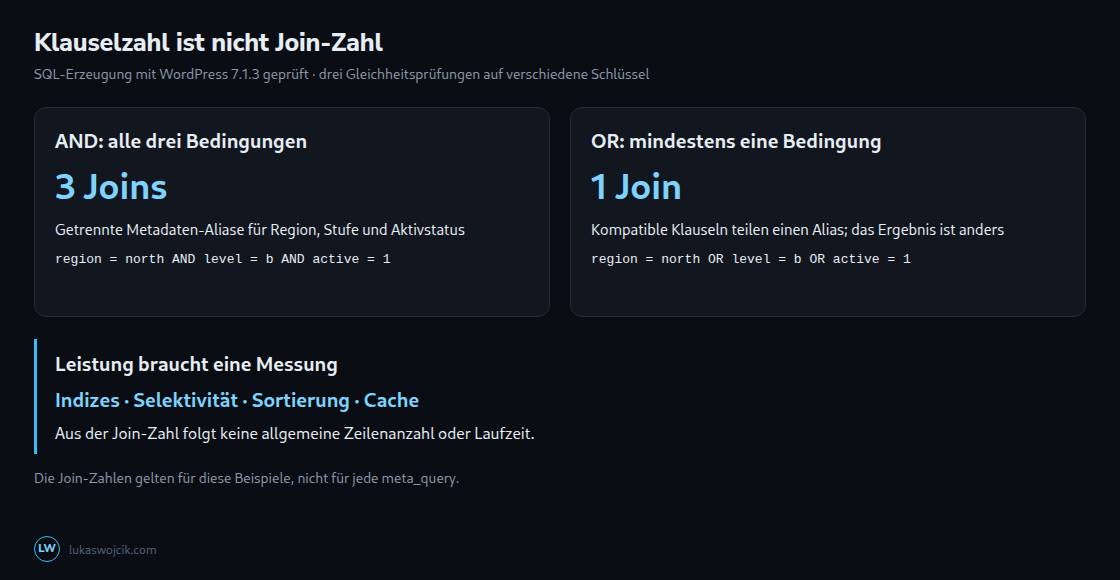
Drei Gleichheitsprüfungen auf unterschiedliche Schlüssel mit AND erzeugen normalerweise drei Metadaten-Aliase. Kompatible Klauseln derselben Gruppe können einen Alias teilen: Dieselben drei Prüfungen mit OR benötigen im geprüften WordPress-Core 7.1.3 einen Join. Damit ändert sich jedoch die Bedeutung von „alle Bedingungen“ zu „mindestens eine Bedingung“. AND durch OR zu ersetzen ist daher keine zulässige Leistungsoptimierung. Das folgende SQL zeigt den AND-Fall vereinfacht mit lesbaren Aliasnamen.
SELECT wp_posts.ID FROM wp_posts
  INNER JOIN wp_postmeta pm1 ON wp_posts.ID = pm1.post_id
  INNER JOIN wp_postmeta pm2 ON wp_posts.ID = pm2.post_id
  INNER JOIN wp_postmeta pm3 ON wp_posts.ID = pm3.post_id
WHERE post_type = 'post' AND post_status = 'publish'
  AND ( pm1.meta_key = '_region' AND pm1.meta_value = 'nord' )
  AND ( pm2.meta_key = '_stufe'  AND pm2.meta_value = 'b' )
  AND ( pm3.meta_key = '_aktiv'  AND pm3.meta_value = '1' )
GROUP BY wp_posts.ID
ORDER BY wp_posts.post_date DESC
Das Beispiel enthält drei Joins und einschließlich wp_posts vier Tabellenreferenzen. Die Gruppierung nach Beitrags-ID verhindert doppelte IDs bei mehreren passenden Metadatenzeilen. Weder SQL-Text noch Klauselzahl belegen 500.000 gelesene Zeilen für 40 Ergebnisse. Dafür wären ein reproduzierbarer Datenbestand und ein Ausführungsplan erforderlich.
Standardindizes und mögliche Ergänzungen
Ein Primärschlüssel kennzeichnet eine Tabellenzeile eindeutig. Ein Präfixindex speichert nur den Anfang eines Textwerts. Der Datenbankoptimierer wählt Zugriffswege und Join-Reihenfolge; ein Ausführungsplan beschreibt diese Auswahl.
Das WordPress-Standardschema enthält den Primärschlüssel auf meta_id, einen Index auf post_id und einen Präfixindex auf meta_key mit üblicher Grenze von 191 Zeichen. Core legt keinen Index auf meta_value an. LONGTEXT erlaubt durchaus Präfixindizes. Ein zusätzlicher passender Index kann einzelne Abfragen verbessern; Werteverteilung, Schlüssellängen, Schreibkosten und Datenbankversion gehören jedoch zur Prüfung.
Der Optimierer kann bei Beiträgen oder einem Metadatenschlüssel beginnen, der die Ergebnismenge stark eingrenzt. Der Zugriff über post_id ist ein möglicher Plan, keine feste Reihenfolge. Wichtig sind passende Zeilen je Zugriff und der nach einer Bedingung verbleibende Anteil. Eine allgemeine Mindestzahl von 30 Metadatenzeilen je Beitrag gibt es nicht.
Operatoren und mögliche Kosten
| Klausel | Möglicher Aufwand |
|---|---|
'compare' => '=' | Zeichenkettenvergleich; mögliche Join-Wiederverwendung hängt von den übrigen Klauseln ab. |
'compare' => 'LIKE' | WordPress ergänzt %…% und sucht damit an beliebiger Stelle im Text. Eine gewöhnliche Indexsuche über den Wertanfang passt nicht, Indizes für andere Bedingungen können weiterhin helfen. |
'type' => 'NUMERIC' | Wandelt den Text mit CAST(… AS SIGNED) in eine ganze Zahl mit Vorzeichen um; ein Textwertindex bedient diesen Zahlenausdruck nicht direkt. Andere Indizes bleiben nutzbar. |
'compare' => 'NOT EXISTS' | Prüfung auf fehlenden Schlüssel über LEFT JOIN und IS NULL; indizierte Zugriffe und früher Abbruch können helfen. |
'relation' => 'OR' | Mindestens eine Bedingung muss passen; kompatible Klauseln können einen Join teilen. |
'orderby' => 'meta_value' | Kann zusätzliche Sortierung benötigen; Speicher-, Platten- und Temporärtabellenbedarf hängen vom Plan ab. |
Using filesort bedeutet eine zusätzliche Sortierung statt Nutzung der Indexreihenfolge. Trotz des Namens kann die Sortierung im Arbeitsspeicher bleiben. Plattenzugriffe hängen von Ergebnismenge, Einstellungen und Datenbankimplementierung ab. Using temporary bedeutet, dass bei der Verarbeitung eine vorübergehende Tabelle verwendet wird. Beide Angaben allein beweisen weder eine Zeitüberschreitung noch einen notwendigen Umbau.
Ein LEFT JOIN behält den Beitrag auch ohne passende Metadatenzeile im Zwischenergebnis. IS NULL wählt anschließend Beiträge ohne diesen Treffer aus. Ein fehlender Schlüssel lässt sich über LEFT JOIN und IS NULL feststellen. Ein Index kann die Suche nach einem Treffer beschleunigen; nach einem ausschließenden Treffer kann der Optimierer die weitere Suche für diesen Kandidaten beenden. Die Behauptung, Indizes könnten beim Nachweis fehlender Werte nicht helfen, ist deshalb falsch. Entscheidend bleiben der verwendete WordPress-Operator und das erzeugte SQL.
Metadaten, Taxonomie oder eigene Tabelle
Taxonomien eignen sich für gemeinsame Einordnungen wie Regionen oder Produktgruppen. Die Standardtabelle für Zuordnungen hat einen zusammengesetzten Primärschlüssel auf (object_id, term_taxonomy_id), einen zusätzlichen Index auf term_taxonomy_id und die weitere Spalte term_order. Auch Taxonomieabfragen können mehrere Joins oder Unterabfragen benötigen. Der Tabellenname garantiert keine Beschleunigung.
Metadaten bleiben für viele kleine oder selten genutzte Filter angemessen. Häufig abgefragte Zahlenbereiche und sortierte Werte können von einer eigenen Tabelle mit passenden Datentypen und Indizes profitieren. Datenmodell und Messung sollten die Entscheidung bestimmen. Das spätere Lesen von Metadaten kann aus einem Objektcache oder einer Sammelabfrage erfolgen; ein einzelner SQL-Zugriff je Feld ist kein allgemeines Kostenmodell.
Messen statt schätzen
Nach einem gewöhnlichen Aufruf von WP_Query enthält $query->request das erzeugte SQL; die Abfrage kann dann bereits ausgeführt worden sein. Der Filter posts_request liegt vor dem Versand der Hauptabfrage. Ein einfaches EXPLAIN des vollständigen SELECT liefert einen geschätzten Plan, keine gemessene Laufzeit. Datenbankspezifische Analysebefehle mit Ausführung starten die Abfrage tatsächlich und gehören auf eine geeignete Testkopie.
EXPLAIN: geschätzter Plan
key       gewählter Index
rows      geschätzte untersuchte Zeilen
filtered  geschätzter verbleibender Prozentsatz (MySQL)
Extra     zusätzliche Operationen
rows ist eine Schätzung; MySQLs filtered schätzt den nach einer Bedingung verbleibenden Prozentsatz. Join-Reihenfolge und verbleibende Zwischenergebnisse zählen mit. Das Produkt aller rows-Werte oder ein fixer Zuschlag je Join belegt keine tatsächlich gelesene Gesamtzeilenzahl. Ein belastbarer Vergleich hält Datenbankversion, Schema, Indizes, repräsentative Daten, Abfrageparameter und Laufzeiten ohne vorhandene Zwischenergebnisse (kalter Cache) und mit wiederverwendbaren Ergebnissen (warmer Cache) fest.
Fragen und Antworten
Macht ein Unterstrich vor dem Schlüssel, wie bei _region, die Abfrage schneller?
Nein. WordPress behandelt Metadatenschlüssel mit führendem Unterstrich normalerweise als geschützt und blendet diese im klassischen Feldeditor aus; Filter können das Verhalten ändern. Das ist eine Anwendungskonvention, keine Datenbankberechtigung und keine besondere Indexfunktion.
Hilft ein persistenter Objektcache gegen eine teure meta_query?
Ein Cachetreffer kann die Hauptabfrage tatsächlich einsparen. Seit WordPress 6.1 gibt es Ergebnis-Caching für WP_Query; ein persistenter Objektcache bewahrt Ergebnisse auch für spätere Webanfragen auf. Entscheidend bleiben die Cache-Eignung der Abfrage, die Einstellung cache_results, das Entfernen von Cacheeinträgen und das Ungültigmachen veralteter Ergebnisse. Wenn WordPress Beitrags-Caches als veraltet kennzeichnet, ändert sich eine gemeinsame Versionsmarkierung. Dadurch können auch gespeicherte Abfrageergebnisse über den bearbeiteten Beitrag hinaus ungültig werden. Direkte SQL-Änderungen können dagegen veraltete Cacheinhalte hinterlassen.
Drei unabhängige Filter mit je fünf auswählbaren Werten ergeben 125 Kombinationen, wenn alle drei gesetzt sind. Berechnet werden müssen nur tatsächlich angefragte Kombinationen; häufige Kombinationen können eine hohe Trefferrate erreichen. Regelmäßige Änderungen verringern möglicherweise die Wiederverwendung, machen Caching jedoch nicht automatisch nutzlos.
Kalte und warme Laufzeiten sind beide relevant. Der Abfrageplan erklärt mögliche Kosten eines Cachefehlers; reale Aufrufe und Trefferraten zeigen deren Häufigkeit. Ein Seitencache hängt zusätzlich von der Behandlung der Seitenadresse und ihrer Abfrageparameter, dem Ungültigmachen veralteter Ergebnisse und der Konfiguration ab. Cacheeinsatz und Schemaumbau sollten auf Messungen statt auf einem unbelegten Extrembeispiel beruhen.
Passend dazu