

 English
 Deutsch
 Polski
Rachunek stojący za fakturą za LLM

Management Summary
Usługi modeli językowych często naliczają opłaty za przetworzony i wygenerowany tekst w małych jednostkach zwanych tokenami. Rozmowa może kosztować więcej niż sama końcowa odpowiedź, ponieważ wcześniejsze wiadomości bywają przetwarzane ponownie, a część pracy pozostaje niewidoczna. Ma to znaczenie przy planowaniu budżetu asystentów AI i automatycznych zadań. Krótsza potrzebna historia, ponowne użycie wejścia i grupowanie mniej pilnych zadań mogą obniżyć koszt. Oszczędność zależy od usługi i jakości odpowiedzi.
Spis treści
Interfejsy modeli językowych rozliczane tokenowo zwykle naliczają zużycie każdego żądania. Koszt rozmowy jest sumą kosztów tych żądań. Ponowne użycie historii sprawia, że wcześniejsze pytanie może wielokrotnie liczyć się jako wejście; nie istnieje ogólna stała opłata za rozmowę.
LLM to model językowy generujący tekst. API pozwala programom wysyłać żądania do modelu. Wejście obejmuje przekazane treści, a wyjście powstaje w modelu. Prompt zawiera instrukcję i kontekst. Pamięć podręczna tymczasowo zachowuje wyniki przetwarzania wcześniejszego wejścia do ponownego użycia: zapis tworzy lub rozszerza wpis, a odczyt korzysta z istniejącego wpisu.
Użyteczny szacunek oddziela zwykłe wejście, zapis i odczyt pamięci podręcznej oraz wyjście, a następnie dolicza ewentualne opłaty za narzędzia lub usługi. Poniższy przykład dotyczy rozmowy tekstowej o stałych długościach wiadomości. To model obliczeniowy, nie faktura dostawcy ani uniwersalny cennik.
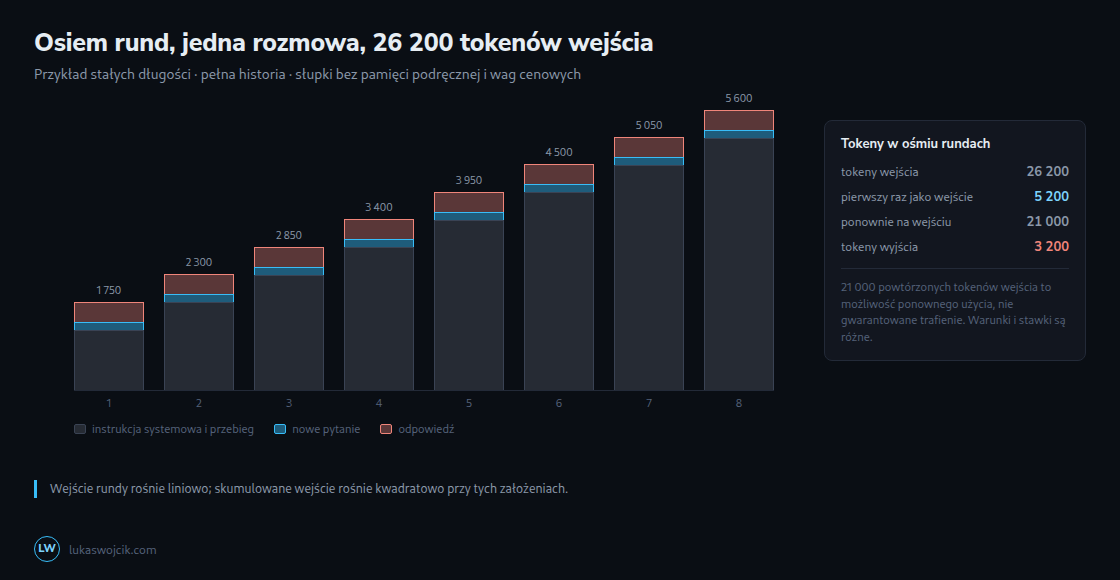
Dlaczego pełna historia zwiększa skumulowane wejście
API może wymagać ponownego przesłania historii albo zarządzać stanem rozmowy na serwerze. Żadne rozwiązanie nie czyni ponownie używanego kontekstu automatycznie bezpłatnym. Poniższy przykład zakłada pełną wcześniejszą historię w każdym żądaniu, bez streszczania, skracania lub wybierania fragmentów.
Instrukcja systemowa określa ogólne zasady aplikacji i ma 1200 tokenów, każde pytanie 150, a każda odpowiedź 400. Tokenizer dzieli tekst na jednostki zwane tokenami. Mogą to być słowa, fragmenty słów lub znaki interpunkcyjne. Token nie odpowiada stałej liczbie słów. Uproszczenie pomija formatowanie wiadomości, definicje narzędzi, niewidoczne elementy formatu i tokeny rozumowania używane do wewnętrznego przetwarzania przed widoczną odpowiedzią. Wejście rundy n wynosi 1350 + 550 × (n − 1).
| Runda | Wejście tej rundy | Skumulowane tokeny wejścia |
|---|---|---|
| 1 | 1 350 | 1 350 |
| 2 | 1 900 | 3 250 |
| 3 | 2 450 | 5 700 |
| 4 | 3 000 | 8 700 |
| 5 | 3 550 | 12 250 |
| 6 | 4 100 | 16 350 |
| 7 | 4 650 | 21 000 |
| 8 | 5 200 | 26 200 |
Po ośmiu rundach skumulowane wejście wynosi 26 200 tokenów. Ósme żądanie zawiera 5200 tokenów wejścia; po dodaniu ostatniej odpowiedzi o długości 400 tokenów rozmowa ma 5600 tokenów wraz z instrukcją systemową. Osiem odpowiedzi daje dodatkowo 3200 tokenów wyjścia. Tabela liczy wejście, nie pieniądze ani łączne wejście i wyjście.
Ze skumulowanego wejścia 21 000 tokenów powtarza wcześniejsze wejście, czyli około 80%. Krótsze powtarzane instrukcje lub krótsza przechowywana historia mogą ograniczyć późniejsze wejście. Streszczenie może jednak wymagać osobnego płatnego wywołania i utracić szczegóły. Porównanie powinno uwzględniać ten koszt oraz jakość późniejszych odpowiedzi.
Przykładowe stawki zamiast uniwersalnego cennika
| Rodzaj | Stosunek | Założenie |
|---|---|---|
| Wejście | 1× | Przykładowa stawka odniesienia |
| Wyjście | 5× | Przykładowy mnożnik, nie uniwersalna proporcja |
| Odczyt pamięci | 0,1× | Przykład: ponowne użycie kwalifikowanego początku w czasie ważności |
| Zapis pamięci | 1,25× | Przykładowa pełna stawka zapisu, nie dodatkowy narzut 1,25× |
| Wsad | 0,5× | Przykładowy rabat; konieczna zgodność modelu, endpointu i warunków |
Dokumentacja sprawdzona 24 października 2026 r.: Warunki pamięci zależą od dostawcy i modelu. Claude dokumentuje warianty 5 minut i 1 godziny; OpenAI GPT-5.6 i nowsze używają w Responses wariantów 30 minut i 12 godzin. Stawki odczytu także się różnią. Poniższa kalkulacja celowo zachowuje stałe stawki przykładowe; rzeczywisty budżet wymaga aktualnych cen i kategorii zużycia wybranego modelu.
Tabela używa przykładowych mnożników ze zwykłym wejściem równym 1. Zgodny początek promptu otrzymuje cenę odczytu tylko po spełnieniu reguł modelu dotyczących kwalifikacji, minimalnej długości, punktów zapisu i czasu ważności. Zmieniona godzina może przerwać ponowne użycie od miejsca zmiany, pozostawiając wcześniejszy stały początek dostępny. Niektórzy dostawcy pozwalają wskazać punkt zapisu na końcu części wejścia przeznaczonej do ponownego użycia. Inni zarządzają pamięcią podręczną automatycznie. JSON jest formatem uporządkowanych danych żądania. Identyczny tekst JSON nie stanowi uniwersalnej reguły rozliczenia.
Przy mnożniku zapisu 1,25 i odczytu 0,1 jeden zapis oraz jedno pełne ponowne użycie kosztują 1,35 zamiast 2: oszczędność wynosi 32,5%. Dwa lub trzy trafienia nie są konieczne. Krótki początek może nie osiągnąć minimum modelu, a wygasły wpis może wymagać ponownego zapisu. Opłacalność zależy od ponownego użycia i taryfy, nie tylko od długości promptu.
Przetwarzanie wsadowe i terminy
Tryb wsadowy przesyła grupę zadań razem. Usługa przetwarza je w tle i udostępnia wyniki później. OpenAI dokumentuje rabat 50% i okno realizacji 24 godzin; nieukończone żądania mogą wygasnąć. Anthropic również opisuje rabat i wygaśnięcie po 24 godzinach, często z wcześniejszym zakończeniem. Wsad nie oznacza zatem ani natychmiastowej odpowiedzi, ani nieograniczonego oczekiwania bez określonego okna.
Przykłady to niezależne klasyfikacje, opisy katalogowe i odczytywanie pól dokumentów. Przydatność zależy od terminów, obsługiwanych modeli, endpointów i funkcji, limitów danych oraz obsługi ponowień. Obserwowanie ekranu nie jest kryterium rozliczenia. Zadania zależne od wcześniejszych wyników mogą wymagać oddzielnych etapów, ponieważ późniejsze wejścia nie są jeszcze dostępne.
Pomiar tokenów dla każdego języka
Tokenizacja zależy od słownika modelu, języka, interpunkcji i treści. Reguła czterech znaków na token to przybliżenie dla tekstu angielskiego, nie wiarygodny przelicznik dla polskiego lub niemieckiego. Tłumaczenie może wymagać większej albo mniejszej liczby tokenów zależnie od tokenizera i sformułowania.
Nie wynika z tego stała dopłata językowa 30–50%. Reprezentatywne wejścia i odpowiedzi wymagają osobnego policzenia dla każdego języka za pomocą tokenizera lub endpointu zliczania tokenów danego modelu. Pola rzeczywistego zużycia pokazują następnie rozliczone kategorie. Różna liczba tokenów to coś innego niż różna cena tokena.
Ograniczanie wyjścia i rozumowania
Limity wyjścia zapewniają rzeczywistą kontrolę: parametr danego API określa górną granicę, choć nie długość docelową. Nazwy różnią się, na przykład max_tokens w Claude Messages i max_output_tokens w OpenAI Responses. Niski limit może uciąć odpowiedź lub zostać wyczerpany przez rozumowanie przed pojawieniem się tekstu. Zwięzłe instrukcje oraz obsługiwane ustawienia wysiłku lub szczegółowości dotyczą innych aspektów.
JSON nie jest z definicji tańszy od prozy: nazwy pól, interpunkcja i schemat mogą dodawać tokeny. Zwięzły format wymaga porównania z równie informacyjną alternatywą. Przy rozliczaniu rozumowania jako wyjścia 2000 rozliczonych tokenów rozumowania i 40 widocznych tokenów odpowiedzi daje 2040 tokenów wyjścia, jeśli brak innych rozliczonych tokenów wyjściowych. O opłacie decyduje zgłoszone zużycie, nie sam widoczny tekst.
Pytania i odpowiedzi
Ile zaoszczędziłaby pamięć podręczna w rozmowie z pierwszej tabeli?
Przy podanych mnożnikach idealizowany przykład pamięci podręcznej obniża koszt wejścia o około 67,2%. Zakłada pełną kwalifikację promptów, ponowne użycie całego poprzedniego żądania i nadal ważne wpisy. Każde rozszerzenie dodaje poprzednią odpowiedź o długości 400 tokenów i kolejne pytanie o długości 150 tokenów. Rzeczywiste minima, punkty zapisu i braki trafień mogą zmienić wynik.
Poniższe obliczenie używa jednostek ceny. Jedna jednostka odpowiada cenie zwykłego tokena wejściowego. Nie są to rzeczywiste liczby tokenów ani kwoty pieniężne. Pomnożenie przez zwykłą cenę jednego tokena wejściowego daje koszt:
- Runda 1 zapisuje 1350 tokenów po cenie zapisu: 1350 × 1,25 = 1687,5.
- Rundy od 2 do 8 odczytują łącznie 21 000 tokenów, dokładnie tę część, którą model już raz dostał: 21 000 × 0,1 = 2100.
- Te same rundy zapisują siedem razy po 550 tokenów: 3850 × 1,25 = 4812,5.
Suma wynosi 8600 zamiast 26 200 jednostek ceny. Przy przykładowym mnożniku wyjścia 5 dochodzi po 16 000 za 3200 tokenów wyjścia: łącznie 24 600 zamiast 42 200, czyli około 41,7% oszczędności. Wygaśnięcie lub zmiana początku promptu może zmniejszyć ponowne użycie; wcześniejszy niezmieniony fragment może nadal się kwalifikować. Koszt streszczania i innych usług nie jest uwzględniony.
Czy przy jeszcze dłuższych rozmowach proporcja staje się jeszcze gorsza?
Przy pełnej historii i stałych długościach 16 rund daje 87 600 tokenów wejścia, około 3,34 raza więcej niż osiem rund. Ogólny wzór to 1350n + 550n(n − 1)/2. Wzór zawiera składnik rosnący z kwadratem liczby rund: każde kolejne żądanie powtarza więcej historii. Dotyczy to tego modelu z nieograniczoną historią, nie każdej aplikacji. Pamięć podręczna, granice kontekstu, streszczanie i wybór fragmentów historii zmieniają rzeczywistą krzywą kosztu.
Powiązane artykuły


