English
 Deutsch
 Polski
Tutorial: Migracja analityki e-commerce z Client-Side na Server-Side GTM

Spis treści
- Krok 1: Uruchomić obie, przełączyć później
- Krok 2: Postawienie serwera tagującego
- Krok 3: Klient GA4
- Krok 4: Skierowanie kontenera webowego na serwer
- Krok 5: Przeniesienie zakupu poza przeglądarkę
- Krok 6: Porównanie przed wyłączeniem czegokolwiek
- Pozostając w granicach
- Pytania i odpowiedzi
- Źródła
- Kontrola w praktyce: uzgodnienie zamówień z eksportem sklepu
- Przygotowanie pliku CSV Analytics w BigQuery
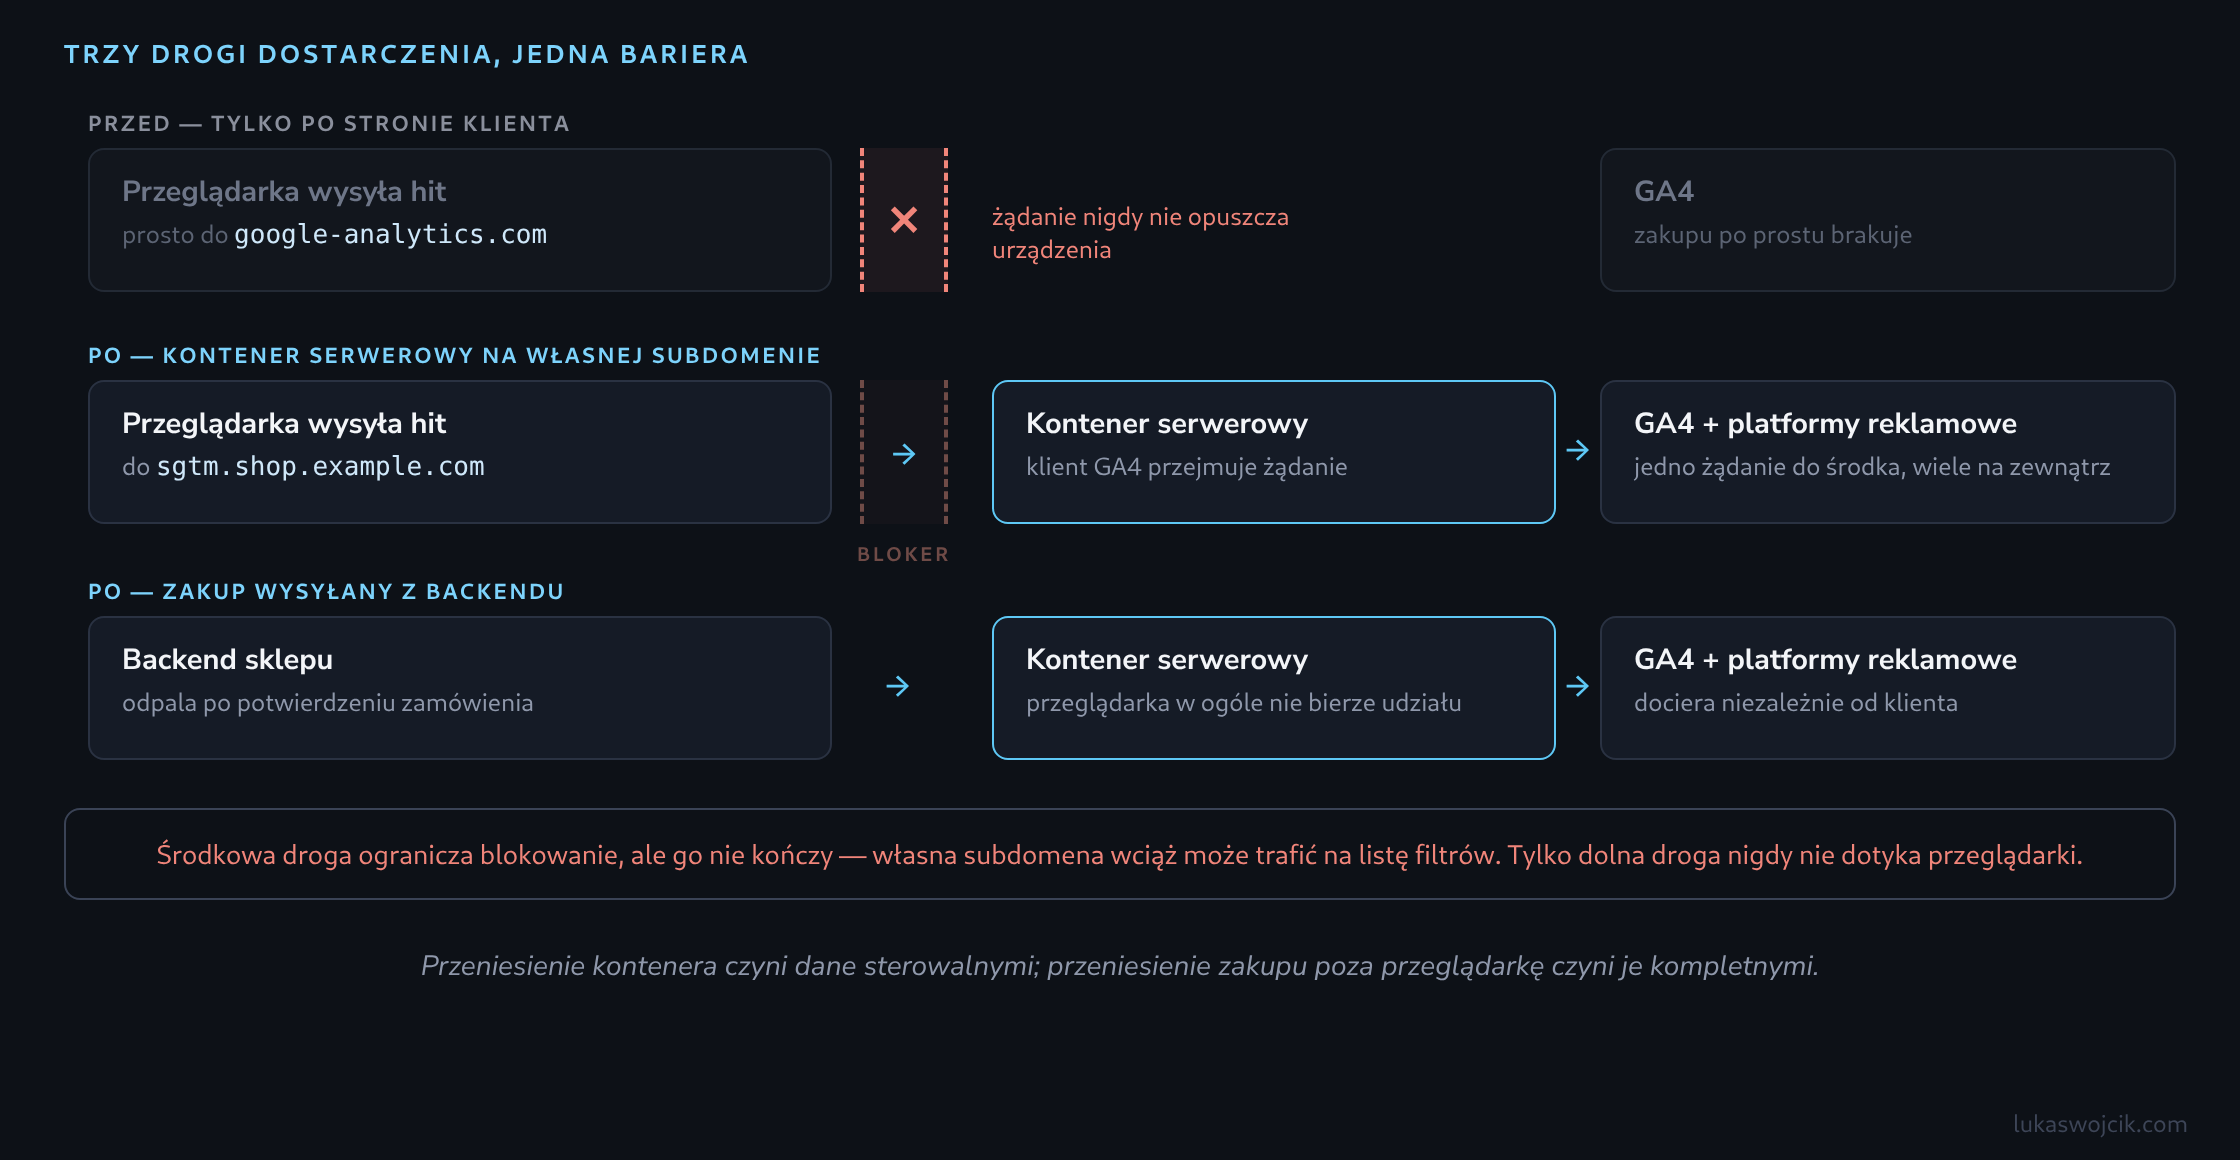
Każdy sklep ze śledzeniem po stronie klienta raportuje mniej zakupów, niż faktycznie realizuje. Ta luka nie jest błędem do wytropienia: żądania do znanych hostów analitycznych figurują na listach filtrów, ochrona przed śledzeniem skraca życie identyfikującego ciasteczka, a osoba zamykająca kartę, zanim strona potwierdzenia skończy się renderować, w ogóle nie wysyła zdarzenia. Kontener serwerowy zmienia to, którędy biegną dane, i pokrywa tym część problemu — przeniesienie zdarzenia zakupu poza przeglądarkę pokrywa resztę.
Poniższy przewodnik traktuje to jako migrację, a nie budowę od zera: dotychczasowa konfiguracja client-side pozostaje aktywna przez cały czas, obie działają równolegle wystarczająco długo, by dało się je porównać, a przełączenie następuje dopiero wtedy, gdy uzasadniają je liczby.
Krok 1: Uruchomić obie, przełączyć później
Najbezpieczniejsza kolejność wysyła dane do kontenera serwerowego, podczas gdy konfiguracja client-side nadal raportuje do tej samej albo do równoległej usługi. Nic nie jest usuwane, żadne tagi nie są wstrzymywane, a porównanie działa na realnym ruchu, a nie w trybie podglądu.
Druga usługa GA4 jako cel migracji utrzymuje produkcyjne liczby w czystości na czas nakładania się — zdublowany zbiór danych w usłudze produkcyjnej trudniej później rozplątać, niż wyrzucić tymczasową drugą usługę. Dwa do czterech tygodni nakładania obejmuje wzorce dni roboczych i weekendów oraz co najmniej jeden pełny cykl zakupowy.
Krok 2: Postawienie serwera tagującego
W interfejsie GTM kontener serwerowy powstaje jako osobny typ kontenera, a jego ustawienia oferują automatyczne udostępnienie w Google Cloud Run. Droga automatyczna jest wygodna i daje działające wdrożenie; ręczne wdrożenie tego samego publicznego obrazu daje większą kontrolę nad regionem i skalowaniem:
gcloud run deploy sgtm \
  --image=gcr.io/cloud-tagging-10302018/gtm-cloud-image:stable \
  --region=europe-central2 \
  --platform=managed \
  --allow-unauthenticated \
  --set-env-vars=CONTAINER_CONFIG='<config string z ustawien kontenera>'
Domyślne ustawienia są skrojone pod testy, a nie pod ruch produkcyjny; flagi instancji i pamięci to ta część, do której warto wrócić, gdy pojawi się realny wolumen. Każde środowisko uruchomieniowe kontenerów sprawdzi się tak samo — Cloud Run jest udokumentowanym domyślnym wyborem, a nie wymogiem.
Tym, co nie jest opcjonalne, jest nazwa hosta. Serwer tagujący dostępny wyłącznie pod wygenerowanym adresem chmurowym jest hostem zewnętrznym jak każdy inny; korzyść z kontekstu first-party pojawia się dopiero, gdy odpowiada on na subdomenie własnej domeny sklepu, na przykład sgtm.shop.example.com, ze wskazującym na usługę wpisem DNS i przypisanym certyfikatem.
Krok 3: Klient GA4
Kontener serwerowy nie robi nic, dopóki jakiś klient nie przejmie przychodzących żądań. Wbudowany klient GA4 nasłuchuje na ścieżkach używanych przez tag Google, rozbiera przychodzący hit i zamienia go w zdarzenie, które mogą odczytać tagi serwerowe — bez niego kontener przyjmuje żądania i je odrzuca.
Dwa ustawienia zasługują na decyzję zamiast wartości domyślnej. Klient może przejąć wystawianie identyfikującego ciasteczka zamiast zostawiać to JavaScriptowi — i to właśnie czyni to ciasteczko odpornym na ograniczenia przeglądarek — a włączenie tego bez towarzyszącej opcji migracji resetuje tożsamość każdego powracającego odwiedzającego, więc należy to do osobnej zmiany z własną weryfikacją. Drugie dotyczy ścieżek: pozostawienie domyślnych ścieżek bez zmian jest tym, co pozwala kontenerowi webowemu wysyłać hity bez konfigurowania własnego endpointu.
Krok 4: Skierowanie kontenera webowego na serwer
Po stronie przeglądarki ruch przekierowuje jedno pole. W tagu Google w kontenerze webowym adres kontenera serwerowego ustawia się jako parametr konfiguracji; w czystej implementacji gtag.js odpowiednikiem jest transport_url:
// Parametr konfiguracji tagu Google (kontener webowy)
server_container_url: 'https://sgtm.shop.example.com'

// Odpowiednik w czystej implementacji gtag.js
gtag('config', 'G-XXXXXXXXXX', {
  server_container_url: 'https://sgtm.shop.example.com'
});
Od tego momentu przeglądarka adresuje własną subdomenę sklepu, a kontener serwerowy przekazuje dane do GA4. Kontener serwerowy ma własny tryb podglądu, pokazujący przychodzące żądanie, klienta, który je przejął, oraz każdy odpalony z niego tag — to miejsce, w którym źle skierowany hit staje się widoczny natychmiast, a nie dobę później w raportach.
Krok 5: Przeniesienie zakupu poza przeglądarkę
Kierowanie ruchu przez własną subdomenę ogranicza blokowanie; nie kończy go, a wobec odwiedzającego, który nigdy nie dociera do strony potwierdzenia, nie pomaga wcale. Dopiero zdarzenie wysłane przez backend, po potwierdzeniu zamówienia w systemie sklepu, jest całkowicie niezależne od przeglądarki.
To żądanie potrzebuje identyfikatorów, które znajdują się w przeglądarce. Client id z ciasteczka analityki trzeba odczytać w checkoucie i zapisać przy zamówieniu razem z identyfikatorem sesji, inaczej zakup dotrze bez sesji, do której mógłby się przypiąć, i wyląduje w raportach jako ruch bez źródła:
POST https://sgtm.shop.example.com/g/collect

v=2
&tid=G-XXXXXXXXXX
&cid=1234567890.1690000000     // odczytane w checkoucie z ciasteczka analityki
&sid=1789000000                // identyfikator sesji z tej samej wizyty
&en=purchase
&ep.transaction_id=ORD-10432
&epn.value=149.00
&ep.currency=PLN
Jeśli ten sam zakup jest wysyłany zarówno z przeglądarki, jak i z backendu, identyfikator transakcji musi być zgodny, żeby duplikat dało się rozpoznać i usunąć dalej w łańcuchu — alternatywą jest sklep, którego dane o przychodzie są zawyżone dokładnie o te zdarzenia, które migracja miała odzyskać.
Krok 6: Porównanie przed wyłączeniem czegokolwiek
Porównanie rozstrzygające o przełączeniu nie brzmi client-side kontra server-side, tylko każde z nich kontra liczba zamówień w sklepie. Konfiguracja serwerowa raportująca więcej zakupów niż wcześniej jest poprawą tylko wtedy, gdy dodatkowe zakupy odpowiadają realnym zamówieniom — a tabela zamówień jest punktem odniesienia, który to rozstrzyga.
Typowe obserwacje w okresie nakładania: liczby zakupów rosną o margines silnie zależny od odbiorców i miksu urządzeń, sesje zyskują na długości, bo identyfikujące ciasteczko żyje dłużej, a kilka tagów okazuje się zależnych od zmiennych dostępnych wyłącznie w przeglądarce, których kontener serwerowy nie ma. To właśnie te tagi są właściwą pracą migracyjną; sam kontener jest częścią łatwą.
Pozostając w granicach
Kontener serwerowy przenosi przetwarzanie, a nie obowiązek. Stan zgody musi podróżować razem z żądaniem i zostać oceniony, zanim odpali jakikolwiek tag, oraz musi być zapisany przy zamówieniu, żeby zdarzenie backendowe również mogło go sprawdzić — żądanie wysłane z serwera nie jest zwolnione dlatego, że przeglądarka przestała brać udział. Kontener staje się też systemem z bieżącymi kosztami i dostępnością, od której zależy teraz raportowanie, a wystawiane przez niego identyfikujące ciasteczko pozostaje danymi osobowymi na tych samych zasadach co wcześniej, tylko ustawianymi z innego miejsca.
Pytania i odpowiedzi
Czy po każdej publikacji kontenera serwerowego serwer tagujący trzeba wdrażać od nowa?
Nie. Ciąg konfiguracyjny w CONTAINER_CONFIG wiąże usługę z kontenerem, nie z konkretną wersją; serwer tagujący sam pobiera aktualnie opublikowaną wersję. Ponowne wdrożenie jest potrzebne tylko wtedy, gdy ma działać nowszy obraz: Cloud Run przy wdrożeniu wiąże gtm-cloud-image:stable z jedną, stałą wersją obrazu, a nowsza zostaje uruchomiona dopiero przy następnym gcloud run deploy.
Czego potrzebuje tryb podglądu kontenera serwerowego przy wdrożeniu ręcznym?
Osobnej usługi. Przy wdrożeniu ręcznym najpierw powstaje serwer podglądu z tego samego obrazu, z RUN_AS_PREVIEW_SERVER=true i co najwyżej jedną instancją, a potem serwer tagujący, któremu PREVIEW_SERVER_URL przekazuje adres serwera podglądu. Oba dostają tę samą wartość CONTAINER_CONFIG.
Polecenie z artykułu tworzy tylko serwer tagujący. Przyjmuje on żądania, ale podgląd, w którym według artykułu źle skierowany hit staje się widoczny natychmiast, nie ma gdzie działać. Automatyczne udostępnianie tworzy obie usługi samo; kto wybiera drogę ręczną, przejmuje tę część.
Czy własna subdomena wystarczy, żeby Safari nie skracało ciasteczka ustawianego przez kontener serwerowy?
Nie w każdym przypadku. Przy ciasteczkach z nagłówka Set-Cookie Safari sprawdza także, dokąd subdomena faktycznie prowadzi. Jeśli jest skierowana rekordem CNAME na obcy host, jak zwykle przy przypisaniu własnej domeny do Cloud Run, albo odpowiada spod adresu IP spoza zakresu adresów samej witryny, Safari ogranicza również te ciasteczka do siedmiu dni.
Subdomena pozostaje mimo to warunkiem, który wymienia artykuł: bez niej w ogóle nie ma kontekstu first-party. Dla pełnego okresu ważności w Safari serwer tagujący musi jednak być osiągalny przez tę samą infrastrukturę co sklep, na przykład przez ścieżkę w domenie sklepu, którą load balancer lub CDN przekazuje do kontenera serwerowego.
Kontrola w praktyce: uzgodnienie zamówień z eksportem sklepu
Narzędzie Porównanie przychodów sklepu i GA4 porównuje dwa pliki CSV lokalnie. Wspólnym kluczem jest identyfikator zamówienia. Dane osobowe klientów nie są potrzebne: wystarczą ID zamówienia, kwota i waluta.
- Przygotowanie eksportów dla tego samego okresu i strefy czasowej, z identycznym traktowaniem podatków, dostawy i zwrotów. Pozycje towarów i zwroty wymagają wcześniejszego zsumowania do uzgodnionej kwoty na zamówienie.
- Wybór separatora i znaku dziesiętnego dla każdego pliku, wczytanie i przypisanie kolumn ID, kwoty i waluty. Zera na początku identyfikatora pozostają zachowane.
- Wybór liczby miejsc dziesiętnych i jawnej tolerancji na zamówienie. Bez przeliczania walut.
- Kontrola osobnych grup: brak po jednej stronie, powtórzone ID, inna waluta i kwota poza tolerancją.
- Eksport wyniku i sprawdzenie konkretnych zamówień w systemach źródłowych.
Powtórzone ID są oznaczane zamiast sumowania: ponowne wysłanie zakupu, eksport pozycji i wiersz zwrotu wymagają odmiennej interpretacji. Ujemne kwoty są akceptowane jako liczby, lecz definicja biznesowa nadal musi się zgadzać. Brak zamówienia w Analytics może wynikać ze zgody, momentu pomiaru, filtrów lub błędów zbierania; sam w sobie nie dowodzi wadliwego tagu. Zerowa różnica nie potwierdza eksportu wszystkich zamówień. Narzędzie nie sumuje kwot w różnych walutach.
Definicje wynikają z wybranego eksportu i dokumentacji ecommerce GA4. Schemat Data API rozróżnia ID transakcji i metryki przychodu; ogólny przychód całkowity nie musi odpowiadać kwocie zamówienia sklepu.
Przygotowanie pliku CSV Analytics w BigQuery
Pomocnik eksportu w porównywarce przychodów tworzy zapytanie o zakupy dla istniejącego dziennego eksportu GA4. Projekt, zbiór danych, daty i precyzja zaokrąglania są wprowadzane lokalnie. Strona nie wykonuje SQL ani nie żąda dostępu do BigQuery.
Kolumny wyniku transaction_id, amount i currency odpowiadają polom porównania. Każdy zarejestrowany zakup pozostaje wierszem. Dodatkowa liczba zdarzeń zakupu pomaga znaleźć powtarzające się identyfikatory transakcji; nie są one automatycznie sumowane ani usuwane. Brak kwoty nie jest zastępowany zerem.
- Przed eksportem sklepu uzgodnienie definicji kwoty zakupu i granic dni. Zapytanie pomija zwroty oraz nie dodaje osobno podatków i dostawy.
- Wygenerowanie SQL, walidacja w BigQuery i sprawdzenie szacowanych kosztów. Przed wykonaniem ustawienie maksymalnej liczby rozliczanych bajtów.
- Zapis całego wyniku jako lokalnego CSV. W porównaniu wybór przecinka jako separatora, kropki dziesiętnej i tej samej precyzji co w zapytaniu.
- Kontrola powtarzających się identyfikatorów i brakujących pól przed interpretacją różnic kwot. Porównanie obsługuje do 20 000 wierszy danych na plik. Identyfikatory w arkuszach powinny pozostać tekstem.
Dwa fikcyjne pliki CSV do pobrania zapewniają powtarzalny pierwszy test, po jednym przypadku w każdej z sześciu grup wyników. Są niezależne od SQL i używają dwóch miejsc dziesiętnych oraz zerowej tolerancji.
Źródła: schemat eksportu GA4, walidacja zapytań i kontrola kosztów oraz zapisywanie wyników jako CSV.
Powiązane artykuły