English
 Deutsch
 Polski
Die Rechnung hinter einer LLM-Abrechnung

Management Summary
Sprachmodelldienste rechnen häufig verarbeiteten und erzeugten Text in kleinen Texteinheiten ab, den sogenannten Token. Ein Gespräch kann mehr kosten als die sichtbare letzte Antwort, weil frühere Nachrichten erneut verarbeitet werden und teilweise unsichtbare Arbeit anfällt. Das ist für Budgets von KI-Assistenten und automatisierten Aufgaben relevant. Kürzere sinnvolle Verläufe, wiederverwendbare Eingaben und gebündelte weniger dringende Aufgaben können Kosten senken. Die Ersparnis hängt vom Dienst ab und darf die Antwortqualität nicht entwerten.
Inhalt
Tokenbasierte Sprachmodell-APIs rechnen üblicherweise den Verbrauch je Anfrage ab. Die Gesprächskosten ergeben sich aus der Summe dieser Anfragen. Beim Wiederverwenden des Verlaufs zählt eine frühe Frage dadurch mehrfach als Eingabe; eine allgemeine Gesprächspauschale gibt es nicht.
Ein LLM ist ein Sprachmodell, das Text erzeugt. Über eine API sendet Software Anfragen an das Modell. Die Eingabe umfasst die bereitgestellten Inhalte; die Ausgabe entsteht im Modell. Ein Prompt enthält Anweisung und Kontext. Ein Cache hält Zwischenergebnisse aus der Verarbeitung früherer Eingaben vorübergehend bereit: Schreiben legt einen Eintrag an oder erweitert diesen, Lesen nutzt einen vorhandenen Eintrag.
Eine brauchbare Schätzung trennt normale Eingabe, Cache-Schreiben, Cache-Lesen und Ausgabe sowie mögliche Werkzeug- oder Dienstgebühren. Das folgende Beispiel betrachtet ein Textgespräch mit festen Nachrichtenlängen. Es handelt sich um ein Rechenmodell, nicht um eine Anbieterrechnung oder allgemeingültige Preisliste.
Warum vollständiger Verlauf die kumulierte Eingabe erhöht
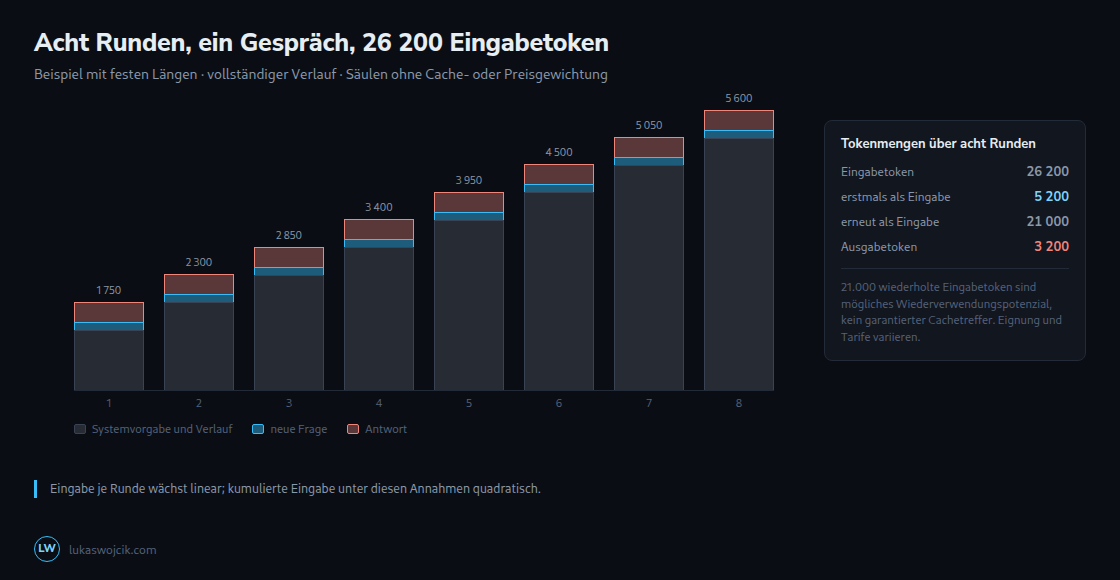
Eine API kann das erneute Senden des Verlaufs verlangen oder den Gesprächszustand serverseitig verwalten. Beides macht den wiederverwendeten Kontext nicht automatisch kostenlos. Im folgenden Beispiel enthält jede Anfrage den gesamten bisherigen Verlauf, ohne Zusammenfassung, Kürzung oder gezielte Auswahl einzelner Inhalte.
Die Systemvorgabe enthält die allgemeinen Anweisungen der Anwendung und umfasst 1.200 Token, jede Frage 150 und jede Antwort 400. Ein Tokenizer zerlegt Text in Einheiten namens Token. Das können Wörter, Wortteile oder Satzzeichen sein; ein Token entspricht keiner festen Wortzahl. Nachrichtenformatierung, Werkzeugdefinitionen, unsichtbare Formatelemente und Reasoning-Token für interne Modellverarbeitung vor der sichtbaren Antwort bleiben im vereinfachten Modell unberücksichtigt. Für Runde n beträgt die Eingabe 1.350 + 550 × (n − 1).
| Runde | Eingabe dieser Runde | Kumulierte Eingabetoken |
|---|---|---|
| 1 | 1.350 | 1.350 |
| 2 | 1.900 | 3.250 |
| 3 | 2.450 | 5.700 |
| 4 | 3.000 | 8.700 |
| 5 | 3.550 | 12.250 |
| 6 | 4.100 | 16.350 |
| 7 | 4.650 | 21.000 |
| 8 | 5.200 | 26.200 |
Nach acht Runden beträgt die kumulierte Eingabe 26.200 Token. Die achte Anfrage enthält 5.200 Eingabetoken; einschließlich der letzten Antwort mit 400 Token umfasst das Gespräch dann 5.600 Token samt Systemvorgabe. Alle acht Antworten ergeben zusätzlich 3.200 Ausgabetoken. Die Tabelle zählt Eingabetoken, weder Geld noch die Summe aus Ein- und Ausgabe.
Von der kumulierten Eingabe wiederholen 21.000 Token frühere Eingabe, also rund 80 %. Kürzere wiederverwendete Anweisungen oder ein kürzerer gespeicherter Verlauf können spätere Eingaben verkleinern. Eine Zusammenfassung kann jedoch selbst einen kostenpflichtigen Modellaufruf erfordern und Einzelheiten verlieren. Der Vergleich muss deshalb auch diese Kosten und die Qualität späterer Antworten berücksichtigen.
Beispieltarife statt allgemeingültiger Preisliste
| Art | Verhältnis | Annahme |
|---|---|---|
| Eingabe | 1× | Beispielhafter Bezugswert |
| Ausgabe | 5× | Beispielmultiplikator, kein allgemeines Verhältnis |
| Cache-Lesen | 0,1× | Beispiel: geeigneten Anfang innerhalb der Gültigkeit wiederverwenden |
| Cache-Schreiben | 1,25× | Beispielhafter Gesamtpreis des Schreibens, kein zusätzlicher Aufschlag von 1,25× |
| Stapel | 0,5× | Beispielrabatt; Modell, Endpunkt und Bedingungen müssen passen |
Dokumentation geprüft am 24. Oktober 2026: Cachebedingungen unterscheiden sich nach Anbieter und Modell. Claude dokumentiert Optionen mit 5 Minuten und 1 Stunde; OpenAI GPT-5.6 und neuer verwenden in Responses 30 Minuten und 12 Stunden. Auch Lesepreise variieren. Die Rechnung unten bleibt bewusst bei festen Beispieltarifen; ein echtes Budget benötigt aktuelle Preise und Verbrauchskategorien des gewählten Modells.
Die Tabelle verwendet Beispielmultiplikatoren mit normaler Eingabe als Bezugswert 1. Ein übereinstimmender Prompt-Anfang erhält nur dann den Cache-Lesepreis, wenn Eignung, Mindestlänge, Speichergrenzen und Laufzeit des gewählten Modells passen. Eine geänderte Uhrzeit kann die Wiederverwendung ab dieser Stelle unterbrechen; ein davor liegender stabiler Anfang kann weiter nutzbar bleiben. Manche Anbieter erlauben ausdrücklich gesetzte Speichergrenzen am Ende wiederverwendbarer Eingabeabschnitte. Andere verwalten den Cache automatisch. JSON ist das strukturierte Datenformat der Anfrage. Ein identischer JSON-Text ist keine allgemeine Abrechnungsregel.
Beim Schreibfaktor 1,25 und Lesefaktor 0,1 kosten einmaliges Schreiben und ein vollständiger weiterer Treffer zusammen 1,35 statt 2: eine Ersparnis von 32,5 %. Zwei oder drei Treffer sind nicht nötig. Ein kurzer Anfang kann unter der Mindestlänge liegen; ein abgelaufener Eintrag kann erneutes Schreiben erfordern. Entscheidend sind Wiederverwendung und Tarif, nicht die Prompt-Länge allein.
Stapelverarbeitung und Fristen
Bei Stapelverarbeitung wird eine Gruppe von Aufgaben gemeinsam eingereicht. Der Dienst bearbeitet diese im Hintergrund und stellt die Ergebnisse später bereit. OpenAI dokumentiert 50 % Rabatt und ein Bearbeitungsfenster von 24 Stunden; nicht abgeschlossene Anfragen können ablaufen. Anthropic beschreibt ebenfalls rabattierte Stapel und einen Ablauf nach 24 Stunden, oft mit früherem Abschluss. Ein Stapel bedeutet daher weder Sofortantwort noch unbegrenztes Warten ohne definiertes Zeitfenster.
Beispiele sind unabhängige Klassifizierungen, Katalogbeschreibungen und das Auslesen von Dokumentfeldern. Geeignetheit hängt von Fristen, unterstützten Modellen, Endpunkten und Funktionen, Datengrenzen sowie Fehlerbehandlung ab. Ein gerade betrachteter Bildschirm ist kein Abrechnungskriterium. Abhängige Arbeitsschritte können getrennte Stapel benötigen, weil spätere Eingaben zunächst noch fehlen.
Tokenmengen je Sprache messen
Die Tokenisierung hängt von Modellvokabular, Sprache, Zeichensetzung und Inhalt ab. Angaben wie vier Zeichen je Token sind grobe Richtwerte für englischen Text, keine verlässliche Umrechnung für Deutsch oder Polnisch. Eine Übersetzung kann je nach Tokenizer und Formulierung mehr oder weniger Token benötigen.
Daraus folgt kein fester Sprachaufschlag von 30 bis 50 %. Repräsentative Eingaben und Antworten müssen je Sprache mit dem Tokenizer oder Token-Zählendpunkt des vorgesehenen Modells erfasst werden. Die tatsächlichen Verbrauchsfelder zeigen anschließend die abgerechneten Kategorien. Unterschiedliche Tokenmengen sind von unterschiedlichen Preisen je Token zu trennen.
Ausgabe und Reasoning begrenzen
Ausgabelimits bieten echte Kontrolle: Der API-spezifische Parameter setzt eine Obergrenze, jedoch keine Ziellänge. Die Namen unterscheiden sich, etwa max_tokens bei Claude Messages und max_output_tokens bei OpenAI Responses. Eine niedrige Grenze kann Antworten abschneiden oder bereits durch Reasoning vor sichtbarem Text ausgeschöpft werden. Knappe Anweisungen und unterstützte Einstellungen für Denkaufwand oder Ausführlichkeit steuern andere Aspekte.
JSON ist nicht automatisch günstiger als Fließtext: Feldnamen, Satzzeichen und das Schema können zusätzliche Token erzeugen. Ein kompaktes Format sollte gegen eine inhaltlich gleichwertige Alternative gemessen werden. Bei Abrechnung von Reasoning als Ausgabe ergeben 2.000 abgerechnete Reasoning-Token und 40 sichtbare Antworttoken insgesamt 2.040 Ausgabetoken, sofern keine weiteren abgerechneten Ausgabetoken hinzukommen. Maßgeblich ist der gemeldete Verbrauch, nicht allein der sichtbare Text.
Fragen und Antworten
Wie viel spart ein Zwischenspeicher im Gespräch aus der ersten Tabelle?
Unter den genannten Multiplikatoren senkt das idealisierte Cachebeispiel die Eingabekosten um etwa 67,2 %. Vorausgesetzt sind vollständig cachefähige Prompts, die Wiederverwendung der gesamten vorherigen Anfrage und weiterhin gültige Einträge. Jede Erweiterung ergänzt die vorherige Antwort mit 400 Token und die nächste Frage mit 150 Token. Reale Mindestlängen, Speichergrenzen und fehlende Treffer können das Ergebnis verändern.
Die folgende Rechnung verwendet Preiseinheiten. Eine Einheit entspricht dem Preis eines normalen Eingabetokens. Diese Einheiten sind weder tatsächliche Tokenmengen noch Geldbeträge. Die Multiplikation mit dem normalen Eingabepreis je Token ergibt die Kosten:
- Runde 1 schreibt 1.350 Token zum Schreibpreis: 1.350 × 1,25 = 1.687,5.
- Die Runden 2 bis 8 lesen zusammen 21.000 Token, genau den Anteil, den das Modell schon einmal bekommen hat: 21.000 × 0,1 = 2.100.
- Dieselben Runden schreiben siebenmal 550 Token: 3.850 × 1,25 = 4.812,5.
Die Summe beträgt 8.600 statt 26.200 Preiseinheiten. Beim beispielhaften Ausgabefaktor 5 kommen in beiden Fällen 16.000 für 3.200 Ausgabetoken hinzu: insgesamt 24.600 statt 42.200 und damit rund 41,7 % Ersparnis. Abgelaufene Einträge oder geänderte Prompt-Anfänge können die Wiederverwendung verringern; ein unveränderter früherer Abschnitt kann weiterhin geeignet sein. Zusammenfassungs- und weitere Dienstkosten sind nicht eingerechnet.
Wird das Verhältnis bei noch längeren Gesprächen noch ungünstiger?
Bei vollständigem Verlauf und diesen festen Längen erzeugen 16 Runden 87.600 Eingabetoken, etwa das 3,34-Fache der Summe nach acht Runden. Allgemein beträgt die kumulierte Eingabe 1.350n + 550n(n − 1)/2. Die Rechnung enthält einen Anteil, der mit dem Quadrat der Rundenzahl wächst: Jede weitere Anfrage wiederholt mehr Verlauf. Das gilt für dieses Modell mit unbegrenzt mitgeführtem Verlauf, nicht für jede Anwendung. Caching, Kontextgrenzen, Zusammenfassungen und gezielte Verlaufsauswahl verändern die tatsächliche Kostenkurve.
Quellen
Passend dazu