English
 Deutsch
 Polski
Tutorial: Tokenverbrauch je Anfrage messen und ein Monatsbudget durchsetzen

Management Summary
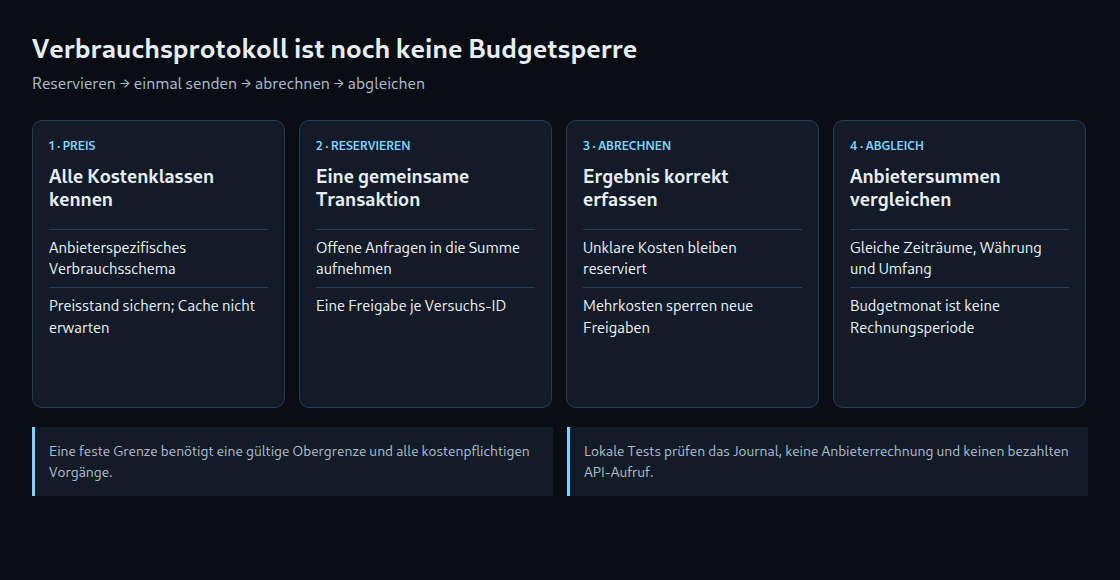
Ein monatliches KI-Budget begrenzt die Ausgaben einer Anwendung für Modellanfragen und ergänzende Dienste. Reine Textmengen reichen zur Planung nicht aus, weil Modelle, mitgeführte Gesprächsinhalte und Werkzeuge unterschiedlich kosten. Eine Kostenreservierung vor jeder Anfrage verhindert, dass gleichzeitige Aufgaben dasselbe Restbudget mehrfach ausgeben. Danach ersetzt der tatsächliche Verbrauch die Reservierung. Das macht automatische Assistenten finanziell planbarer, sofern sämtliche kostenpflichtigen Vorgänge erfasst werden.
Inhalt
Ein brauchbares API-Budget verbindet drei Aufzeichnungen: eine Reservierung vor der Anfrage, gemessenen Verbrauch nach der Antwort und einen späteren Abgleich mit den Anbietergebühren. Eine Token-Gesamtsumme reicht dafür nicht. Anbieter, Modell, Verarbeitungstarif, Cacheklasse und zusätzliche Werkzeuge können den Preis verändern.
1. Das Verbrauchsschema des Anbieters verstehen
Bei Anthropic Messages bezeichnet input_tokens die nicht zwischengespeicherte Eingabe. Cacheaufbau und Cachezugriffe bilden zusätzliche Eingabeklassen; für den Aufbau können je Speicherdauer unterschiedliche Preise gelten. Bei OpenAI Responses ist input_tokens dagegen die gesamte Eingabe, einschließlich Cachezugriffen und unterstützten Cache-Schreibklassen. Eine Addition dieser Unterklassen zur Gesamtsumme würde Eingabe doppelt zählen. Die Strukturen unterscheiden sich fachlich, nicht bloß in ihren Namen.
Der folgende erfundene, vereinheitlichte Datensatz verwendet vier überschneidungsfreie Klassen. Die Preise in USD je Million Token dienen der Rechnung und sind kein aktuelles Angebot für ein benanntes Modell. Ein echter Adapter muss den gewählten Endpunkt und sämtliche einschlägigen Cachelaufzeiten berücksichtigen.
from decimal import Decimal, ROUND_CEILING

# Fictional normalized classes and example USD rates per million.
counts = {"input": 12400, "write_5m": 8200, "read": 96000, "output": 1850}
rates = {k: Decimal(v) for k, v in {
    "input": "3.00", "write_5m": "3.75", "read": "0.30", "output": "15.00"
}.items()}
cost_usd = sum(Decimal(counts[k]) * rates[k] for k in counts) / Decimal(1_000_000)
actual_u = int((cost_usd * 1_000_000).to_integral_value(rounding=ROUND_CEILING))
print(cost_usd, actual_u)  # 0.1245, 124500
Die exakten Teilbeträge lauten 0,0372, 0,03075, 0,0288 und 0,02775 USD, zusammen 0,1245 USD. Werden alle angezeigten Teilbeträge vorher gerundet, kann deren sichtbare Summe abweichen. Dezimalrechnung erhält die Berechnung; das Reservierungsjournal unten verwendet ganzzahlige Mikro-USD, also 1.000.000 Einheiten je USD. Aufrunden auf diese Einheit ist eine interne Budgetregel, keine Rechnungsregel des Anbieters.
2. Vorher zählen, nach Abschluss protokollieren
Anthropics Zählendpunkt ist innerhalb seiner Ratenbegrenzungen kostenlos und liefert eine Schätzung ohne Cachelogik. Nicht alle von Messages unterstützten Eingaben sind dort zulässig: Die aktuelle Dokumentation schließt die meisten Serverwerkzeuge, den MCP-Connector und Bild- oder Dokumentblöcke mit URL-/Dateiquellen aus. Modell und vollständige unterstützte Anfrageform sind entscheidend. Ein reiner Texttokenizer schätzt Werkzeuge, Bilder und Nachrichtenrahmen nicht allgemeingültig ab.
Beim Streaming erscheint Verbrauch nicht grundsätzlich erst im letzten Ereignis. Anthropic liefert anfängliche Angaben in message_start und kumulierte Aktualisierungen in message_delta. Die Addition sämtlicher kumulierter Werte würde überzählen. Aufeinanderfolgende Gesamtstände von 10 und 20 bedeuten beispielsweise bisher 20 Token, nicht 30. Eine unterstützte SDK-Funktion für die abgeschlossene Nachricht erleichtert das Sammeln. Abgebrochene Streams und Verbindungsfehler können unvollständige Angaben hinterlassen. Fehlende Daten bleiben unbekannt und werden nicht zu null.
Ein dauerhaftes Prüfprotokoll sollte logischen Vorgang, eindeutige Versuchs-ID, verfügbare Anbieterkennungen, Zeitpunkte, Funktion, Anbieter und Modell, Preisstand, Reservierung und Rohverbrauch verknüpfen. Prompts und API-Schlüssel werden dafür nicht benötigt. Eine Wiederholung ist ein eigener Versuch mit eigener Reservierung für mögliche Kosten. Ein Timeout beweist weder eine Berechnung noch einen Abbruch beim Anbieter; Antwortheader können den Client überhaupt nicht erreicht haben.
3. Die vollständige Obergrenze atomar reservieren
Die Obergrenze muss Eingabe, höchstmögliche einschlägige Ausgabe, mögliche Cache-Schreibkosten und begrenzte Werkzeug- oder Schleifenkosten abdecken. Nur die maximale Ausgabe genügt nicht. Unbekannte Preise, unbegrenzte Werkzeugschleifen oder ein fehlgeschlagener Journaleintrag müssen den Versand verhindern. Cachetreffer dürfen für diese Obergrenze nicht vorausgesetzt werden.
Die ausführbare ledger.py zeigt eine Freigabeprüfung für eine Anwendung, eine Währung und eine UTC-Kalendermonatsregel. Alle Aufrufer müssen dieselbe lokale SQLite-Datenbank verwenden. Eine Datenbank für mehrere Hosts oder eine vollständige Abrechnungsintegration entsteht daraus nicht. Die Betragsprüfung begrenzt jeden Wert auf eine Million USD in Mikroeinheiten.
Vor der ersten Reservierung legt initialise(database_path) die Tabellen an. Ausgabeverbrauch kann unsichtbare Denk- oder Formatierungstoken enthalten; die sichtbare Antwortlänge ist kein Ausgabezähler.
import sqlite3
from datetime import datetime, timezone

class BudgetExceeded(Exception):
    pass

def units(value):
    if type(value) is not int or not 0 <= value <= 10**12:
        raise ValueError("Expected non-negative integer micro-USD, at most 10^12")
    return value

def connect(path):
    db = sqlite3.connect(path, timeout=10, isolation_level=None)
    db.execute("PRAGMA foreign_keys=ON")
    return db

def initialise(path):
    db = connect(path)
    try:
        db.executescript("""
        CREATE TABLE IF NOT EXISTS budgets(
          month TEXT PRIMARY KEY, limit_u INTEGER NOT NULL,
          breached INTEGER NOT NULL DEFAULT 0);
        CREATE TABLE IF NOT EXISTS calls(
          attempt_id TEXT PRIMARY KEY,
          month TEXT NOT NULL REFERENCES budgets(month),
          reserved_u INTEGER NOT NULL, actual_u INTEGER,
          state TEXT NOT NULL CHECK(state IN ('pending','settled')));
        """)
    finally:
        db.close()

def reserve(path, attempt_id, upper_u, limit_u, now=None):
    upper_u, limit_u = units(upper_u), units(limit_u)
    if not isinstance(attempt_id, str) or not attempt_id:
        raise ValueError("Stable, nonempty attempt ID required")
    now = datetime.now(timezone.utc) if now is None else now
    if now.tzinfo is None or now.utcoffset() is None:
        raise ValueError("Timezone-aware timestamp required")
    month = now.astimezone(timezone.utc).strftime("%Y-%m")
    db = connect(path)
    try:
        db.execute("BEGIN IMMEDIATE")
        if db.execute("SELECT 1 FROM calls WHERE attempt_id=?",
                      (attempt_id,)).fetchone():
            db.commit()
            return False  # No second permission to send.
        db.execute("INSERT OR IGNORE INTO budgets(month,limit_u) VALUES (?,?)",
                   (month, limit_u))
        stored_limit, breached = db.execute(
            "SELECT limit_u,breached FROM budgets WHERE month=?", (month,)
        ).fetchone()
        if stored_limit != limit_u:
            raise ValueError("Conflicting limit for this month")
        used = db.execute(
            "SELECT COALESCE(SUM(COALESCE(actual_u,reserved_u)),0) "
            "FROM calls WHERE month=?", (month,)
        ).fetchone()[0]
        if breached or used + upper_u > limit_u:
            raise BudgetExceeded(month)
        db.execute("INSERT INTO calls VALUES (?,?,?,?,?)",
                   (attempt_id, month, upper_u, None, "pending"))
        db.commit()
        return True
    except BaseException:
        db.rollback()
        raise
    finally:
        db.close()

def settle(path, attempt_id, actual_u):
    actual_u = units(actual_u)
    db = connect(path)
    try:
        db.execute("BEGIN IMMEDIATE")
        row = db.execute(
            "SELECT month,reserved_u,actual_u,state FROM calls WHERE attempt_id=?",
            (attempt_id,)
        ).fetchone()
        if row is None:
            raise ValueError("Unknown attempt")
        month, reserved, old_actual, state = row
        if state == "settled":
            if old_actual != actual_u:
                raise ValueError("Conflicting settlement")
            db.commit()
            return
        db.execute("UPDATE calls SET actual_u=?,state='settled' WHERE attempt_id=?",
                   (actual_u, attempt_id))
        if actual_u > reserved:
            db.execute("UPDATE budgets SET breached=1 WHERE month=?", (month,))
        db.commit()
    except BaseException:
        db.rollback()
        raise
    finally:
        db.close()
BEGIN IMMEDIATE beginnt die Schreibtransaktion bereits vor dem Lesen der Summe. Dadurch können zwei gleichzeitige Aufrufer nicht denselben verbleibenden Budgetbetrag reservieren. Die Reservierung wird vor der Netzwerkanfrage festgeschrieben; während des API-Aufrufs bleibt keine Transaktion offen. Nur ein wahrer Rückgabewert von reserve() erlaubt den Versand. False bedeutet einen bereits vorhandenen Versuch, keine erneute Versandfreigabe. Sperr- und Datenbankfehler müssen den Aufruf stoppen.
PSEUDOCODE
validate provider, model, pricing snapshot and complete cost bound
persist a unique attempt ID and audit context
if reserve(database, attempt_id, upper_bound_u, monthly_limit_u) is True:
    send exactly one provider attempt outside the database transaction
    on complete usage:
        persist the original usage and provider identifiers
        calculate cost with the recorded pricing snapshot
        settle(database, attempt_id, actual_cost_u)
    on unknown outcome or unknown cost:
        keep the reservation pending and investigate
Das gespeicherte Limit bleibt für diesen Monat fest. Eine spätere Überschreitungsmarkierung bricht bereits freigegebene Anfragen nicht ab.
Der Ablauf ist Pseudocode für den Anbieteradapter: Ein geprüfter Preisstand und eine vollständige Obergrenze sind Voraussetzungen. Der ausführbare Code darüber ruft keine API auf. Eine Abrechnung wird einmal gespeichert; identische Wiederholungen bleiben möglich, widersprüchliche Beträge werden abgelehnt. Übersteigen tatsächliche Kosten die Reservierung, wird der Mehrverbrauch erfasst und der Monat für weitere Freigaben gesperrt. Bereits entstandene Kosten lassen sich damit nicht zurücknehmen.
4. Unklare Versuche sichtbar halten
Ein Absturz nach der Reservierung, aber vor dem Versand kann ungenutztes Budget blockieren. Ein Timeout nach dem Versand kann tatsächliche Kosten ungeklärt lassen. Beide Fälle automatisch verfallen zu lassen, würde ohne Nachweis neuen Spielraum öffnen. Die Wiederherstellung benötigt Prüfprotokoll und Anbieterinformationen; nur nachweislich kostenfreie Versuche sollten mit null abgeschlossen werden.
Der Monat wird bei der Reservierung anhand von UTC zugeordnet. Eine spätere Abrechnung bleibt diesem Monat zugeordnet. Das ist eine interne Regel, keine Aussage über den Rechnungszeitpunkt. Einreichung, Ausführung, lokale Abrechnung und Anbieterperiode sollten bei asynchronen Stapeln und Monatsgrenzen getrennt erhalten bleiben.
Fragen und Antworten
Bleibt die Anbieterrechnung damit garantiert unter dem Budget?
Nein. Obergrenze, Preisadapter und Einbindung sämtlicher kostenpflichtiger Vorgänge müssen stimmen. Andere API-Schlüssel, fehlende Werkzeugkosten, Vertragsbedingungen, Steuern oder spätere Korrekturen können außerhalb des lokalen Journals liegen. Anbieterseitige Grenzen können zusätzlich schützen, sofern vorhanden; maßgeblich ist deren dokumentierter Umfang.
Lässt sich jede Anfrage beim Abgleich einzeln zuordnen?
Nein. Anthropics Usage- und Cost-APIs liefern aggregierte Zeitabschnitte und Gruppierungsmerkmale. Ein Export jeder einzelnen Anfrage darf nicht vorausgesetzt werden. Auch die Kostenabdeckung besitzt dokumentierte Grenzen. Zeitraum, Währung und Umfang müssen vor der Interpretation einer Abweichung zusammenpassen.
Was belegen die Beispieltests?
Acht parallele Reservierungsversuche erlaubten bei einer Grenze von 100 genau zwei Beträge von 40. Weitere isolierte Prüfungen betrafen doppelte Abrechnungen, ungeklärte offene Versuche, widersprüchliche Limits, ungültige Beträge und UTC-Monatsgrenzen. Kostenpflichtige API-Aufrufe und echte Rechnungen wurden nicht getestet.
Quellen
Passend dazu