English
 Deutsch
 Polski
Agenci AI w analityce internetowej: jak ruch agentowy zniekształca GA4 i jak oddzielić go po stronie serwera

Spis treści
- Trzy klasy wizyt AI
- Nowy kanał AI Assistant w GA4: co mierzy, a czego nie
- Martwe pole: przeglądarki agentowe w danych
- Tożsamość agenta: od User-Agent do podpisu kryptograficznego
- Architektura: klasyfikacja przed śledzeniem
- Implementacja: od żądania do analizy w BigQuery
- WebMCP: interakcje agentów jako czyste zdarzenia
- Higiena danych: lista dozwolonych hostów i zdarzenia po stronie serwera
- Lista kontrolna na najbliższe 30 dni
- Podsumowanie
- Pytania i odpowiedzi
- Źródła
W 2026 roku agenci AI przestali być eksperymentem i stali się mierzalnym źródłem ruchu – a większość konfiguracji analitycznych po prostu liczy ich jako ludzi. Agenci otwierają strony, przewijają je, wypełniają formularze i dodają produkty do koszyka. W raporcie GA4 wygląda to jak zwykła sesja z przeglądarki Chrome, często jako „Direct”, czasem nawet jako ruch organiczny.
Skala nie jest już pomijalna. Według HUMAN Security ruch agentów AI i przeglądarek agentowych wzrósł w 2025 roku o 7851% rok do roku. W zestawieniu za sierpień 2026 ruch agentowy znów wzrósł o 27% i osiągnął nowy rekord.
Jednocześnie w maju 2026 roku Google wprowadził w GA4 osobny kanał „AI Assistant”. Brzmi to jak rozwiązanie, ale kanał obejmuje tylko wycinek ruchu. Ten artykuł pokazuje, jakie rodzaje wizyt AI istnieją, które z nich GA4 faktycznie rozpoznaje i jak sklasyfikować ruch agentowy po stronie serwera, a następnie czysto przenieść go do analizy – z konkretnymi przykładami kodu.
Trzy klasy wizyt AI
„Ruch AI” nie jest jednolitym zjawiskiem – technicznie dzieli się na trzy klasy o zupełnie różnym zachowaniu w pomiarze. Wrzucenie ich do jednego worka nie daje ani czystych liczb użytkowników, ani wiarygodnej oceny wartości AI jako kanału.
| Klasa | Przykłady | Wykonuje JavaScript | Widoczna w GA4 | Rozpoznawalna po |
|---|---|---|---|---|
| Ludzie skierowani przez AI | Kliknięcie źródła w ChatGPT, Gemini, Claude, Perplexity | tak | tak, często w kanale „AI Assistant” | Referrer, parametry UTM |
| Pobrania po stronie serwera na zlecenie użytkownika | ChatGPT-User, Claude-User, Perplexity-User | zwykle nie | nie | User-Agent, listy IP, logi serwera |
| Przeglądarki agentowe | Perplexity Comet, ChatGPT Agent, Chrome Auto Browse, Google-Agent | tak | tak, jako zwykła sesja | trudno: częściowo token w User-Agent, częściowo podpisy, częściowo wcale |
Do tego dochodzą klasyczne crawlery treningowe i wyszukiwarkowe, takie jak GPTBot czy OAI-SearchBot. Te crawlery z reguły nie wykonują JavaScriptu, dlatego pojawiają się tylko w logach, a nie w śledzeniu opartym na tagach.
Właściwym problemem jest trzecia klasa. Przeglądarki agentowe wykonują skrypt śledzący, zapisują ciasteczka, wyzwalają zdarzenia – a przy tym nie zachowują się jak człowiek. Właśnie te sesje zmieniają współczynniki konwersji, odrzucenia i analizy lejka, choć nie są oznaczone jako agent.
Nowy kanał AI Assistant w GA4: co mierzy, a czego nie
Kanał „AI Assistant” obejmuje wyłącznie kliknięcia ludzi z rozpoznawalnym referrerem – czyli tylko pierwszą z trzech klas. Według informacji o wersji Google z 13 maja 2026 GA4 ustawia medium na „ai-assistant”, gdy tylko referrer pasuje do znanego asystenta AI. Takie wizyty trafiają w domyślnej grupie kanałów (Default Channel Group) do „AI Assistant”, a kampania nosi nazwę „(ai-assistant)”.
Uzupełnieniem jest dostępny od 11 czerwca 2026 wymiar Source Group. Wymiar grupuje wartości źródła i według Google zawiera już grupy dla ChatGPT (OpenAI) i Perplexity – wypełnione wstecznie, a więc przydatne także dla okresów historycznych.
Mimo to pozostają trzy luki:
- Brak referrera. Przejścia z aplikacji natywnych do przeglądarki często nie przekazują referrera. Takie wizyty trafiają do „Direct”, choć to asystent AI był ich źródłem. Część ratują parametry UTM, na przykład
utm_source=chatgpt.com, który ChatGPT dopisuje do wielu linków. - Funkcje AI wewnątrz Google. Kliknięcia z AI Overviews lub AI Mode przychodzą z referrerem Google i dlatego pozostają częścią „Organic Search”. Nowy kanał ich nie wydziela.
- Agenci zamiast ludzi. Przeglądarka agentowa, która na zlecenie użytkownika otwiera stronę produktu, często nie ma żadnego referrera albo ma dowolny. Kanał nic nie mówi o tych sesjach – kryją się nierozpoznane we wszystkich kanałach.
Do wstępnej oceny kanał jest jednak cenny: pokazuje, które treści są linkowane jako źródło w odpowiedziach AI i jak dobrze ten ruch konwertuje w porównaniu z ruchem organicznym.
Martwe pole: przeglądarki agentowe w danych
Przeglądarki agentowe działają na Chromium, normalnie wykonują śledzenie i domyślnie przedstawiają się jako zwykły Chrome. Lista botów IAB, na której GA4 opiera filtrowanie botów, nie obejmuje ich, jak przeanalizował Snowplow. Seer Interactive zaobserwował w jednym teście nawet, że agent OpenAI pojawił się w GA4 jako Bing/organic.
W 2026 roku rynek wyraźnie się uporządkował:
- Perplexity Comet był w sierpniu 2026 według HUMAN największym pojedynczym źródłem ruchu agentowego z udziałem 40,7%.
- OpenAI wycofał samodzielną przeglądarkę ChatGPT Atlas 9 sierpnia 2026. ChatGPT Agent, Codex i Atlas razem odpowiadały w sierpniu za około 31% ruchu agentowego; Atlas mógł się do tego przyczynić tylko do wycofania 9 sierpnia.
- Chrome Auto Browse działa od 28 stycznia 2026 bezpośrednio w najpopularniejszej przeglądarce. Według przeglądu nohacks funkcja jest nadal ograniczona do USA i do płatnych subskrypcji Google AI Pro i Ultra. Dla stron z regionu DACH efekt jest więc na razie niewielki, ale zasięg jest już przygotowany.
Dodatkowo według TAGGRS Comet domyślnie blokuje reklamy i trackery. Część sesji agentowych w ogóle wtedy nie trafia do danych, a inna część jest liczona w pełni – to podwójne zniekształcenie, którego bez danych z serwera nie da się rozplątać.
Typowe objawy w danych:
- rosnąca liczba sesji przy stojącej w miejscu liczbie zakupów lub leadów
- więcej ruchu „Direct” na głębokich stronach produktów i wyszukiwania bez rozpoznawalnej kampanii
- rozpoczęte formularze i zdarzenia koszyka bez finalizacji, skupione na Chrome w wersji desktopowej
- uderzająco równe odstępy między zdarzeniami w obrębie sesji
Jak mały jest jeszcze bezpośredni udział w przychodach, pokazuje kolejna liczba HUMAN: 2,3% aktywności agentowej przypadało w 2025 roku na strony checkoutu. Większość agentów szuka informacji, porównuje i przerywa – i obniża w ten sposób właśnie te wskaźniki, na których opierają się decyzje optymalizacyjne.
Tożsamość agenta: od User-Agent do podpisu kryptograficznego
Agenta da się rozpoznać niezawodnie tylko wtedy, gdy sam się przedstawi – a w 2026 roku po raz pierwszy powstaje do tego solidny standard. Rozpoznawanie działa dziś na trzech poziomach, które wyraźnie różnią się wiarygodnością.
1. Token w User-Agent. Najprostszy, ale łatwy do podrobienia. 20 marca 2026 Google udokumentował fetcher Google-Agent. Według dokumentacji Google jego User-Agent zawiera token compatible; Google-Agent wewnątrz poza tym zwykłego ciągu Chrome. Jako pobranie wywołane przez użytkownika Google-Agent ignoruje robots.txt.
2. Zakresy IP i reverse DNS. Wyraźnie bardziej odporne. Google publikuje adresy Google-Agent w osobnym pliku user-triggered-agents.json. Według PPC Land pobrania obsługiwane przez Google rozwiązują się w reverse DNS na google-proxy-***-***-***-***.google.com. Weryfikacja przebiega dwuetapowo: odwrotne zapytanie o IP, a potem zapytanie w przód o nazwę hosta z powrotem na ten sam adres IP.
3. Web Bot Auth. Nowe podejście podpisuje kryptograficznie każde żądanie na podstawie RFC 9421 (HTTP Message Signatures). Grupa robocza IETF webbotauth ma już statut, ale dokument protokołu jest wciąż Internet-Draftem. Podpisane żądanie zawiera trzy dodatkowe nagłówki, według Contextbolt mniej więcej takie:
Signature-Agent: "https://chatgpt.com"
Signature-Input: sig1=("@authority" "signature-agent");
  created=1786951400; expires=1786951700;
  keyid="poqkLGiymh_W0uP6PZFw-dvez3QJT5SolqXBCW38r0U";
  alg="ed25519"; tag="web-bot-auth"
Signature: sig1=:jP4kZG2h9xQvT1mN...:
Serwer pobiera klucz publiczny ze źródła podanego w Signature-Agent pod ścieżką /.well-known/http-message-signatures-directory, wyszukuje pasujący keyid i sprawdza podpis oraz okno czasowe z created i expires. Podrobiony User-Agent nie przechodzi tej weryfikacji.
| Operator | Signature-Agent | Stan |
|---|---|---|
| ChatGPT (przeglądarka w chmurze) | https://chatgpt.com | podpisuje, klucz opublikowany pod standardową ścieżką |
| Google-Agent | https://agent.bot.goog | eksperymentalnie, tylko część żądań |
| Cloudflare Verified Bots | zależnie od operatora | Web Bot Auth jako jedna z dwóch akceptowanych form potwierdzenia |
| AWS WAF Bot Control | zależnie od operatora | obsługiwane od 21 listopada 2025 |
Stan według Contextbolt, projekt protokołu w rewizji 02 z 18 sierpnia 2026.
Dla większości witryn własna implementacja weryfikacji podpisów się nie opłaca. Rozsądniej jest przejąć klasyfikację z CDN lub WAF i przekazać jej wynik do aplikacji jako nagłówek. Właśnie na tym opiera się poniższa architektura.
Architektura: klasyfikacja przed śledzeniem
Rozdzielenie udaje się tylko wtedy, gdy klasa wizyty jest ustalona, zanim uruchomi się skrypt śledzący. Późniejsze filtry w GA4 przychodzą za późno, bo brakuje im sygnałów dostępnych po stronie serwera: podpisów, pochodzenia IP, reverse DNS.
Architektura opiera się na trzech zasadach:
- Weryfikacja na brzegu. CDN lub WAF sprawdza Web Bot Auth, listy IP i reverse DNS i przekazuje wynik dalej jako nagłówek.
- Jedna klasyfikacja. Serwer WWW przypisuje każdemu żądaniu dokładnie jedną klasę. Zweryfikowana tożsamość ma pierwszeństwo przed deklaracją w User-Agent.
- Oznaczanie zamiast usuwania. Sesje agentów zostają w danych, ale mają własny wymiar. Dzięki temu sam kanał agentowy nadal poddaje się analizie.
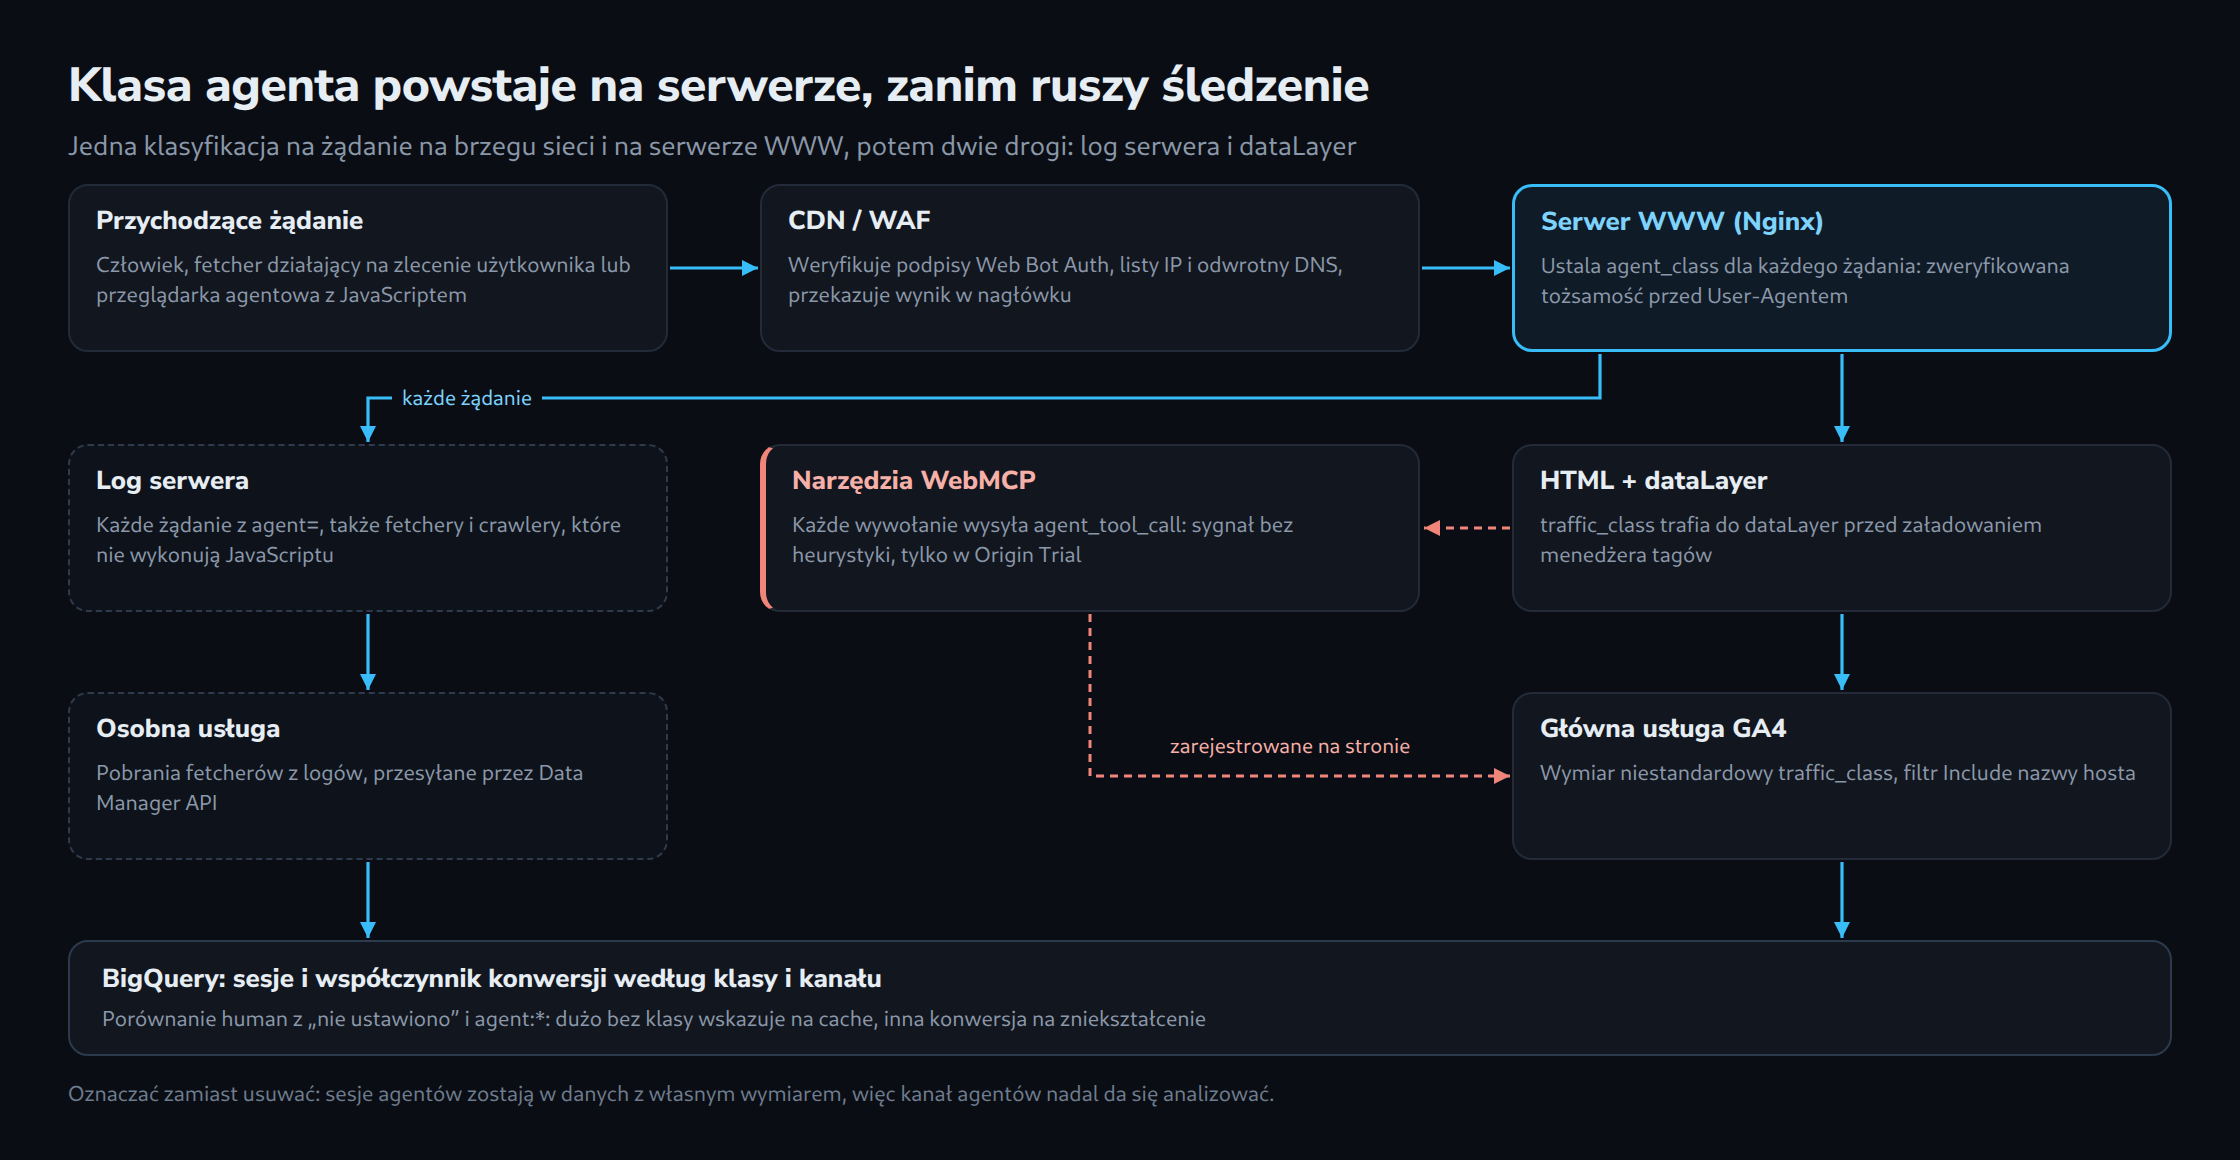
Log serwera rejestruje wszystkie pobrania, także te bez JavaScriptu. GA4 dostaje tylko odsłony – ale z klasą i opcjonalnie ze zdarzeniami WebMCP jako jednoznacznym sygnałem agenta.
Implementacja: od żądania do analizy w BigQuery
Wdrożenie składa się z czterech elementów: klasyfikacji na serwerze WWW, logowania, przekazania do śledzenia i analizy. Przykłady wykorzystują Nginx, PHP, GA4 i BigQuery; zasadę da się przenieść na dowolny stos technologiczny.
1. Klasyfikacja w Nginx
Łączą się tu dwa źródła: nagłówek ustawiony przez CDN ze zweryfikowanym wynikiem (tutaj X-Verified-Agent, na przykład przez Transform Rule) i proste rozpoznawanie po User-Agent jako rezerwa. Zweryfikowany wynik ma pierwszeństwo.
# Rezerwa: deklaracja w User-Agent (łatwa do podrobienia, więc tylko drugi wybór)
map $http_user_agent $ua_agent_class {
    default                                          "";
    ~*Google-Agent                                   "agent:google";
    ~*ChatGPT-User                                   "fetcher:openai";
    ~*Claude-User                                    "fetcher:anthropic";
    ~*Perplexity-User                                "fetcher:perplexity";
    ~*(GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot) "crawler";
}

# Zweryfikowany wynik z CDN ma pierwszeństwo przed User-Agent, w przeciwnym razie "human"
map "$http_x_verified_agent|$ua_agent_class" $agent_class {
    default                "human";
    "~^(?<v>[^|]+)\|"       "$v";
    "~^\|(?<u>.+)$"         "unverified:$u";
}

log_format analytics '$remote_addr [$time_local] "$request" $status '
                     '"$http_referer" "$http_user_agent" agent=$agent_class';

server {
    access_log /var/log/nginx/access.log analytics;

    location ~ \.php$ {
        fastcgi_param AGENT_CLASS $agent_class;
        # ... pozostała konfiguracja FastCGI
    }
}
Ważne: na serwerze źródłowym nagłówek X-Verified-Agent musi być usuwany lub ignorowany w żądaniach, które nie przechodzą przez CDN. W przeciwnym razie każdy klient może sam podać się za zweryfikowanego.
2. Logi serwera jako drugie źródło prawdy
Fetchery i crawlery nie wykonują JavaScriptu, dlatego w GA4 brakuje ich całkowicie. Powyższy format logu czyni je widocznymi:
grep -o 'agent=[^ ]*' /var/log/nginx/access.log | sort | uniq -c | sort -rnWynik pokazuje, jak często systemy AI pobierają treści na zlecenie użytkowników, nie tworząc przy tym ani jednej sesji. Dla serwisów z treściami to często najbardziej pouczająca liczba ze wszystkich.
3. Przekazanie do dataLayer
Klasa jest zapisywana w stronie po stronie serwera i przekazywana do dataLayer przed załadowaniem Tag Managera:
<?php $trafficClass = $_SERVER['AGENT_CLASS'] ?? 'human'; ?>
<script>
  window.dataLayer = window.dataLayer || [];
  window.dataLayer.push({
    traffic_class: <?= json_encode($trafficClass) ?>
  });
</script>
Przy buforowaniu całych stron (full-page caching) klasa pierwszego odwiedzającego trafiałaby do wszystkich. Czyste alternatywy: wstawianie klasy do strumienia HTML logiką na brzegu sieci, różnicowanie cache według $agent_class albo odczytywanie klasy z nagłówka żądania dopiero w serwerowym Tag Managerze.
4. Konfiguracja GA4
- Przesyłanie
traffic_classw tagu Google jako parametru zdarzenia (w GTM jako zmienna dataLayer). - Utworzenie w GA4 w sekcji Administracja → Definicje niestandardowe wymiaru o zakresie „Zdarzenie” z parametrem
traffic_class. - Wymiary niestandardowe nie działają wstecz. Im wcześniejsza konfiguracja, tym dłuższa baza porównawcza.
5. Analiza w BigQuery
Zapytanie oblicza liczbę sesji i współczynnik konwersji dla każdej klasy ruchu i kanału. Nazwy projektu i zbioru danych należy dostosować.
WITH events AS (
  SELECT
    CONCAT(user_pseudo_id, '-', CAST(
      (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'ga_session_id') AS STRING
    )) AS session_key,
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'traffic_class') AS traffic_class,
    session_traffic_source_last_click.cross_channel_campaign.default_channel_group AS channel,
    event_name
  FROM `moj-projekt.analytics_123456789.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
),
sessions AS (
  SELECT
    session_key,
    COALESCE(MAX(traffic_class), 'nie ustawiono') AS traffic_class,
    MAX(channel) AS channel,
    COUNTIF(event_name = 'purchase') > 0 AS converted
  FROM events
  GROUP BY session_key
)
SELECT
  traffic_class,
  channel,
  COUNT(*) AS sessions,
  ROUND(100 * COUNTIF(converted) / COUNT(*), 2) AS conversion_rate_pct
FROM sessions
GROUP BY traffic_class, channel
ORDER BY sessions DESC;
Najwięcej mówi porównanie „human” z „nie ustawiono”: duży udział sesji bez klasy wskazuje na problemy z buforowaniem lub zablokowane skrypty, a wyraźnie odmienny współczynnik konwersji dla „agent:*” potwierdza efekt zniekształcenia.
WebMCP: interakcje agentów jako czyste zdarzenia
WebMCP odwraca problem pomiaru: zamiast zgadywać po fakcie, czy wizyta pochodzi od agenta, witryna oferuje agentom zdefiniowane funkcje – a każde wywołanie jest z definicji zdarzeniem agenta. Witryna rejestruje w tym celu narzędzia z nazwą, opisem i schematem JSON, które agent w przeglądarce wywołuje bezpośrednio.
Stan na październik 2026 według mcpplaygroundonline i chudi.dev:
- projekt grupy społecznościowej W3C (Community Group), jeszcze nie na ścieżce standaryzacji
- publiczny origin trial w Chrome od wersji 149 do 156
- API przeniesiono z
navigator.modelContextdodocument.modelContext. Chrome 150 oznaczył starą formę jako przestarzałą, wiele poradników pokazuje jednak jeszcze starą. - testy lokalne przez
chrome://flags/#enable-webmcp-testing
Dla analityki WebMCP jest interesujący dlatego, że pomiar da się zakotwiczyć bezpośrednio w handlerze:
const mc = document.modelContext ?? navigator.modelContext;

if (mc) {
  await mc.registerTool({
    name: 'search_products',
    description: 'Przeszukuje katalog produktów według słowa kluczowego i opcjonalnej ceny maksymalnej.',
    inputSchema: {
      type: 'object',
      properties: {
        query: { type: 'string' },
        max_price: { type: 'number' }
      },
      required: ['query']
    },
    async execute({ query, max_price }) {
      window.dataLayer = window.dataLayer || [];
      window.dataLayer.push({
        event: 'agent_tool_call',
        tool_name: 'search_products',
        traffic_class: 'agent:webmcp'
      });

      const params = new URLSearchParams({ q: query });
      if (max_price) params.set('max', String(max_price));
      const data = await (await fetch('/api/search?' + params)).json();

      return { content: [{ type: 'text', text: JSON.stringify(data.items) }] };
    }
  });
}
Zdarzenie agent_tool_call daje sygnał bez heurystyki: które funkcje agenci wykorzystują, jak często i z jakim wynikiem w dalszym przebiegu sesji. Wartości wejściowe nie powinny przy tym trafiać do śledzenia bez sprawdzenia, ponieważ agenci mogą przekazywać frazy wyszukiwania lub dane formularzy wpisane przez użytkowników.
Dopóki WebMCP działa tylko w origin trial, pozostaje sygnałem dodatkowym do wczesnych obserwacji, a nie zamiennikiem klasyfikacji po stronie serwera. Ponieważ API już raz się zmieniło, warto zamknąć je w osobnej funkcji pomocniczej.
Higiena danych: lista dozwolonych hostów i zdarzenia po stronie serwera
Dwie nowości GA4 z 2026 roku należą do każdej konfiguracji, która poważnie traktuje ruch agentowy: filtr uwzględniający nazwy hostów i Data Manager API. Według informacji o wersji Google obie są już dostępne.
Filtr uwzględniający nazwy hostów (od 21 września 2026). Dotąd nazwy hostów dało się tylko wykluczać, co przy każdym nowym źródle spamu wymagało pielęgnacji. Teraz da się zdefiniować listę dozwolonych domen własnej witryny. Dwa szczegóły są kluczowe:
- Zdarzenia bez nazwy hosta są automatycznie odrzucane. Konfiguracje serwerowe, które nie przesyłają kontekstu strony, tracą w ten sposób dane niezauważenie. Filtr powinien więc najpierw działać w stanie testowym („Testing”) i zostać aktywowany dopiero po porównaniu danych.
- Zdarzenia przesyłane przez Measurement Protocol nie podlegają filtrowi.
api_secretpozostaje więc jedyną ochroną tego interfejsu i powinien znajdować się wyłącznie na serwerze.
Data Manager API (od 7 maja 2026). To API jest alternatywą dla Measurement Protocol przy wysyłaniu zdarzeń zalecanych i niestandardowych bezpośrednio do strumieni danych z witryn i aplikacji. W kontekście tego artykułu daje czysty sposób przesyłania pobrań fetcherów z logów serwera jako osobnych zdarzeń – najlepiej do oddzielnej usługi (property), tak aby wskaźniki dotyczące ludzi pozostały nienaruszone.
Efektem jest wyraźny podział: główna usługa mierzy ludzi i oznaczone sesje agentów, a druga usługa lub zbiór danych w BigQuery gromadzi wyłącznie pobrania maszynowe.
Lista kontrolna na najbliższe 30 dni
Poniższe kroki opierają się na sobie nawzajem i da się je wdrożyć w ciągu miesiąca.
- Przegląd kanału „AI Assistant” i wymiaru „Source Group” w GA4 oraz zapisanie ich jako segmentu porównawczego
- Rozszerzenie logów serwera o klasę agenta i zebranie danych bazowych z jednego tygodnia
- Sprawdzenie, czy CDN lub WAF ocenia zweryfikowane boty i podpisy Web Bot Auth, oraz przekazanie wyniku dalej jako nagłówka
- Dodanie
traffic_classdo dataLayer i tagu Google, test zachowania cache - Zarejestrowanie wymiaru niestandardowego
traffic_classw GA4 - Utworzenie filtra uwzględniającego nazwy hostów w stanie testowym, aktywacja po porównaniu danych
- Przygotowanie zapytania w BigQuery i porównanie współczynników konwersji według klas
- Test narzędzia WebMCP w origin trial dla jednej kluczowej funkcji (wyszukiwanie, dostępność, zapytanie kontaktowe)
Podsumowanie
Kluczowym wskaźnikiem w 2026 roku nie jest już „Ile jest ruchu AI?”, lecz „Jaka część sesji w ogóle pochodzi od ludzi?”. Nowy kanał AI Assistant odpowiada tylko na pierwsze pytanie, i to wyłącznie dla kliknięć z referrerem.
Przeglądarki agentowe wykonują śledzenie, nie ujawniając, że są agentami. Rozdzielenie staje się wiarygodne dopiero dzięki klasyfikacji po stronie serwera, najlepiej na podstawie zweryfikowanych tożsamości z Web Bot Auth, list IP i oceny w CDN. Ta klasa powinna trafić do śledzenia jako osobny wymiar, a nie jako filtr nakładany po fakcie.
WebMCP pokazuje kierunek rozwoju: witryny, które świadomie oferują agentom funkcje, dostają w zamian czyste punkty pomiarowe. Zanim stanie się to standardem, to infrastruktura witryny decyduje o tym, czy dane analityczne nadal odzwierciedlają zachowanie ludzi.
Pytania i odpowiedzi
Dlaczego sesji agentowych nie da się odfiltrować w GA4 po fakcie?
Ponieważ GA4 widzi tylko to, co wysyła tag. Przeglądarka agentowa dostarcza takie same dane jak zwykły Chrome: tę samą przeglądarkę, często brak referrera albo dowolny referrer i normalnie wyzwalane zdarzenia. Lista botów IAB, na której opiera się filtrowanie botów w GA4, takich przeglądarek nie rozpoznaje.
Cechy, które naprawdę zdradzają agenta, są związane z pojedynczym żądaniem HTTP: podpis Web Bot Auth, pochodzenie z opublikowanej listy IP i dwuetapowe sprawdzenie przez reverse DNS. Te weryfikacje odbywają się w CDN lub na serwerze WWW. Dopiero gdy ich wynik trafia na stronę jako traffic_class, GA4 dostaje cechę, według której da się rozdzielić ruch. Ponieważ wymiary niestandardowe nie działają wstecz, rozdzielenie obowiązuje dopiero od dnia konfiguracji.
Dlaczego klasa ustalona na podstawie User-Agent ma w Nginx przedrostek „unverified:”?
Ponieważ User-Agent to deklaracja klienta, którą łatwo podrobić. Przedrostek oddziela w logach i raportach klasy sprawdzone przez CDN od klas jedynie zadeklarowanych. Nawet prawdziwy Google-Agent może się pojawić jako unverified:agent:google, jeśli CDN lub WAF nie zweryfikował jego żądania, tym bardziej że Google-Agent podpisuje na razie tylko część żądań.
Co dzieje się z klasą, gdy stronę dostarcza cache stron lub CDN?
Bez zabezpieczeń wszyscy odwiedzający dostają klasę tego, kto pobrał stronę jako pierwszy. Kod PHP wpisuje traffic_class na stałe do HTML. Jeśli ta wersja trafi do cache, każde kolejne wywołanie otrzymuje tę samą wartość, niezależnie od tego, czy pochodzi od człowieka, czy od agenta.
Poprawną klasę zapewniają trzy sposoby:
- Różnicowanie cache według klasy.
$agent_classstaje się częścią klucza cache. Klasa przyjmuje tylko kilka wartości, więc na każdą stronę przypada tylko kilka wersji. - Wstawianie klasy na brzegu sieci. Logika brzegowa wpisuje wartość do zbuforowanego HTML dopiero przy dostarczaniu, a sam cache pozostaje jednolity.
- Odczyt klasy w serwerowym Tag Managerze. HTML nie zawiera wtedy klasy, a kontener serwerowy odczytuje ją z nagłówka przychodzącego żądania pomiarowego. Warunkiem jest to, by również to żądanie przechodziło przez klasyfikujący CDN.
Niezależnie od tego log serwera jest kompletny tylko wtedy, gdy żądania docierają do serwera WWW. Jeśli CDN stojący przed serwerem dostarcza stronę z własnego cache, Nginx tego pobrania nie widzi. Wtedy do analizy należy włączyć także logi CDN.
Źródła
- Google Analytics: What’s new (Release Notes 2026)
- Google: lista fetcherów uruchamianych przez użytkownika (Google-Agent)
- HUMAN: 2026 State of AI Traffic & Cyberthreat Benchmark Report
- HUMAN: State of Agentic Traffic, August 2026
- HUMAN: Key Findings 2025
- Snowplow: Agentic Browsing Is Here
- Seer Interactive: The New Analytics Blind Spot
- TAGGRS: The impact of AI Browsers on user tracking
- Wikipedia: ChatGPT Atlas
- nohacks: The Agentic Browser Landscape in 2026
- PPC Land: Google-Agent joins the crawler list
- Contextbolt: Web Bot Auth
- IETF Draft: HTTP Message Signatures for automated traffic
- mcpplaygroundonline: WebMCP in 2026
- chudi.dev: What Is WebMCP?
Powiązane artykuły