English
 Deutsch
 Polski
AI-Modelle für Recherche und Dokumente: Gemini, GPT und Claude gegen offene LLMs

Management Summary
KI-Modelle wie Gemini, GPT und Claude können bei Recherchen und der Auswertung umfangreicher Unterlagen helfen. Im Büro oder in einer Redaktion sollen solche Systeme wichtige Angaben finden und verständlich zusammenfassen. Der Artikel erklärt, woran brauchbare Unterstützung erkennbar ist: Aussagen müssen vollständig, richtig und durch die passenden Unterlagen belegt sein. Eine flüssige Antwort allein genügt nicht. Der Nutzen entsteht durch eingesparte Arbeit, ohne Fehler oder übersehene Informationen in Entscheidungen zu übernehmen.
Inhalt
Eine gut lesbare Zusammenfassung kann wichtige Angaben auslassen oder falsche Quellen nennen. Bei Dokumenten zählt deshalb jeder Schritt: Datei einlesen, Text und Bilder erkennen, passende Stellen finden und Aussagen am Original prüfen. Dieser Vergleich beschreibt die dokumentierten Funktionen von Gemini 3.8 Flash, GPT-6.1 Sol, Claude Opus/Sonnet 5.5, DeepSeek V4.1 Flash und Qwen3.8-27B. Der Artikel enthält keinen eigenen Qualitätstest dieser Modelle. Stand der Quellenprüfung ist der 25. Oktober 2026.
Gemini und die Dokumentaufnahme
Gemini 3.8 Flash unterstützt laut Dokumentation PDF, Text, Bilder, Video und Audio als Eingaben. Datei- und Websuche sind zusätzliche unterstützte Werkzeuge. Such-Grounding bedeutet dabei, Antworten auf gefundene Quellen zu stützen. Die konkrete Anwendung muss diese Werkzeuge bereitstellen und verwenden. Bei PDFs kann Gemini auch sichtbare Tabellen und Abbildungen verarbeiten; Dateigröße, Seitenzahl und Eingabelimits bleiben zu beachten. Eine unterstützte Datei ist noch kein Beleg dafür, dass jede Fußnote korrekt gelesen wurde. [3, 7]
GPT und Claude im selben Prüfrahmen
GPT-6.1 Sol sowie Claude Opus 5.5 und Sonnet 5.5 unterstützen Text- und Bildeingaben. [1, 2] Für einen fairen Vergleich müssen dieselben Dokumente und Fragen vorliegen. Außerdem gehören die eingesetzten Suchwerkzeuge ins Protokoll. Eine Antwort nach Websuche ist nicht direkt mit einer Antwort aus dem Modellwissen allein vergleichbar. Getrennte Tests zeigen, ob ein Fehler beim Finden der Quelle oder beim Lesen und Zusammenfassen entsteht.
Was offene Modelle zusätzlich brauchen
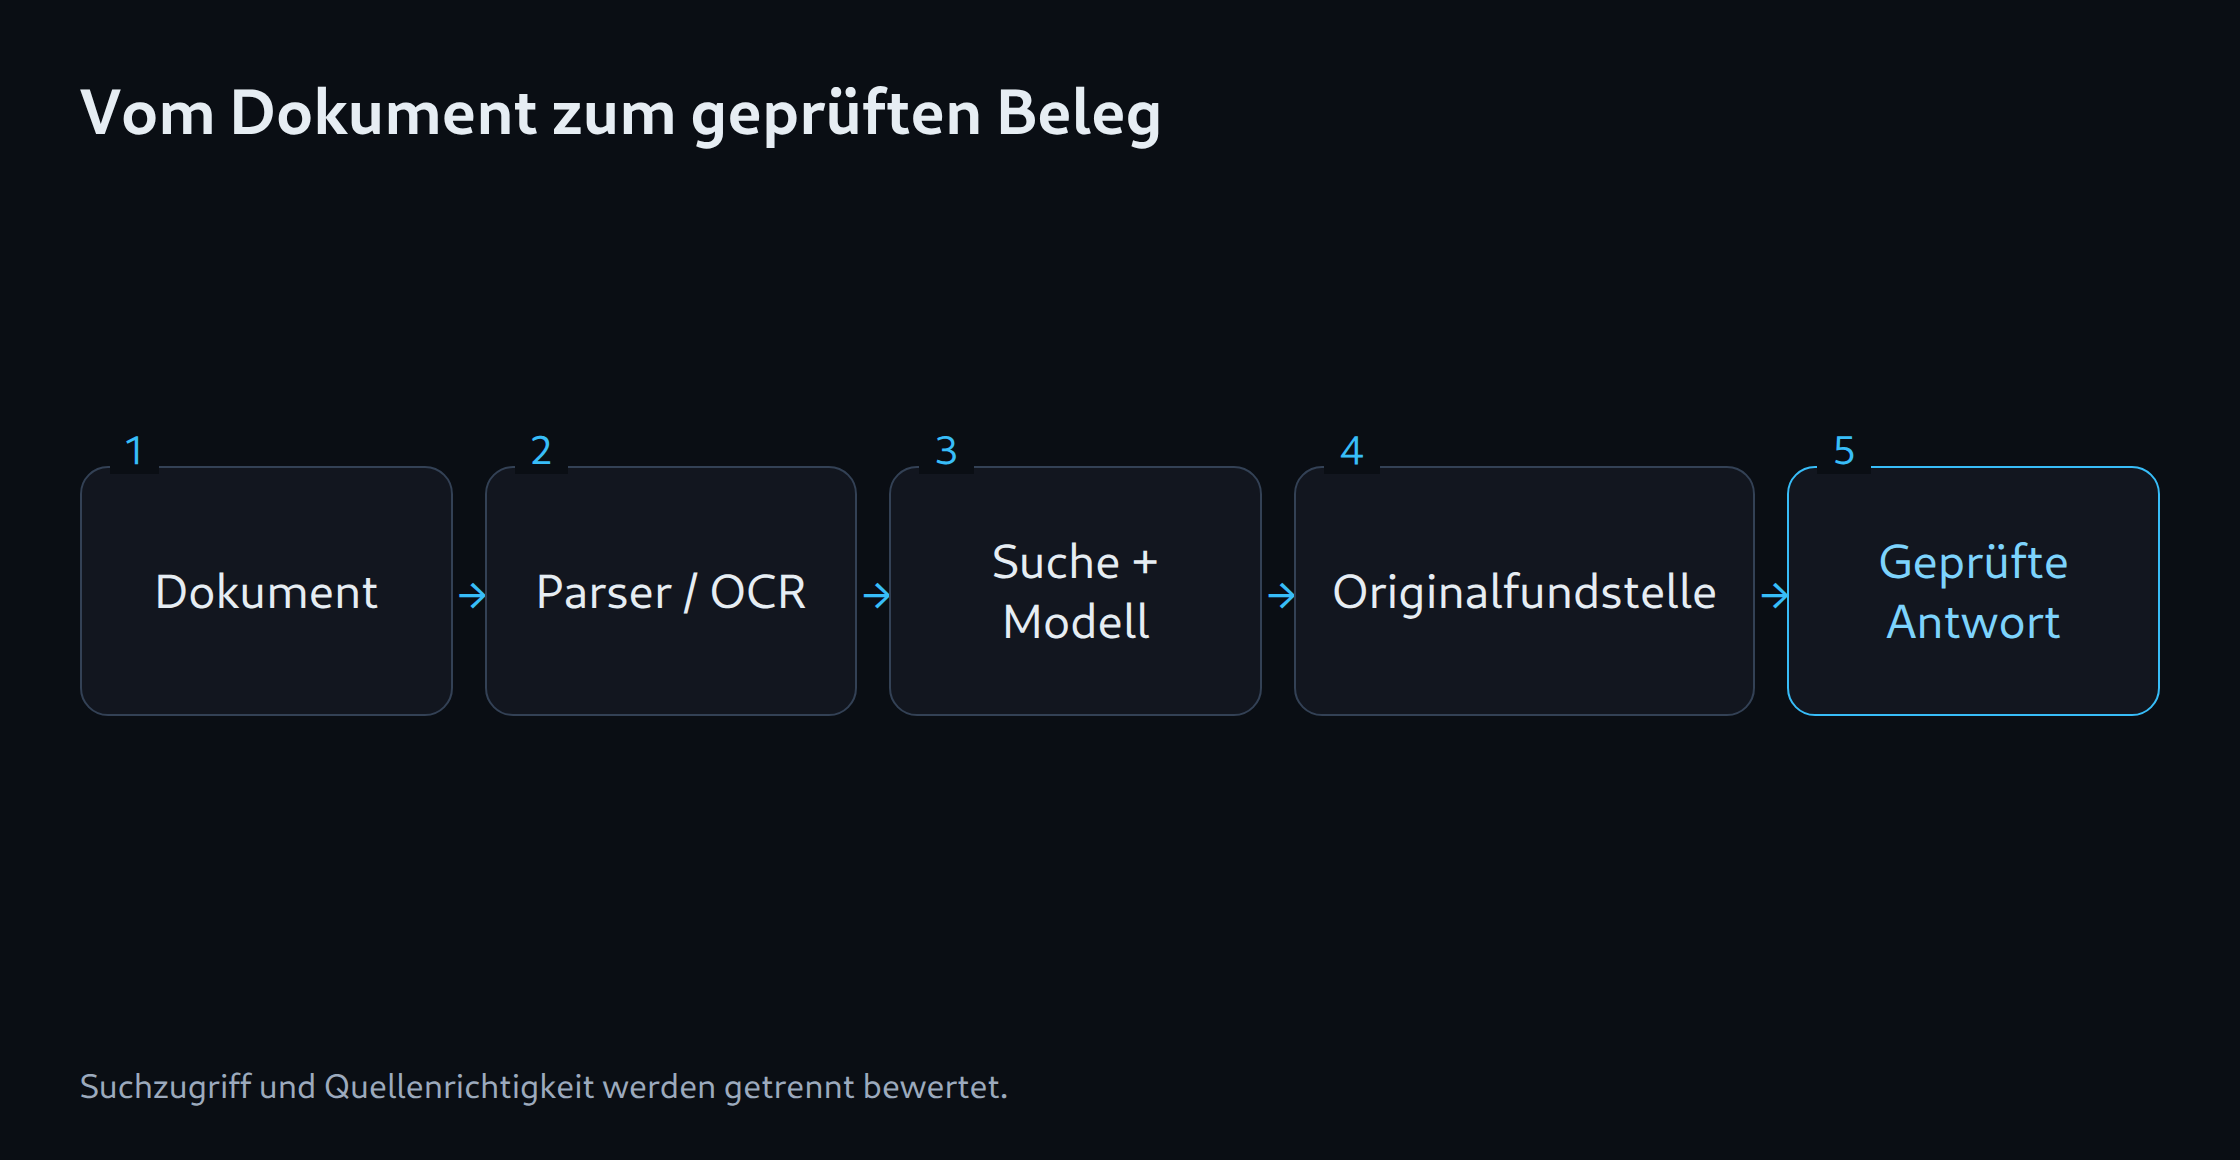
DeepSeek V4.1 Flash und Qwen3.8-27B veröffentlichen Modellgewichte für die Verarbeitung von Text und Bildern. Gewichte sind die gespeicherten Parameter eines trainierten Modells. Ein Download allein ergibt noch keine fertige Dokumentensuche. Ein Parser liest die Dateistruktur; OCR wandelt gescannte Schrift in Text um. Ein Suchindex macht den Bestand auffindbar, und Retrieval bezeichnet das Heraussuchen passender Stellen. Nicht jeder Ablauf benötigt alle diese Schritte. [4, 5] Für vollständig lokale Verarbeitung müssen auch diese Hilfsdienste lokal arbeiten. Ollama bietet zusätzlich Cloud-Modelle und Websuche an; allein der Programmname belegt daher keinen lokalen Datenweg. Modell- und Laufzeitunterstützung für Bilder müssen ebenfalls zusammenpassen. [6]
| Vergleichspunkt | Cloud-Ablauf | Lokaler Ablauf |
|---|---|---|
| Dokumentaufnahme | Unterstützter Upload / API-Eingabe | Parser, OCR und Bildunterstützung |
| Wissenszugriff | Eingerichtete Datei- oder Websuche | Eigener Index und Retrieval |
| Quellenbeleg | Abgleich mit der Originalfundstelle | Abgleich mit der Fundstelle im lokalen Dokument |
| Aktualität | Datum der gefundenen Quelle | Stand des Indexbestands |
Ein Test mit überprüfbaren Antworten
Ein sinnvoller Testvorschlag umfasst einen kurzen Bericht, eine lange PDF mit Tabellen, einen Scan und zwei Fassungen mit widersprüchlichen Angaben. Eine Aufgabe könnte lauten, den Umsatz aus einer bestimmten Tabellenzeile zu nennen und Seite sowie Zeile anzugeben. Weitere Aufgaben prüfen Zusammenfassung, Widersprüche und eine Frage, deren Antwort in den Unterlagen fehlt. Die erwarteten Fakten und Fundstellen stehen vor dem Test fest; dieses Paket ist hier ein Vorschlag, kein bereits durchgeführter Versuch.
Das Protokoll zählt richtige Aussagen, fehlende Pflichtangaben und erfundene Belege getrennt. Eine fehlende Antwort muss als fehlend erkennbar bleiben. Bei einer genannten Zahl gehören auch Einheit, Zeitraum und Tabellenüberschrift zur Kontrolle. Ein Link auf die richtige Website genügt nicht, wenn die Zahl nur in einer anderen Ausgabe vorkommt oder dort überhaupt fehlt. Mehrere Durchläufe zeigen zusätzlich, ob die Ergebnisse stabil bleiben.
Die redaktionelle Entscheidung
Gemini kommt wegen der dokumentierten Eingabeformate für gemischte Dateien infrage. GPT und Claude sind weitere Kandidaten für denselben Dokumententest. Modelle mit veröffentlichten Gewichten erlauben einen selbst betriebenen Ablauf, sofern Hardware, Software und Nutzungsbedingungen passen. Das belegt weder einen Qualitätsvorsprung noch automatisch vertrauliche Verarbeitung. Eine belastbare Auswahl berücksichtigt korrekte Antworten, fehlende Informationen, Laufzeit, Kosten und den tatsächlichen Datenweg.
Passende Werkzeuge
Fragen und Antworten
Ersetzt ein großes Kontextfenster die Suche?
Das Kontextfenster begrenzt, wie viel Material ein Modell in einem Aufruf berücksichtigen kann. Suche wählt passende Stellen aus einem größeren Bestand aus. Auch ein Dokument, das vollständig in das Fenster passt, kann fehlerhaft ausgewertet werden. Ein großes Fenster ersetzt deshalb weder die Auswahl der richtigen Quellen noch die Kontrolle der Antwort.
Sind ausgegebene Quellen automatisch zuverlässig?
Nein. Eine Quellenangabe kann auf die richtige Datei zeigen und trotzdem die falsche Aussage belegen. Wichtige Zahlen und Zitate benötigen einen Abgleich mit der konkreten Seite, Tabelle oder Passage im Original.
Quellen
- OpenAI: GPT-6.1 Sol
- Anthropic: Übersicht der Claude-Modelle
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash Modellbeschreibung
- Qwen: Qwen3.8-27B Modellbeschreibung
- Ollama: Fragen zum lokalen Betrieb und zur Cloud
- Google: Dokumentverarbeitung
Quellen geprüft: 25. Oktober 2026.
Passend dazu