English
 Deutsch
 Polski
Modele AI do badań i dokumentów: Gemini, GPT i Claude wobec otwartych LLM

Management Summary
Modele AI, takie jak Gemini, GPT i Claude, mogą pomagać w poszukiwaniu informacji i analizie obszernych dokumentów. W biurze lub redakcji mają znajdować ważne fakty i zrozumiale je podsumowywać. Artykuł wyjaśnia, co wyróżnia przydatne wsparcie: stwierdzenia muszą być poprawne, dostatecznie pełne i potwierdzone właściwymi źródłami. Płynny tekst nie wystarcza. Korzyścią jest oszczędzona praca bez przenoszenia błędów lub pominiętych informacji do decyzji.
Spis treści
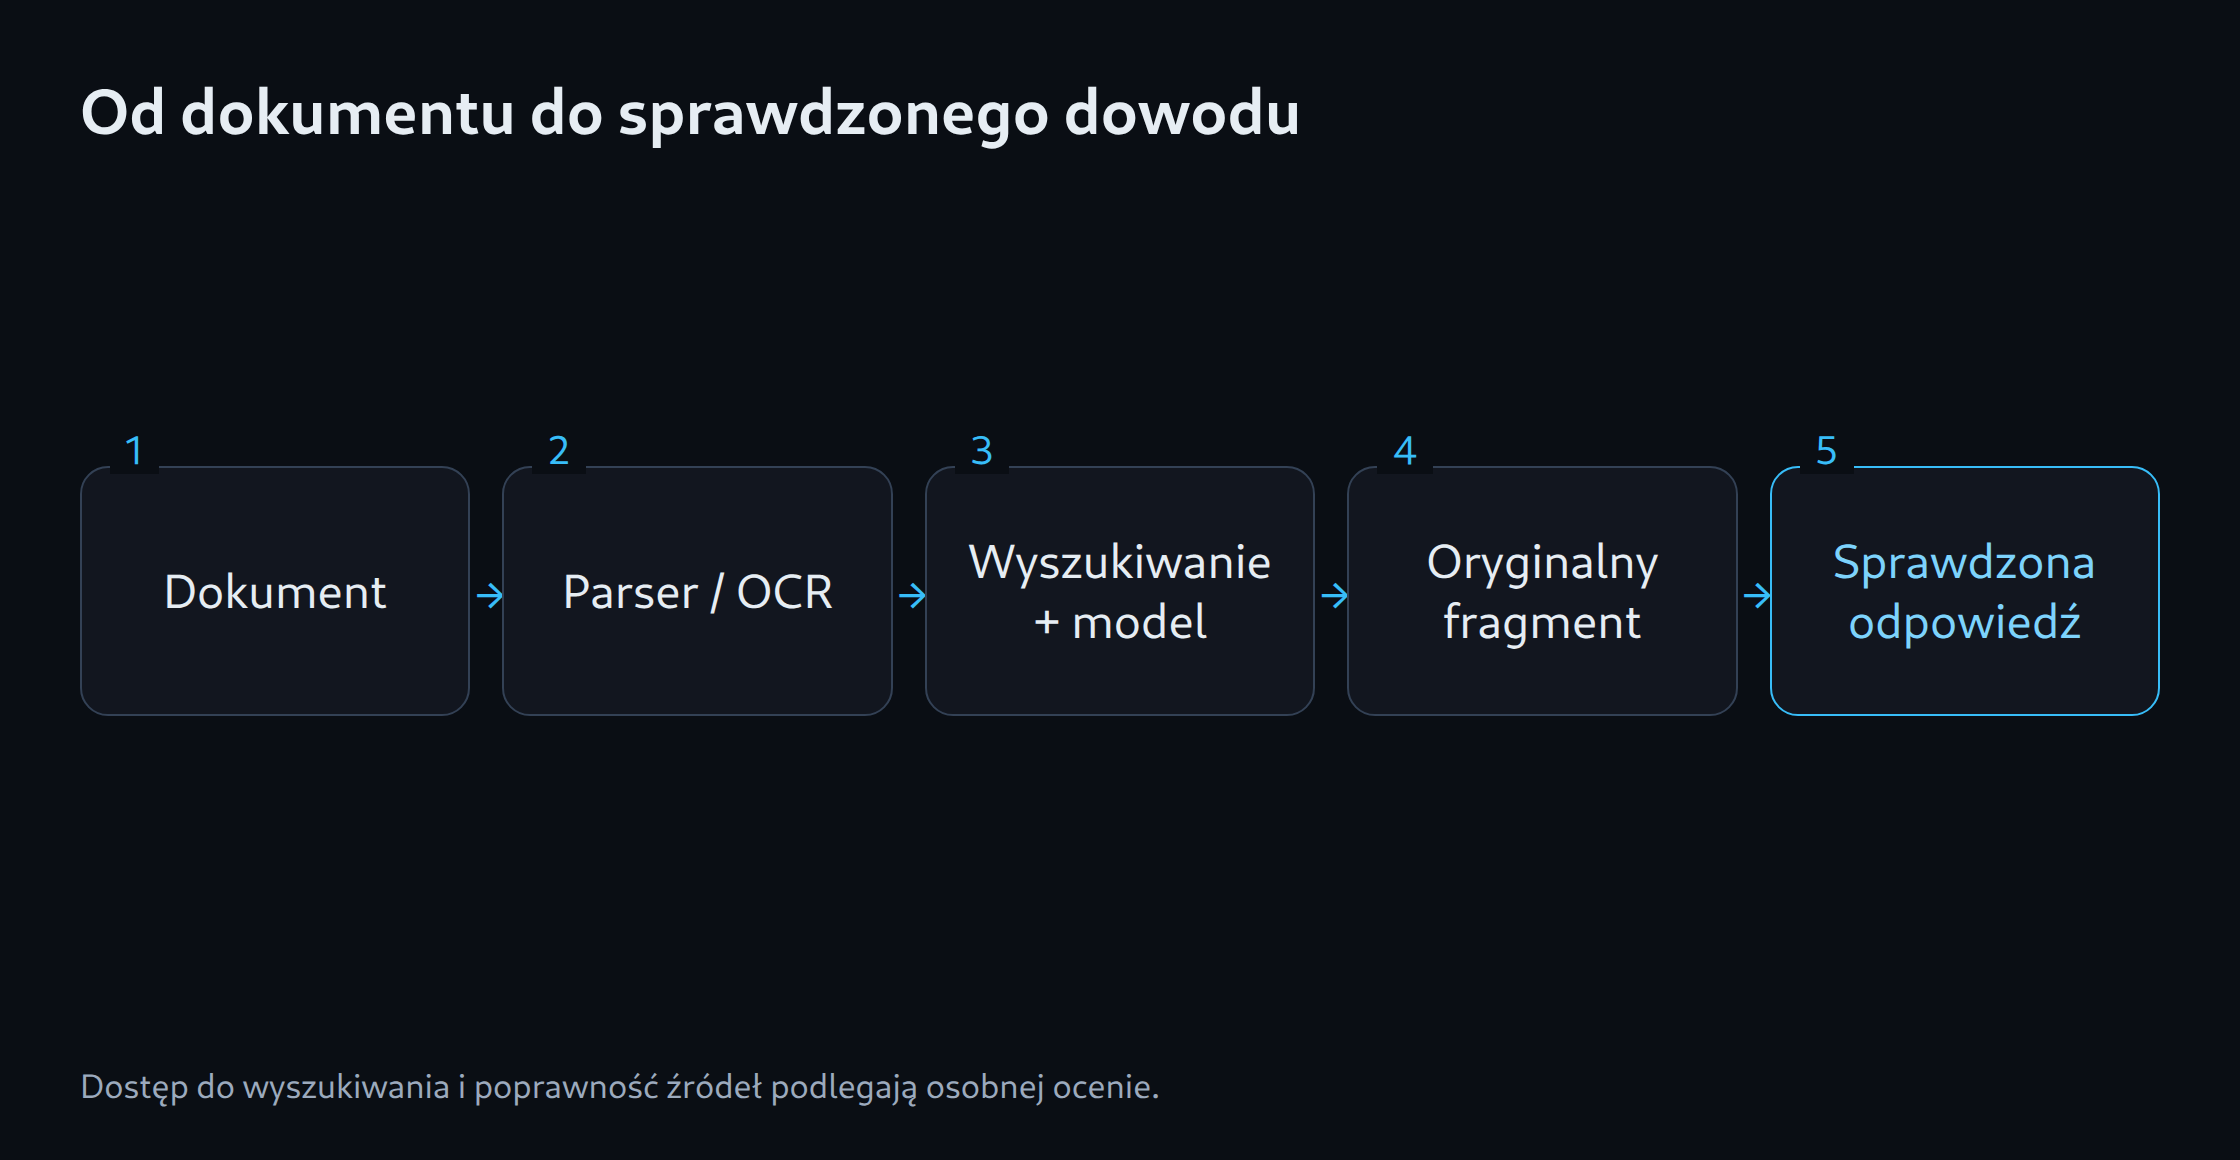
Czytelne streszczenie może pomijać ważne informacje albo wskazywać błędne źródła. Liczy się więc każdy etap: wczytanie pliku, rozpoznanie tekstu i obrazów, znalezienie odpowiednich fragmentów oraz sprawdzenie twierdzeń w oryginale. Porównanie opisuje udokumentowane funkcje Gemini 3.8 Flash, GPT-6.1 Sol, Claude Opus/Sonnet 5.5, DeepSeek V4.1 Flash i Qwen3.8-27B. Nie przedstawia własnego testu jakości tych modeli. Źródła sprawdzono 25 października 2026.
Gemini i wczytywanie dokumentów
Dokumentacja Gemini 3.8 Flash potwierdza obsługę PDF, tekstu, obrazów, wideo i dźwięku na wejściu. Wyszukiwanie plików oraz sieci to dodatkowe obsługiwane narzędzia. Search grounding oznacza opieranie odpowiedzi na znalezionych źródłach. Aplikacja musi udostępniać i wykorzystywać te narzędzia. W PDF Gemini może przetwarzać także widoczne tabele i ilustracje; nadal obowiązują limity wielkości pliku, liczby stron i danych wejściowych. Obsługa formatu nie dowodzi poprawnego odczytania każdego przypisu. [3, 7]
GPT i Claude według wspólnego protokołu
GPT-6.1 Sol, Claude Opus 5.5 i Sonnet 5.5 obsługują tekst oraz obrazy. [1, 2] Rzetelne porównanie wymaga tych samych dokumentów i pytań. Protokół powinien też wskazywać użyte narzędzia wyszukiwania. Odpowiedź po przeszukaniu sieci nie jest bezpośrednio porównywalna z odpowiedzią opartą tylko na wiedzy modelu. Oddzielne próby pomagają ustalić, czy błąd powstał podczas szukania źródła, czy podczas odczytu i streszczania.
Dodatkowe elementy otwartych modeli
DeepSeek V4.1 Flash i Qwen3.8-27B udostępniają wagi modeli przetwarzających tekst i obrazy. Wagi to zapisane parametry wytrenowanego modelu. Samo pobranie nie tworzy gotowej wyszukiwarki dokumentów. Parser odczytuje strukturę pliku, a OCR zamienia zeskanowane pismo na tekst. Indeks umożliwia przeszukiwanie zbioru, natomiast retrieval oznacza wybieranie odpowiednich fragmentów. Nie każdy proces wymaga wszystkich tych etapów. [4, 5] Pełne przetwarzanie lokalne wymaga lokalnego działania także usług pomocniczych. Ollama oferuje również modele chmurowe i wyszukiwanie internetowe, więc sama nazwa programu nie potwierdza lokalnego przetwarzania danych. Model i środowisko uruchomieniowe muszą wspólnie obsługiwać obrazy. [6]
| Punkt porównania | Przebieg chmurowy | Przebieg lokalny |
|---|---|---|
| Wczytywanie | Obsługiwany upload / wejście API | Parser, OCR i obsługa obrazu |
| Dostęp do wiedzy | Skonfigurowane wyszukiwanie plików lub sieci | Własny indeks i wyszukiwanie |
| Dowód źródłowy | Porównanie z fragmentem oryginału | Porównanie z fragmentem lokalnego pliku |
| Aktualność | Data znalezionego źródła | Data aktualizacji indeksu |
Test z weryfikowalnymi odpowiedziami
Proponowany pakiet testowy zawiera krótki raport, długi PDF z tabelami, skan i dwie wersje ze sprzecznymi informacjami. Jedno zadanie może dotyczyć odczytu przychodu z określonego wiersza tabeli wraz z numerem strony i wskazaniem wiersza. Kolejne zadania sprawdzają streszczenie, wykrywanie sprzeczności i pytanie bez odpowiedzi w dokumentach. Oczekiwane fakty oraz miejsca w źródłach są zapisane przed testem. To propozycja pakietu, a nie opis wykonanego eksperymentu.
Protokół osobno zlicza poprawne twierdzenia, brakujące wymagane informacje i wymyślone dowody. Brak odpowiedzi powinien być wyraźnie wskazany. Przy podanej liczbie trzeba również sprawdzić jednostkę, okres i nagłówek tabeli. Link do właściwej witryny nie wystarcza, jeśli liczba pochodzi z innego wydania albo w ogóle nie występuje. Powtórzenie prób pozwala dodatkowo ocenić stabilność wyników.
Redakcyjna lista kandydatów
Gemini jest kandydatem do pracy z różnymi plikami ze względu na udokumentowane formaty wejściowe. GPT i Claude to kolejne modele do tego samego testu dokumentowego. Modele z udostępnionymi wagami pozwalają samodzielnie uruchomić przetwarzanie, jeśli umożliwiają to sprzęt, oprogramowanie i warunki użycia. Nie dowodzi to przewagi jakościowej ani automatycznie poufnego przetwarzania. Wybór powinien uwzględniać poprawność odpowiedzi, pominięcia, czas działania, koszt i rzeczywistą drogę danych.
Powiązane narzędzia
Pytania i odpowiedzi
Czy duże okno kontekstu zastępuje wyszukiwanie?
Okno kontekstu ogranicza ilość materiału uwzględnianego przez model w jednym wywołaniu. Wyszukiwanie wybiera odpowiednie fragmenty z większego zbioru. Nawet dokument mieszczący się w całości w oknie może zostać błędnie zinterpretowany. Duże okno nie zastępuje więc doboru źródeł ani kontroli odpowiedzi.
Czy wygenerowane źródła są zawsze wiarygodne?
Nie. Odsyłacz może prowadzić do właściwego pliku, ale nie potwierdzać twierdzenia. Ważne liczby i cytaty wymagają porównania z konkretną stroną, tabelą albo fragmentem oryginału.
Źródła
- OpenAI: GPT-6.1 Sol
- Anthropic: Przegląd modeli Claude
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash Opis modelu
- Qwen: Qwen3.8-27B Opis modelu
- Ollama: Pytania o działanie lokalne i chmurę
- Google: Przetwarzanie dokumentów
Źródła sprawdzone: 25 października 2026.
Powiązane artykuły