English
 Deutsch
 Polski
AI-Modelle fürs Coding: GPT und Claude gegen DeepSeek und Qwen

Management Summary
KI-Modelle können bei der Softwareentwicklung Änderungen vorschlagen und Programmieraufgaben übernehmen. Der Artikel vergleicht GPT, Claude, DeepSeek und Qwen als mögliche Unterstützung in eigenen Projekten. Ziel ist weniger Entwicklungsarbeit bei verlässlich funktionierender Software. Ein schnell erzeugter Vorschlag reicht dafür nicht: Neue Fehler und nötige Korrekturen können den Vorteil aufzehren. Deshalb zählt die Qualität der fertigen Änderung samt Zeit und Kosten, statt allein ein guter Herstellerwert.
Inhalt
Ein Coding-Modell hilft, wenn eine Änderung im vorhandenen Projekt funktioniert. Eine einzelne Funktion zu schreiben ist eine andere Aufgabe als einen Fehler über mehrere Dateien hinweg zu beheben. Ein Agent verbindet das Modell mit Werkzeugen, etwa zum Lesen von Dateien und Ausführen von Tests. Dieser Vergleich vom 26. Oktober 2026 beschreibt einen Testplan für GPT-6 Astra und GPT-6.1 Sol, Claude Opus und Sonnet 5.5, Gemini 3.8 Flash, DeepSeek V4.1 Flash und Qwen3.8-27B. Eigene Erfolgsquoten liegen nicht vor.
Cloud-Kandidaten und offene Gewichte
Die genannten Cloud-Modelle können über Programmschnittstellen angesprochen und mit Werkzeugen verbunden werden. OpenAI nennt Astra für anspruchsvolle Aufgaben; Anthropic beschreibt Opus 5.5 für längere Arbeitsabläufe mit Code und Werkzeugen. Gemini 3.8 Flash unterstützt unter anderem Funktionsaufrufe und Codeausführung. Das beschreibt verfügbare Funktionen, aber noch keinen Beleg, welches Modell einen bestimmten Projektfehler am besten behebt. [1, 4, 6]
DeepSeek und Qwen veröffentlichen Modellgewichte, also die gespeicherten Zahlen ihrer Modelle. Qwen dokumentiert Ausführungsprogramme und Bedingungen der veröffentlichten Tests. Andere Modellzahlenformate oder andere Agentenprogramme können andere Ergebnisse liefern. Quantisierung spart Speicher durch eine kompaktere Speicherung der Zahlen. Ein lokaler Lauf mit einer solchen Variante wiederholt deshalb nicht automatisch den Herstellertest. [7, 8]
Was der Vergleich messen sollte
| Aufgabe | Für alle Modelle messen | Zusätzlich dokumentieren |
|---|---|---|
| Kleine Funktion | Korrektheit und Zeit bis zur brauchbaren Ausgabe | Modellstart getrennt von Antwortzeit |
| Projektfehler | Änderung und unveränderte bestandene Tests | Exakte Modell- und Programmversion |
| Agentenarbeit | Werkzeugschritte, Abbrüche und Gesamtkosten | Erlaubte Werkzeuge und verfügbarer Speicher |
| Codeprüfung | Gefundene bekannte Fehler und Fehlalarme | Gleiche Fehlerliste für alle Kandidaten |
Ein konkreter Test im vorhandenen Projekt
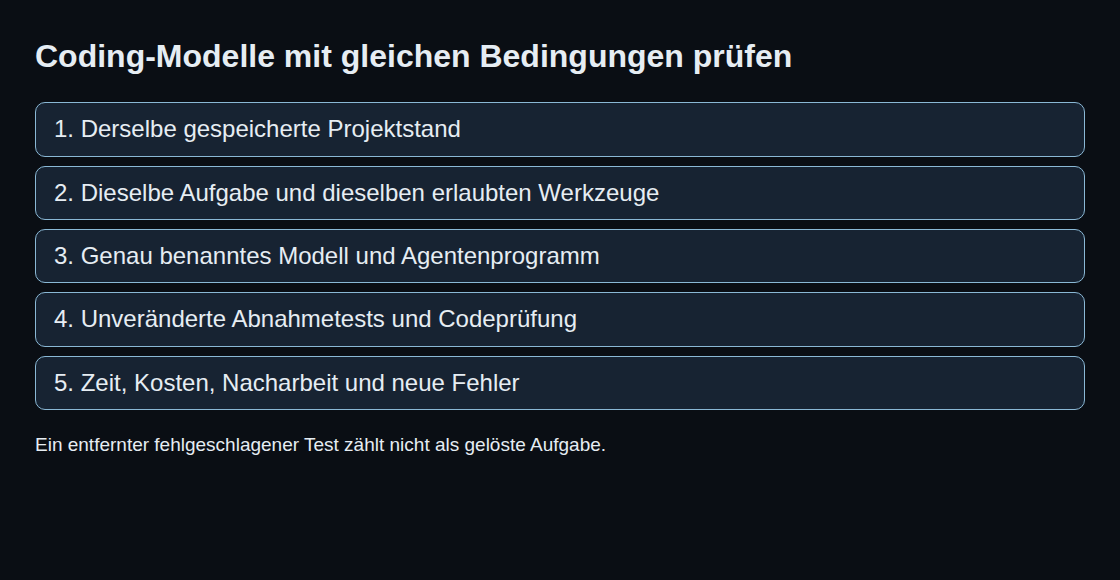
Der vorgeschlagene Testplan enthält sechs Aufgaben: einen nachstellbaren Fehler beheben, eine kleine Funktion ergänzen, eine Programmschnittstelle anpassen, Code ohne beabsichtigte Verhaltensänderung umstrukturieren, einen sinnvollen Test ergänzen und bekannte Fehler bei einer Codeprüfung finden. Jeder Lauf beginnt mit demselben gespeicherten Projektstand, dem Commit. Die unabhängigen Abnahmetests bleiben gleich. Das Entfernen eines fehlgeschlagenen Tests zählt nicht als Fehlerbehebung.
Das Protokoll hält fest, welche Aufgaben gelöst wurden und ob bisher funktionierendes Verhalten kaputtging. Solche neu verursachten Fehler heißen Regressionen. Zusätzlich zählen unnötige Dateiänderungen, Korrekturarbeit, Laufzeit und Kosten. Tokens sind die Texteinheiten, nach denen viele APIs abrechnen; gleiche Tokenzahlen kosten bei verschiedenen Anbietern nicht gleich viel. Wiederholungen zeigen Schwankungen. Bei verschiedenen Agentenprogrammen wird das Gesamtsystem verglichen, nicht nur das Modell.
Wann lokal besonders sinnvoll ist
Ein lokales Modell kommt infrage, wenn Quellcode den eigenen Betrieb nicht verlassen soll. Dafür müssen sowohl der Modellaufruf als auch Werkzeuge lokal arbeiten. Ollama unterstützt nur passende Modellarchitekturen und Dateiformate; ein bekannter Modellname genügt nicht. Zusätzlich brauchen Modell und berücksichtigter Projekttext genügend Speicher. Bei MoE-Modellen wie DeepSeek werden pro Rechenschritt nur Teile des Modells genutzt. Die übrigen Teile müssen dennoch irgendwo gespeichert und verfügbar sein; aktive Parameter sind deshalb kein vollständiges Speicherbudget. [7, 9]
Ein Wechsel zu einem anderen Modell folgt einem vorher festgelegten Kriterium. Beispiel: Nach zwei Versuchen scheitert dieselbe Aufgabe weiterhin am unveränderten Abnahmetest. Dann kann ein anderer Kandidat dieselbe Aufgabe erhalten. Ein Cloud-Wechsel kommt nur infrage, wenn die Übertragung des betroffenen Codes zulässig ist. Das ist ein vorgeschlagener Ablauf, kein Nachweis einer höheren Cloud-Erfolgsquote.
Passende Werkzeuge
Fragen und Antworten
Ist eine hohe Coding-Benchmarkzahl genug?
Ein Herstellerwert gilt für die dort verwendeten Aufgaben, Werkzeuge und Einstellungen. Der Projekttest prüft dagegen die tatsächlich benötigten Änderungen. Wiederholungen und eine unabhängige Codeprüfung ergänzen die automatischen Tests.
Bleibt Code mit Ollama automatisch lokal?
Auch Werkzeuge können Code übertragen. Entscheidend sind das gewählte Modell, dessen Ausführungsort und jede angebundene Funktion. Ollama bietet sowohl lokale als auch Cloud-Funktionen; der Programmname allein garantiert keine rein lokale Verarbeitung.
Quellen
- OpenAI: Modellkatalog
- OpenAI: GPT-6.1 Sol
- Anthropic: Modellübersicht
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: Modellkarte V4.1 Flash
- Qwen: Modellkarte Qwen3.8-27B
- Ollama: Fragen zu lokalem Betrieb und Cloud
- OpenAI: API-Preise
- DeepSeek: Modelle und Preise
- Google: Dokumentverarbeitung
Quellen geprüft: 26. Oktober 2026.
Passend dazu