English
 Deutsch
 Polski
Modele AI do programowania: GPT i Claude wobec DeepSeek i Qwen

Management Summary
Modele AI mogą proponować zmiany w oprogramowaniu i pomagać w zadaniach programistycznych. Artykuł porównuje GPT, Claude, DeepSeek i Qwen jako wsparcie we własnych projektach. Celem jest mniej pracy przy zachowaniu niezawodnego działania programu. Szybko przygotowana propozycja nie wystarcza: nowe błędy i poprawki mogą zniwelować korzyść. Liczy się więc gotowa zmiana, czas i pełny koszt, a nie sam korzystny wynik podany przez producenta.
Spis treści
Model do programowania pomaga wtedy, gdy jego zmiana działa w istniejącym projekcie. Napisanie jednej funkcji różni się od naprawienia błędu obejmującego kilka plików. Agent łączy model z narzędziami, na przykład odczytem plików i uruchamianiem testów. Porównanie z 26 października 2026 proponuje plan testów dla GPT-6 Astra i GPT-6.1 Sol, Claude Opus i Sonnet 5.5, Gemini 3.8 Flash, DeepSeek V4.1 Flash oraz Qwen3.8-27B. Nie podaje własnych pomiarów skuteczności.
Kandydaci chmurowi i otwarte wagi
Wymienione modele chmurowe są dostępne przez interfejsy programistyczne i mogą korzystać z podłączonych narzędzi. OpenAI opisuje Astra jako model do wymagających zadań. Anthropic przedstawia Opus 5.5 jako model do dłuższej pracy z kodem i narzędziami. Gemini 3.8 Flash obsługuje między innymi wywołania funkcji i wykonywanie kodu. To dostępne możliwości, a nie dowód, który model najlepiej naprawi konkretny błąd projektu. [1, 4, 6]
DeepSeek i Qwen publikują wagi, czyli zapisane liczby tworzące modele. Qwen dokumentuje programy wykonujące obliczenia i warunki opublikowanych testów. Inne formaty liczb lub programy agentowe mogą dać inne wyniki. Kwantyzacja oszczędza pamięć przez bardziej zwarty zapis liczb. Lokalny test takiego wariantu nie odtwarza więc automatycznie testu producenta. [7, 8]
Zakres pomiaru
| Zadanie | Pomiary dla każdego modelu | Dodatkowy zapis |
|---|---|---|
| Mała funkcja | Poprawność i czas do użytecznej odpowiedzi | Start modelu oddzielnie od czasu odpowiedzi |
| Błąd projektu | Zmiana i zaliczone niezmienione testy | Dokładne wersje modelu i programu |
| Praca agenta | Wywołania narzędzi, przerwania i pełny koszt | Dozwolone narzędzia i dostępna pamięć |
| Przegląd kodu | Wykryte znane błędy i fałszywe alarmy | Ta sama lista usterek dla wszystkich modeli |
Konkretny plan testów projektu
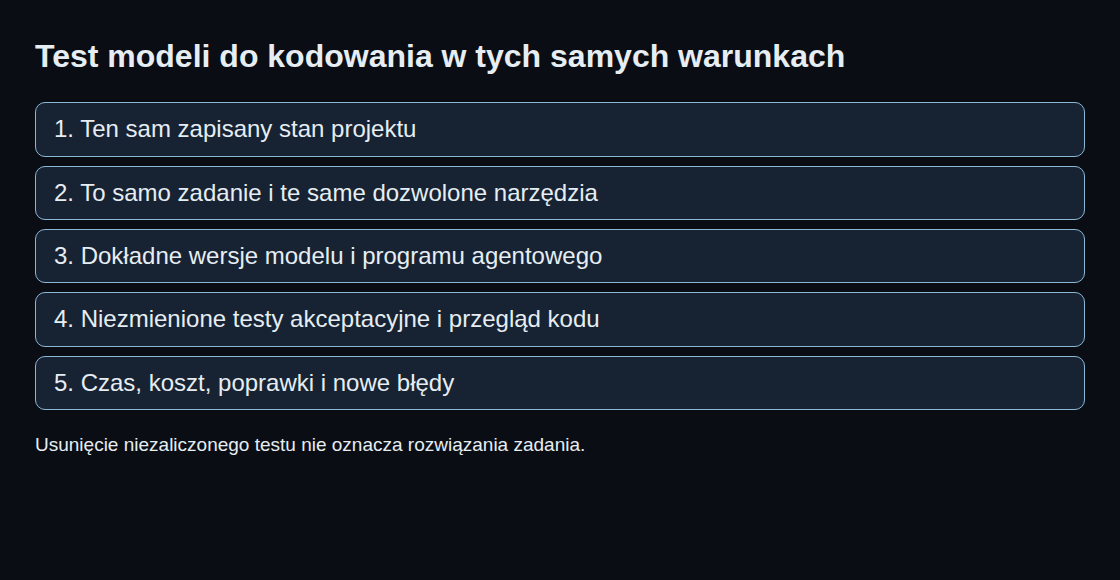
Proponowany plan zawiera sześć zadań: naprawienie odtwarzalnego błędu, dodanie małej funkcji, dostosowanie interfejsu programistycznego, uporządkowanie kodu bez zamierzonej zmiany działania, dodanie przydatnego testu i znalezienie znanych usterek podczas przeglądu kodu. Każdy przebieg zaczyna się od tego samego zapisanego stanu projektu, czyli commita. Niezależne testy akceptacyjne pozostają niezmienione. Usunięcie niezaliczonego testu nie oznacza naprawienia błędu.
Protokół zapisuje rozwiązane zadania oraz przypadki uszkodzenia wcześniej działających funkcji. Takie nowe błędy nazywają się regresjami. Liczą się też zbędne zmiany plików, praca przy poprawkach, czas i koszty. Tokeny to jednostki tekstu, według których wiele API nalicza opłaty; ta sama liczba tokenów nie kosztuje tyle samo u różnych dostawców. Powtórzenia ujawniają zmienność wyników. Różne programy agentowe oznaczają porównanie całych systemów, a nie wyłącznie modeli.
Kiedy lokalne działanie ma sens
Model lokalny jest rozwiązaniem do sprawdzenia, gdy kod źródłowy ma pozostać w organizacji. Warunek ten dotyczy zarówno wywołania modelu, jak i narzędzi. Ollama wymaga zgodnej architektury i formatu pliku; sama znana nazwa modelu nie wystarcza. Model i uwzględniany tekst projektu potrzebują też wystarczającej pamięci. W modelach MoE, takich jak DeepSeek, każdy krok obliczeń używa tylko części modelu. Pozostałe części nadal wymagają przechowywania i dostępności. Liczba aktywnych parametrów nie określa więc całego zapotrzebowania na pamięć. [7, 9]
Zmiana modelu wynika z kryterium ustalonego wcześniej. Przykład: po dwóch próbach to samo zadanie nadal nie przechodzi niezmienionego testu akceptacyjnego. Wtedy identyczne zadanie może otrzymać inny kandydat. Przejście do chmury jest możliwe tylko wtedy, gdy przesłanie danego kodu jest dozwolone. To proponowany sposób pracy, a nie dowód wyższej skuteczności modeli chmurowych.
Powiązane narzędzia
Pytania i odpowiedzi
Czy wysoki wynik benchmarku programistycznego wystarcza?
Wynik producenta dotyczy użytych tam zadań, narzędzi i ustawień. Test projektu sprawdza natomiast rzeczywiście potrzebne zmiany. Powtórzenia i niezależny przegląd kodu uzupełniają testy automatyczne.
Czy Ollama automatycznie zachowuje kod lokalnie?
Narzędzia również mogą przesyłać kod. Znaczenie mają wybrany model, miejsce wykonywania obliczeń i każda podłączona funkcja. Ollama oferuje pracę lokalną i chmurową; sama nazwa programu nie gwarantuje wyłącznie lokalnego przetwarzania.
Źródła
- OpenAI: katalog modeli
- OpenAI: GPT-6.1 Sol
- Anthropic: przegląd modeli
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: karta modelu V4.1 Flash
- Qwen: karta modelu Qwen3.8-27B
- Ollama: pytania o pracę lokalną i chmurową
- OpenAI: ceny API
- DeepSeek: modele i ceny
- Google: przetwarzanie dokumentów
Źródła sprawdzone: 26 października 2026.
Powiązane artykuły