English
 Deutsch
 Polski
AI-Modelle nach Kosten vergleichen: Cloud-API oder DeepSeek und Qwen lokal?

Management Summary
Unternehmen können KI als gemieteten Dienst nutzen oder passende Modelle wie DeepSeek und Qwen auf eigenen Rechnern betreiben. Der Artikel erklärt die Kosten dieser beiden Wege für alltägliche KI-Aufgaben. Beim eigenen Gerät fallen Anschaffung, Strom und Pflege an; beim externen Dienst entstehen Nutzungsgebühren. Der Vergleich soll wirtschaftliche Entscheidungen ermöglichen. Maßgeblich ist der Preis eines brauchbaren Ergebnisses einschließlich Wiederholungen und Nacharbeit, nicht der billigste einzelne Aufruf.
Inhalt
Ein niedriger Preis für eine Modellanfrage bedeutet noch keine günstige erledigte Aufgabe. Falsche Antworten können weitere Versuche und manuelle Korrekturen nötig machen. Dieser Vergleich verwendet die am 25. Oktober 2026 gelesenen API-Preise. API bedeutet hier die Programmierschnittstelle eines Cloud-Anbieters. Davon getrennt stehen angenommene Kosten für Modelle auf eigener Hardware.
Ein transparenter Tarifvergleich
Tokens sind die Einheiten, in die ein Modell Texte zerlegt, etwa Wörter oder Wortteile. Verschiedene Modelle können denselben Text unterschiedlich zählen. Das Rechenbeispiel setzt trotzdem bei jedem Anbieter dieselben Mengen an: insgesamt eine Million Eingabetokens ohne Cache-Rabatt und 200.000 abrechenbare Ausgabetokens, verteilt auf viele kurze Anfragen. Interne Denk-Tokens gehören zur Ausgabe, soweit der Anbieter diese abrechnet. Die Tabelle zeigt USD ohne Steuern, Werkzeuge, Cache-Schreibkosten, Sonderrabatte und regionale Aufschläge. Für OpenAI gilt der Standardtarif mit kurzem Kontext. [10]
| Modell | Input / Output je Million | Beispielsumme |
|---|---|---|
| GPT-6 Astra | 10 / 50 USD | 20 USD |
| GPT-6.1 Sol | 2 / 10 USD | 4 USD |
| Claude Opus 5.5 | 4 / 20 USD | 8 USD |
| Claude Sonnet 5.5 | 2 / 10 USD | 4 USD |
| Gemini 3.8 Flash | 0,75 / 3,75 USD | 1,50 USD |
| DeepSeek V4.1 Flash, Peak | 0,30 / 1,20 USD | 0,54 USD |
| DeepSeek V4.1 Flash, Off-Peak | 0,15 / 0,60 USD | 0,27 USD |
Jede Summe ergibt sich aus Eingabepreis plus 0,2 × Ausgabepreis. Beispiel GPT-6.1 Sol: 2 + 0,2 × 10 = 4 USD. Die Claude-Werte stammen aus der Modellübersicht. Für Gemini 3.8 Flash nennt Google 0,75/3,75 USD bis 31. Dezember 2026 und danach 1,50/7,50 USD; das gleiche Beispiel würde dann 3 USD kosten. DeepSeeks API-Name deepseek-flash verweist aktuell auf V4.1-Flash-1017. Peak gilt montags bis freitags von 01–04 und 06–10 Uhr UTC, außer an chinesischen Feiertagen; die übrige Zeit ist Off-Peak. Diese Tabelle vergleicht Tarife bei gleichen Tokenzahlen, nicht gleiche Textmengen, Qualität oder Geschwindigkeit. [3, 11, 13]
Offene Gewichte haben keinen Einheitstarif
Für ein selbst betriebenes Qwen-Modell fällt kein API-Preis pro Token an. Stattdessen kosten Hardware, Strom und Wartungsarbeit Geld. Die veröffentlichten Modellgewichte sind die gespeicherten Zahlenwerte des Modells; passende Software und ausreichend Speicher werden zusätzlich benötigt. Auch DeepSeek stellt Gewichte bereit. Das verlinkte MoE-Modell besteht aus vielen Teilnetzen, von denen pro Verarbeitungsschritt nur ein Teil aktiv ist. Wenige gleichzeitig aktive Parameter bedeuten deshalb nicht, dass nur dieser kleine Teil gespeichert werden muss. Die vollständige Variante kann erheblich mehr Hardware benötigen als ein kleineres lokales Modell. [7, 8]
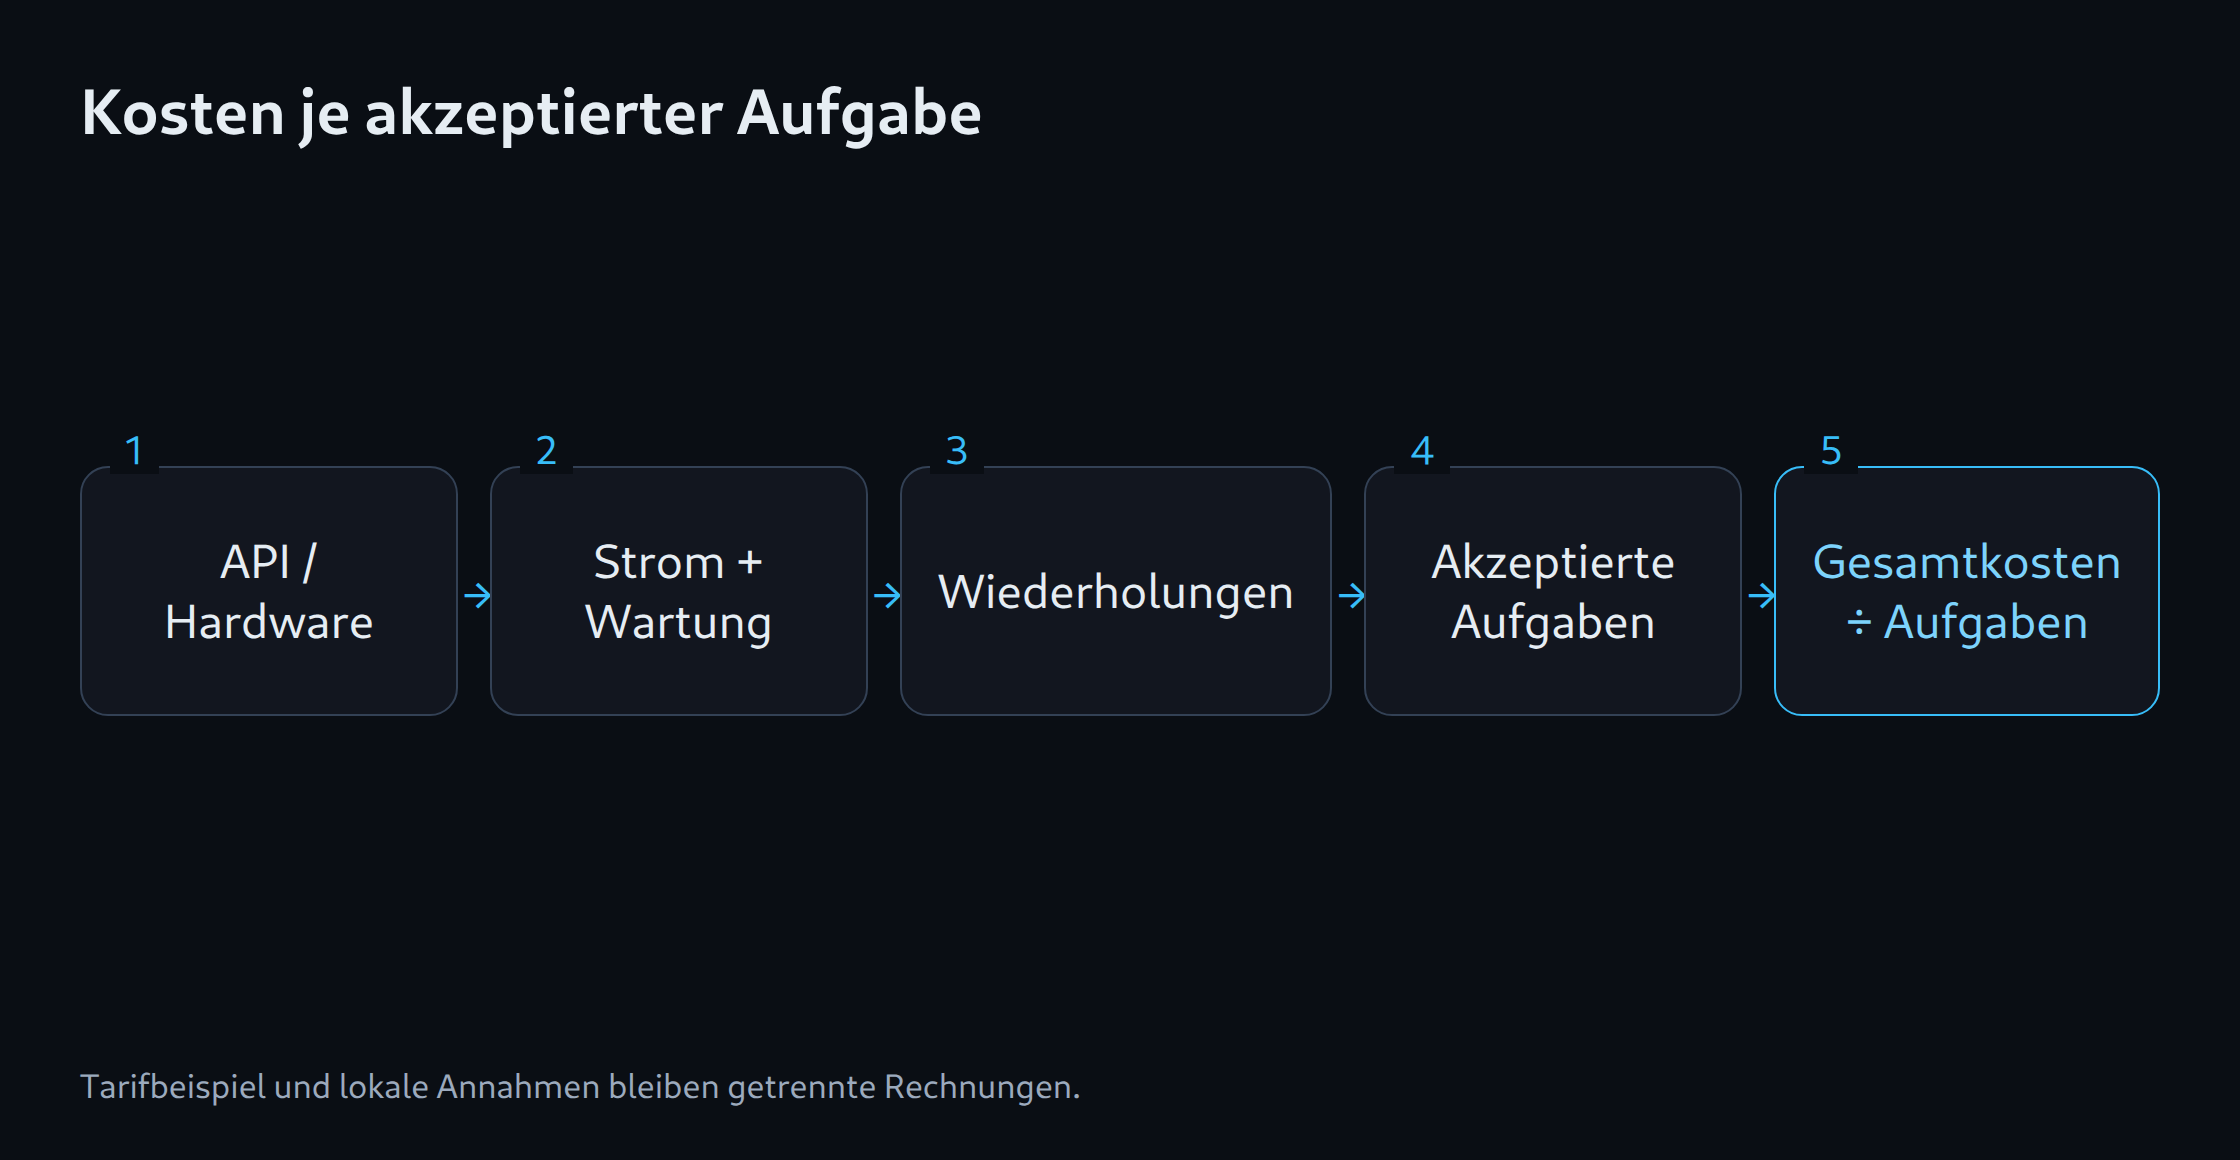
Ein frei gewähltes Monatsbeispiel setzt 50 Euro anteilige Hardwarekosten, 20 Euro Strom und 30 Euro Wartungsarbeit an. Zusammen sind das 100 Euro. Bei 1.000 brauchbaren Ergebnissen kostet jedes im Durchschnitt 0,10 Euro. Bleiben bei denselben Gesamtkosten nur 500 brauchbare Ergebnisse, steigt der Wert auf 0,20 Euro. Die Beträge sind keine Messung für DeepSeek oder Qwen. Ein Vergleich mit der USD-Tabelle braucht dieselben Aufgaben, Qualitätsanforderungen und eine gemeinsame Währung.
Qualität in die Rechnung aufnehmen
Die hilfreiche Kennzahl ist Gesamtkosten geteilt durch die Zahl brauchbarer Ergebnisse. Vor dem Test steht fest, was brauchbar bedeutet, zum Beispiel korrekt übernommene Rechnungsfelder. Alle Versuche und die Zeit für Prüfung und Korrektur gehören in die Kosten. Bei null brauchbaren Ergebnissen ist kein endlicher Preis pro Erfolg berechenbar. Ein teureres Modell kann günstiger enden, wenn weniger Nacharbeit nötig ist. Ein kleineres Modell kann für einfache Aufgaben reichen. Beides muss mit denselben Aufgaben getestet werden.
Ein gemischter Betrieb
Ein gemischter Betrieb kann einfache Aufgaben lokal und festgelegte schwierige Fälle in der Cloud verarbeiten. Das Protokoll hält pro Aufgabe Modell, Version und tatsächlich genutzten Dienst fest. Die bloße Verwendung von Ollama beweist keinen lokalen Betrieb: Ollama unterstützt auch Cloud-Modelle und Websuche. Entscheidend ist, wohin die konkrete Anfrage gesendet wird. [9]
Der verlinkte Kostenrechner verteilt den Hardwarekauf auf Monate und addiert Strom und Wartung. API-Mengen und Preise werden getrennt eingetragen. Das Währungsfeld beschriftet die Rechnung; es rechnet Euro nicht automatisch in USD um. Auch Qualitätsverluste und Korrekturzeit werden nicht selbst ermittelt. Das Testprotokoll hilft beim Festhalten eigener Ergebnisse, führt aber keine Modelltests aus. Erst diese Messungen machen aus den Annahmen einen Vergleich für die tatsächliche Aufgabe. Tarife und Modellversionen können sich ändern.
Passende Werkzeuge
Fragen und Antworten
Sind die Beispielsummen monatliche Abopreise?
Die Summen beschreiben angenommene API-Tokenmengen mit den genannten Tarifbedingungen. Chatabos und lokale Betriebskosten folgen anderen Rechnungen.
Wann ist ein lokales Modell günstiger?
Entscheidend sind Auslastung, Hardwareanteil, Strom, Wartung und akzeptierte Ergebnisse. Ein niedriger Strompreis allein reicht für einen Kostenvergleich nicht aus.
Quellen
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
- Google: Gemini API pricing
Quellen geprüft: 25. Oktober 2026.
Passend dazu