English
 Deutsch
 Polski
Porównanie kosztów modeli AI: API w chmurze czy lokalne DeepSeek i Qwen?

Management Summary
Firmy mogą korzystać z AI jako wynajmowanej usługi lub uruchamiać odpowiednie modele, takie jak DeepSeek i Qwen, na własnych komputerach. Artykuł wyjaśnia koszty obu dróg przy codziennych zadaniach AI. Własny sprzęt wymaga zakupu, energii i utrzymania, a usługa zewnętrzna nalicza opłaty za użycie. Porównanie pomaga ocenić opłacalność. Ważny jest koszt przydatnego wyniku wraz z ponowieniami i poprawkami, nie najtańsze pojedyncze zapytanie.
Spis treści
Niska cena zapytania do modelu nie gwarantuje taniego ukończenia zadania. Błędne odpowiedzi mogą wymagać kolejnych prób i ręcznych poprawek. Porównanie wykorzystuje ceny API sprawdzone 25 października 2026 r. API oznacza tu interfejs programistyczny dostawcy chmurowego. Osobno przedstawione są założone koszty modeli na własnym sprzęcie.
Przejrzyste porównanie taryf
Tokeny to jednostki, na które model dzieli tekst, na przykład słowa lub fragmenty słów. Różne modele mogą inaczej policzyć ten sam tekst. Przykład mimo to zakłada u każdego dostawcy te same ilości: milion tokenów wejściowych bez rabatu za pamięć podręczną i 200 000 rozliczanych tokenów wyjściowych, rozłożonych na wiele krótkich zapytań. Wewnętrzne tokeny rozumowania należą do wyjścia, jeżeli dostawca pobiera za nie opłatę. Tabela podaje USD bez podatków, narzędzi, opłat za zapis pamięci podręcznej, specjalnych rabatów i dopłat regionalnych. Dla OpenAI użyty jest standardowy cennik krótkiego kontekstu. [10]
| Model | Wejście / wyjście na milion | Suma przykładowa |
|---|---|---|
| GPT-6 Astra | 10 / 50 USD | 20 USD |
| GPT-6.1 Sol | 2 / 10 USD | 4 USD |
| Claude Opus 5.5 | 4 / 20 USD | 8 USD |
| Claude Sonnet 5.5 | 2 / 10 USD | 4 USD |
| Gemini 3.8 Flash | 0,75 / 3,75 USD | 1,50 USD |
| DeepSeek V4.1 Flash, peak | 0,30 / 1,20 USD | 0,54 USD |
| DeepSeek V4.1 Flash, off-peak | 0,15 / 0,60 USD | 0,27 USD |
Każda suma to cena wejścia plus 0,2 × cena wyjścia. Dla GPT-6.1 Sol: 2 + 0,2 × 10 = 4 USD. Stawki Claude pochodzą z przeglądu modeli. Google podaje dla Gemini 3.8 Flash 0,75/3,75 USD do 31 grudnia 2026, a później 1,50/7,50 USD; ten sam przykład kosztowałby wtedy 3 USD. Nazwa API DeepSeek deepseek-flash wskazuje obecnie V4.1-Flash-1017. Taryfa peak obowiązuje od poniedziałku do piątku w godzinach 01–04 i 06–10 UTC, z wyjątkiem chińskich świąt; pozostały czas to off-peak. Tabela porównuje ceny przy równych liczbach tokenów, a nie równej ilości tekstu, jakości czy szybkości. [3, 11, 13]
Brak wspólnej taryfy otwartych wag
Samodzielnie uruchomiony Qwen nie wymaga opłaty API za token. Kosztują natomiast sprzęt, energia i praca przy utrzymaniu. Opublikowane wagi to zapisane wartości liczbowe modelu; potrzebne są też zgodne oprogramowanie i odpowiednia pamięć. DeepSeek również publikuje wagi. Podlinkowany model MoE zawiera wiele podsieci, z których tylko część działa w danym kroku. Mała liczba aktywnych parametrów nie oznacza więc, że przechowywana jest wyłącznie ta mała część. Pełna wersja może wymagać znacznie więcej sprzętu niż mniejszy model lokalny. [7, 8]
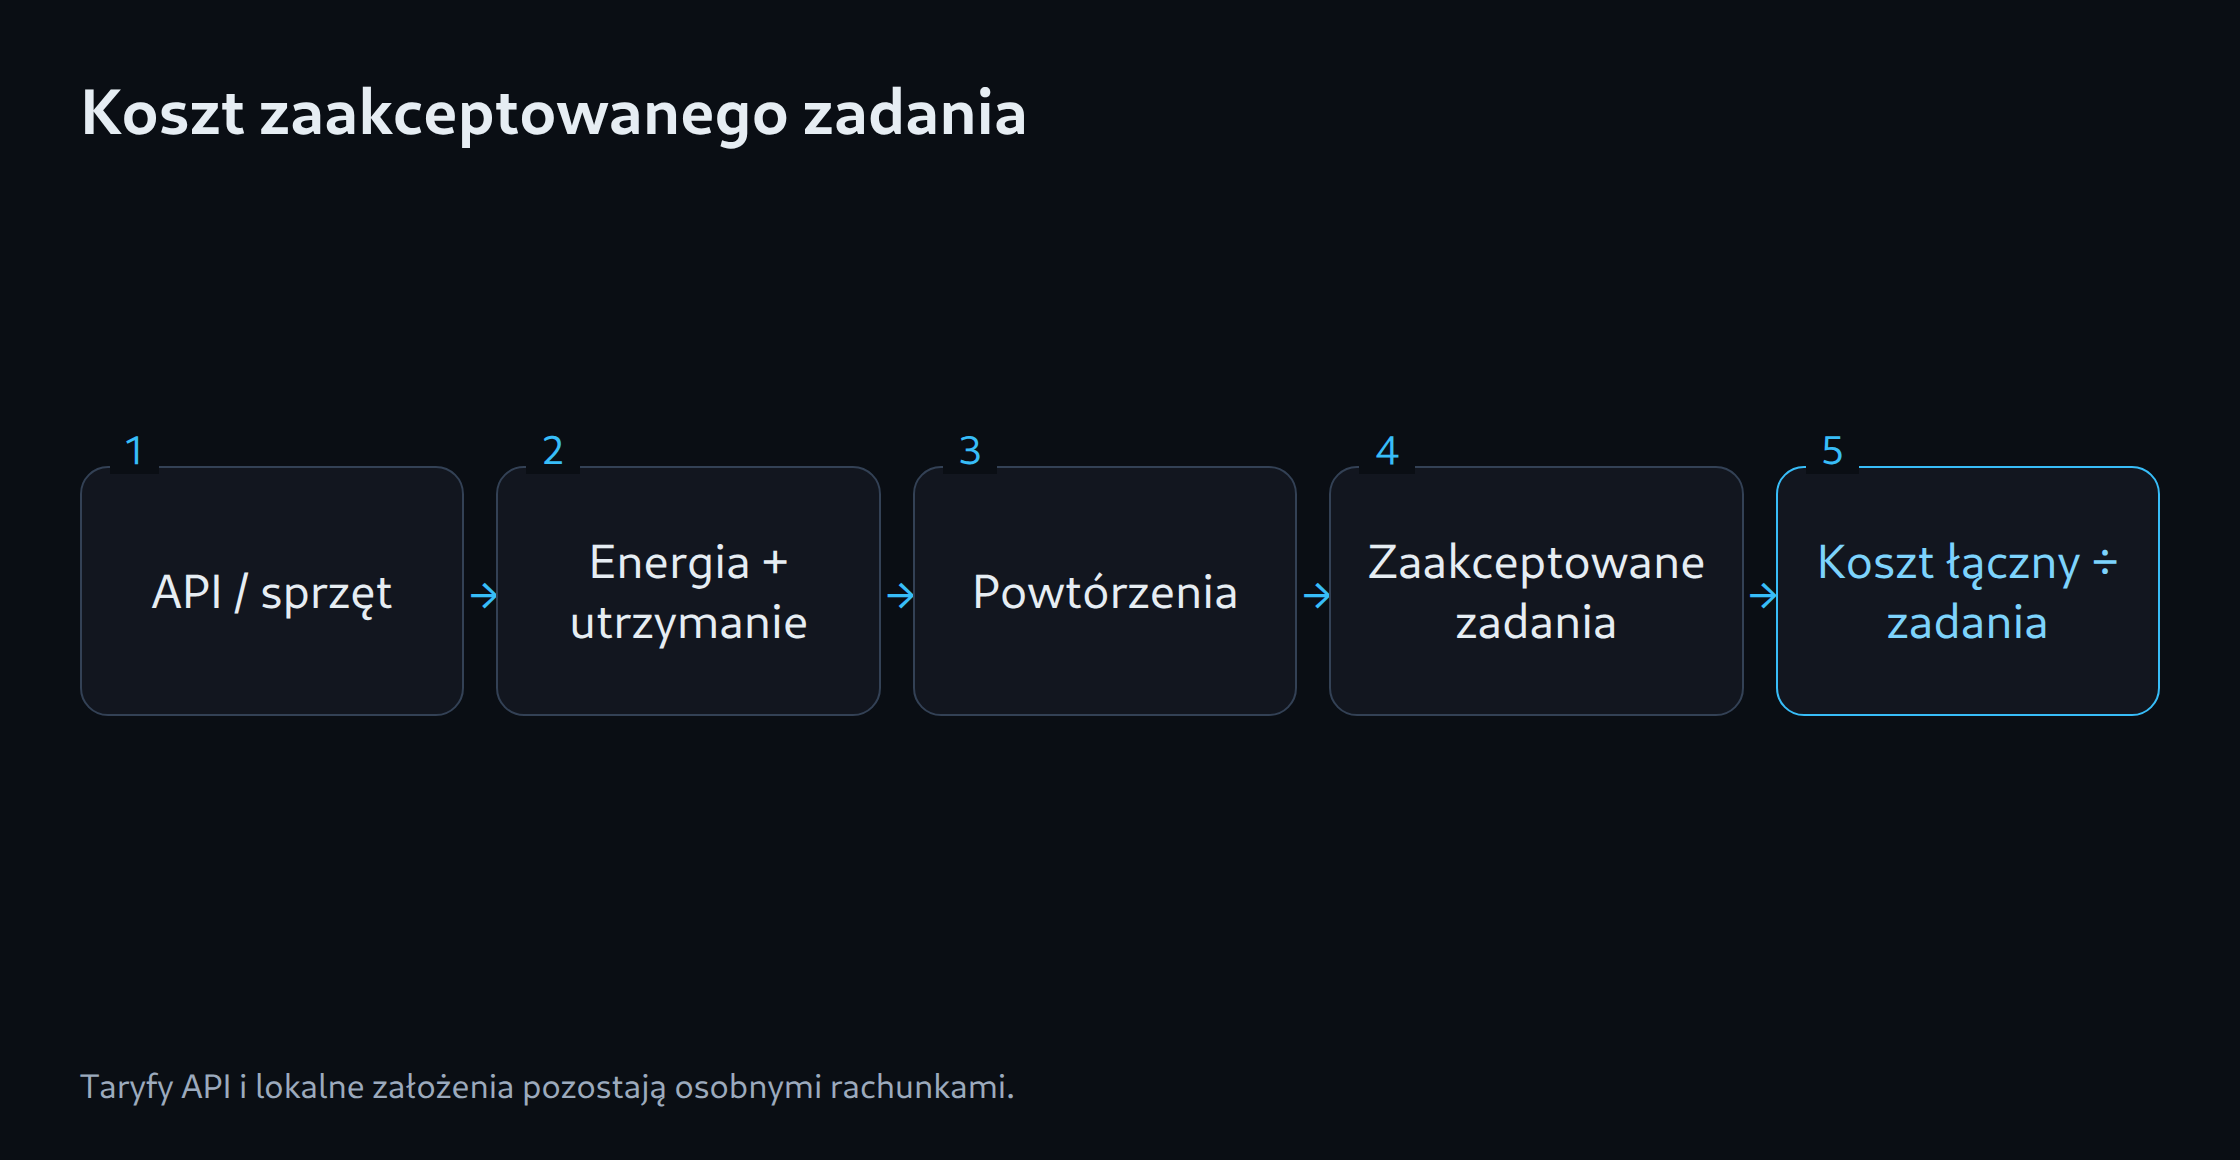
Hipotetyczny przykład miesięczny przypisuje 50 euro do sprzętu, 20 euro do energii i 30 euro do utrzymania, łącznie 100 euro. Przy 1000 użytecznych wynikach średni koszt wynosi 0,10 euro za wynik. Jeżeli ten sam koszt daje tylko 500 użytecznych wyników, wartość rośnie do 0,20 euro. Kwoty nie są pomiarem DeepSeek ani Qwen. Porównanie z tabelą USD wymaga tych samych zadań, wymagań jakościowych i wspólnej waluty.
Jakość w rachunku
Przydatna miara to koszt całkowity podzielony przez liczbę użytecznych wyników. Przed testem ustalone jest znaczenie użyteczności, na przykład poprawne odczytanie pól faktury. Koszt obejmuje wszystkie próby oraz czas sprawdzania i poprawiania. Przy zerze użytecznych wyników nie da się obliczyć skończonego kosztu sukcesu. Droższy model może kosztować mniej łącznie, jeśli wymaga mniej poprawek. Mniejszy model może wystarczyć do prostych zadań. Obie możliwości wymagają testu na tych samych zadaniach.
Eksploatacja mieszana
Układ mieszany może wykonywać proste zadania lokalnie, a określone trudne przypadki w chmurze. Rejestr zapisuje model, wersję i faktyczną usługę dla każdego zadania. Samo użycie Ollama nie dowodzi działania lokalnego: Ollama obsługuje także modele chmurowe i wyszukiwanie w sieci. Liczy się miejsce wysłania konkretnego zapytania. [9]
Podlinkowany kalkulator rozkłada zakup sprzętu na miesiące i dodaje energię oraz utrzymanie. Ilości i ceny API są wpisywane osobno. Pole waluty opisuje obliczenie, ale nie przelicza automatycznie euro na USD. Nie mierzy też spadku jakości ani czasu poprawek. Rejestr testów pomaga zapisywać wyniki, lecz nie uruchamia testów modeli. Dopiero takie pomiary zmieniają założenia w porównanie dla rzeczywistego zadania. Ceny i wersje modeli mogą się zmieniać.
Powiązane narzędzia
Pytania i odpowiedzi
Czy przykładowe sumy są cenami miesięcznych abonamentów?
Sumy opisują założone ilości tokenów API przy podanych warunkach taryfowych. Subskrypcje czatowe i eksploatacja lokalna mają odrębne rachunki.
Kiedy model lokalny jest tańszy?
Decydują wykorzystanie, udział sprzętu, energia, utrzymanie i zaakceptowane wyniki. Sama niska cena energii nie wystarcza.
Źródła
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
- Google: Gemini API pricing
Źródła sprawdzone: 25 października 2026.
Powiązane artykuły