English
 Deutsch
 Polski
Frei zugängliche LLMs im Vergleich: Qwen, Gemma, Ministral, Llama und DeepSeek für DE, EN und PL

Management Summary
Qwen, Gemma, Ministral, Llama und DeepSeek bieten herunterladbare Sprachmodelle: KI-Systeme, die Texte verarbeiten und Antworten erzeugen. Auf eigener Hardware eingesetzt, ermöglichen solche Modelle mehr Kontrolle über den Betrieb. Der Artikel vergleicht ihre Eignung für Deutsch, Englisch und Polnisch. Die passende Wahl hängt von Aufgabe, Gerät und erlaubter Nutzung ab. Kostenloses Herunterladen bedeutet weder uneingeschränkte Nutzungsrechte noch automatisch gute Ergebnisse in jeder Sprache.
Inhalt
Ein herunterladbares Sprachmodell ist nicht automatisch für jede lokale Aufgabe geeignet. Eine Zusammenfassung auf Deutsch kann gelingen, während dieselbe Aufgabe auf Polnisch wichtige Angaben verliert. Auch ein gutes Modell hilft wenig, wenn die Modelldatei nicht in den verfügbaren Speicher passt. Der Vergleich betrachtet deshalb Aufgabe, Sprache, Speicher, Software und Nutzungsbedingungen.
Die Auswahl nennt konkrete Beispiele aus fünf Modellfamilien. Das sind Kandidaten für einen eigenen Test, keine Rangliste nach selbst gemessener Qualität. Die Modelle unterscheiden sich stark in der Größe und stammen aus unterschiedlichen Generationen.
Welche Kandidaten in welche Klasse gehören
| Kandidat | Vergleichsaufgabe | Konkrete Prüfung |
|---|---|---|
| Qwen3.5-9B | Kompakter Text- und Bildassistent | Unterstützt das Rechenprogramm genau diese Architektur? |
| Gemma 4 31B | Größere Text- und Bildaufgaben | Genaues Modell und Speicherbedarf statt nur Familienname |
| Ministral 3 14B Instruct 2512 | Chat und strukturierte Textausgabe | Verlinkte Datei ist FP8; andere Dateiformate separat prüfen |
| Llama 3.3 70B Instruct | Größere Textreferenz für DE/EN | Polnisch fehlt in der Liste unterstützter Sprachen |
| DeepSeek-R1-Distill | Denkaufgaben in verschiedenen Größen | Qwen- oder Llama-Basis, genaue Größe und Ausgabelimit |
Frei zugänglich ist eine unvollständige Beschreibung
Modellgewichte sind gespeicherte Zahlenwerte, die das Verhalten des Modells bestimmen. Ein Download stellt diese Dateien bereit, sagt aber noch nichts über sämtliche erlaubten Nutzungen. Die Modellbeschreibung, auch Model Card genannt, und die zugehörigen Lizenzdateien gehören zur Prüfung. Bei abgeleiteten Modellen sind zusätzlich die Bedingungen des Ausgangsmodells zu beachten.
Qwen3.5-9B, Gemma 4 31B und der verlinkte Ministral-3-14B-Instruct-Eintrag nennen Apache 2.0. Llama 3.3 hat dagegen eine eigene Community-Lizenz. DeepSeek nennt für R1 MIT und weist bei den kleineren Distill-Modellen ausdrücklich auf Qwen- oder Llama-Ausgangsmodelle hin. Distillation bedeutet hier: Ein kleineres Modell wird mit Ausgaben des größeren Modells weitertrainiert. Eine Lizenzzuordnung gilt deshalb immer für die konkrete Datei und Version, nicht pauschal für einen Markennamen.
DE, EN und PL brauchen eigene Ergebnisse
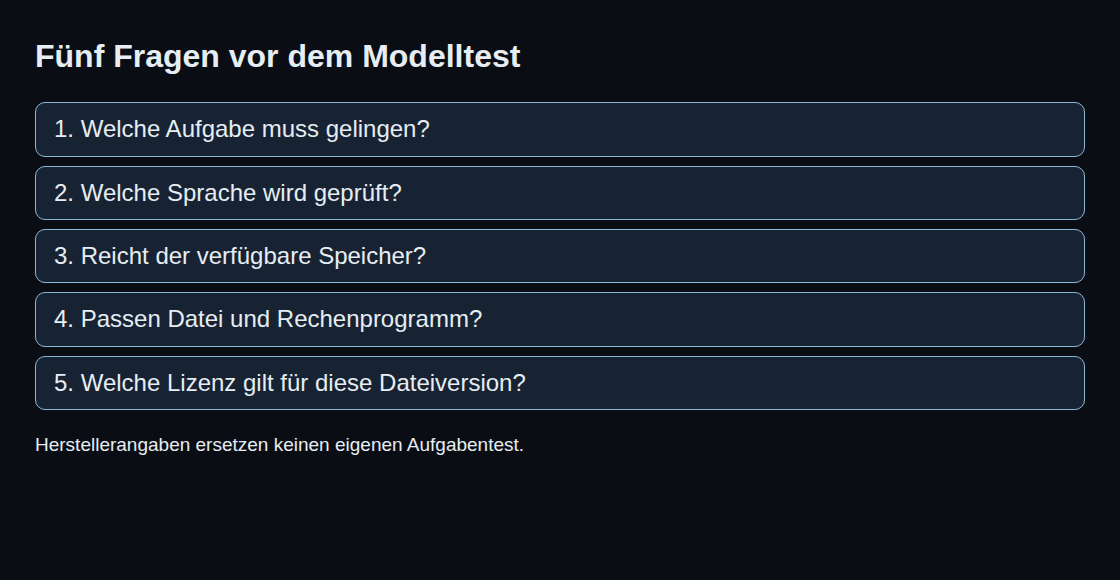
Ein kleines Testpaket kann fünf Aufgaben enthalten: einen Absatz zusammenfassen, einen fehlerhaften Satz korrigieren, Rechnungsfelder als JSON ausgeben, einen Programmfehler erklären und eine Frage anhand eines bereitgestellten Dokuments beantworten. JSON ist ein Textformat für strukturierte Daten. Erwartete Angaben und erlaubte Abweichungen stehen vor dem Test fest. Jede Sprache erhält natürlich formulierte Aufgaben mit demselben Inhalt.
Für Deutsch, Englisch und Polnisch entstehen getrennte Ergebnisse. Gezählt werden falsche Fakten, fehlende Angaben, falsche Formate und erfundene Ergänzungen. Im Polnischen gehören etwa die richtige Beugung eines Namens und ein natürlicher sachlicher Satzbau dazu. Llama 3.3 nennt Deutsch und Englisch unter acht unterstützten Sprachen, Polnisch jedoch nicht. Die Modellkarte ordnet andere Sprachen außerhalb des vorgesehenen Einsatzbereichs ein. Zusätzliche Sprachen können durch weiteres Training (Fine-Tuning) unter Beachtung der Lizenz und mit passenden Schutzmaßnahmen erschlossen werden. Ein eigener Test ersetzt diese Nutzungshinweise nicht.
Modellgröße und Speicherbudget getrennt vergleichen
Eine Vergleichsrunde hält die Modellgröße ungefähr gleich. Eine zweite hält den verfügbaren Speicher fest. Quantisierung speichert die Modellzahlen mit weniger Genauigkeit und spart dadurch Speicher; das kann Antworten verändern. So lässt sich beispielsweise ein kleineres Modell mit weniger Komprimierung gegen ein größeres mit stärkerer Komprimierung prüfen. Zusätzlich zu den Gewichten brauchen laufende Berechnungen und längere Eingaben Speicher.
Bei Mixture of Experts (MoE) arbeiten pro Schritt nur ausgewählte Teilnetze. Die nicht gleichzeitig aktiven Gewichte verschwinden dadurch nicht aus dem Speicherbedarf. Llama 4 Scout enthält rund 109 Milliarden Parameter, obwohl pro Schritt etwa 17 Milliarden aktiv sind. Ein solches Modell ist daher nicht mit einem gewöhnlichen Modell mit insgesamt 17 Milliarden Parametern gleichzusetzen. Auslagerung in den Arbeitsspeicher kann Platz auf der Grafikkarte sparen und zugleich Antworten verlangsamen.
Den Test wiederholen und Ergebnisse vergleichen
Ein wiederholbarer Test hält die genaue Modellkennung, Dateiversion und Quantisierung fest. Dazu kommen das Rechenprogramm (Runtime), die verfügbare Kontextlänge und die Chat-Vorlage, die Rollen und Nachrichten für das Modell aufbereitet. Sampling bezeichnet Einstellungen für die Zufallsauswahl bei der Textausgabe. Für Modelle mit längeren Denkphasen werden auch Ausgabelimit, gesamte Laufzeit und brauchbares Ergebnis erfasst. Sonst erscheint eine kurze, falsche Antwort möglicherweise günstiger als eine längere, richtige. Aufgaben mit Bildern werden gesondert geprüft.
Der verlinkte Speicherrechner unterstützt die erste Abschätzung. Danach entscheidet ein kleiner praktischer Test mit überprüfbaren Antworten. Das Ergebnis ist eine Auswahl für eine bestimmte Aufgabe und Sprache, keine allgemeine Siegerliste. Ohne eigene Messungen lässt sich hier kein bestes Modell für Polnisch oder für einen bestimmten Rechner benennen.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Bedeutet frei zugänglich automatisch uneingeschränkte Nutzung?
Downloadzugang und Nutzungsbedingungen sind getrennte Eigenschaften. Maßgeblich sind Lizenz und Bedingungen des konkreten Modells beziehungsweise der konkreten Ableitung.
Ist das Modell mit den meisten Parametern automatisch das beste für Polnisch?
Nein. Für Polnisch zählen Ergebnisse mit polnischen Aufgaben, nicht nur die Zahl der Modellparameter. Auch Dateikomprimierung, Chat-Vorlage und Ausgabelimit werden mitgeprüft. Die dokumentierten Sprachgrenzen des jeweiligen Modells bleiben zu beachten.
Quellen
- Qwen: Qwen3.5-9B, offizielle Model Card
- Google DeepMind: Gemma 4
- Google: Gemma 4 31B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- Meta: Llama 3.3 70B Instruct, offizielle Model Card
- Meta: Llama 4 Scout, offizielle Model Card
- DeepSeek: R1 und Distill-Modelle
Quellen geprüft: 26. Oktober 2026. Keine eigenen Modellbenchmarks.
Passend dazu