English
 Deutsch
 Polski
Porównanie dostępnych modeli LLM: Qwen, Gemma, Ministral, Llama i DeepSeek w DE, EN i PL

Management Summary
Qwen, Gemma, Ministral, Llama i DeepSeek oferują modele językowe do pobrania: systemy AI przetwarzające tekst i tworzące odpowiedzi. Uruchomienie na własnym sprzęcie daje większą kontrolę nad działaniem. Artykuł porównuje przydatność do niemieckiego, angielskiego i polskiego. Wybór zależy od zadania, urządzenia i dozwolonego użycia. Bezpłatne pobranie nie oznacza nieograniczonych praw ani automatycznie dobrych wyników w każdym języku. Liczy się dopasowanie do rzeczywistej pracy.
Spis treści
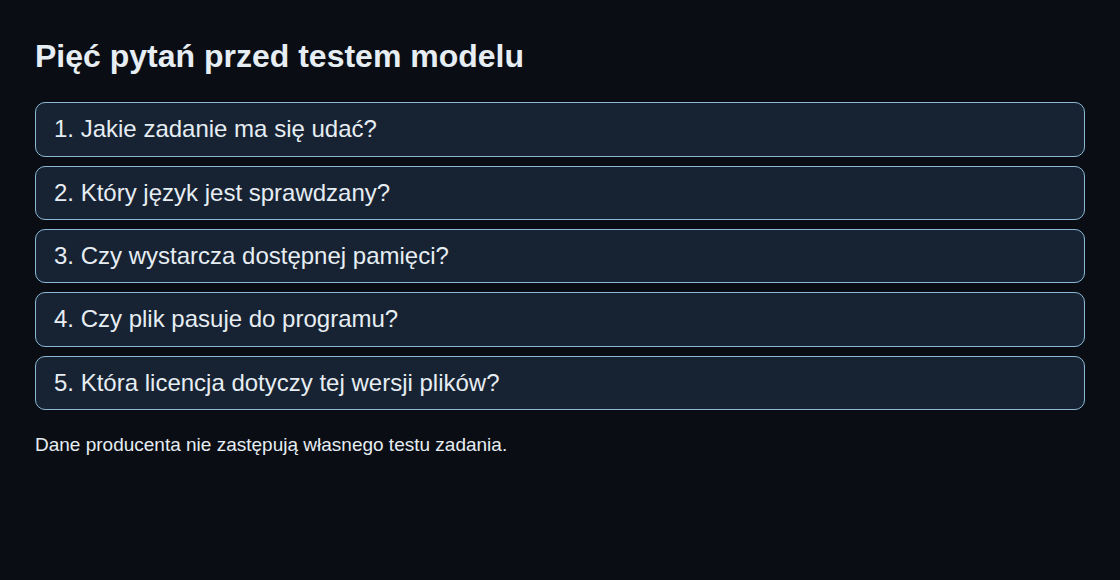
Model językowy dostępny do pobrania nie nadaje się automatycznie do każdego zadania lokalnego. Może poprawnie streścić niemiecki akapit, a w równoważnym zadaniu po polsku pominąć ważne informacje. Dobry model niewiele też pomoże, gdy pliki nie mieszczą się w dostępnej pamięci. Porównanie obejmuje więc zadanie, język, pamięć, program i warunki użycia.
Zestaw zawiera konkretne przykłady z pięciu rodzin modeli. To kandydaci do praktycznego testu, a nie ranking oparty na własnych pomiarach jakości. Modele znacznie różnią się wielkością i pochodzą z różnych generacji.
Klasy kandydatów
| Kandydat | Zadanie porównawcze | Konkretna kontrola |
|---|---|---|
| Qwen3.5-9B | Mały asystent tekstowy i obrazowy | Czy program obsługuje dokładnie tę architekturę? |
| Gemma 4 31B | Większe zadania tekstowe i obrazowe | Konkretny model i pamięć, nie tylko nazwa rodziny |
| Ministral 3 14B Instruct 2512 | Czat i uporządkowany wynik tekstowy | Podlinkowane pliki używają FP8; inne formaty wymagają kontroli |
| Llama 3.3 70B Instruct | Większy model tekstowy dla DE/EN | Brak polskiego na liście obsługiwanych języków |
| DeepSeek-R1-Distill | Zadania rozumowania w różnych rozmiarach | Baza Qwen lub Llama, rozmiar i limit odpowiedzi |
Dostępność nie opisuje wszystkiego
Wagi modelu to zapisane wartości liczbowe określające jego działanie. Pobranie udostępnia pliki, ale nie rozstrzyga wszystkich dozwolonych zastosowań. Sprawdzenia wymagają opis modelu, czyli karta modelu, oraz dołączone pliki licencji. Przy modelach pochodnych znaczenie mają również warunki modelu bazowego.
Qwen3.5-9B, Gemma 4 31B i podlinkowany Ministral 3 14B Instruct wskazują Apache 2.0. Llama 3.3 ma natomiast własną licencję społecznościową. DeepSeek wskazuje MIT dla R1 i wyraźnie opisuje bazowe modele Qwen lub Llama w mniejszych wariantach Distill. Destylacja oznacza tu dalszy trening mniejszego modelu na odpowiedziach większego. Ocena licencji dotyczy zatem konkretnych plików i wersji, a nie całej marki.
DE, EN i PL wymagają osobnych wyników
Mały zestaw testowy może zawierać pięć zadań: streszczenie akapitu, poprawienie błędnego zdania, zapis pól faktury w JSON, wyjaśnienie błędu programu i odpowiedź na pytanie na podstawie dokumentu. JSON to tekstowy format danych uporządkowanych. Oczekiwane informacje i dopuszczalne różnice są ustalone przed testem. Każdy język otrzymuje naturalnie sformułowane zadania o równoważnej treści.
Niemiecki, angielski i polski otrzymują osobne wyniki. Ocena zlicza błędne fakty, pominięcia, nieprawidłowy format i wymyślone dodatki. W polszczyźnie sprawdzenie obejmuje na przykład poprawną odmianę nazw i naturalną, neutralną budowę zdania. Llama 3.3 wymienia niemiecki i angielski wśród ośmiu obsługiwanych języków, ale nie polski. Karta modelu umieszcza pozostałe języki poza przewidzianym zakresem użycia. Dodatkowe języki mogą zostać objęte dalszym treningiem (fine-tuning), z zachowaniem licencji i odpowiednich zabezpieczeń. Własny test nie zastępuje tych warunków użycia.
Osobne porównanie klasy i budżetu pamięci
Jedna runda porównania zachowuje zbliżoną wielkość modeli. Druga utrzymuje stałą ilość dostępnej pamięci. Kwantyzacja zapisuje liczby modelu z mniejszą dokładnością, oszczędzając pamięć; może to zmienić odpowiedzi. Pozwala to porównać mniejszy model z mniejszą kompresją z większym modelem o silniejszej kompresji. Obliczenia i dłuższe wejście wymagają dodatkowej pamięci poza wagami.
W architekturze mixture of experts (MoE) w każdym kroku działają tylko wybrane podsieci. Pozostałe wagi nadal zajmują miejsce. Llama 4 Scout zawiera około 109 miliardów parametrów, choć w jednym kroku aktywnych jest około 17 miliardów. Nie jest więc odpowiednikiem zwykłego modelu o łącznie 17 miliardach parametrów. Przeniesienie danych do pamięci operacyjnej może oszczędzić pamięć karty graficznej, ale spowolnić odpowiedzi.
Powtórzenie testu i porównanie wyników
Powtarzalny test zapisuje dokładny identyfikator modelu, wersję plików i kwantyzację. Obejmuje też silnik obliczeniowy, dostępną długość kontekstu i szablon czatu układający role oraz wiadomości. Ustawienia próbkowania określają losowość generowania tekstu. Dla modeli z dłuższym rozumowaniem zapis obejmuje również limit odpowiedzi, cały czas wykonania i użyteczny wynik. Inaczej krótka błędna odpowiedź może wyglądać taniej niż dłuższa poprawna. Zadania z obrazami wymagają osobnej oceny.
Podlinkowany kalkulator pamięci pomaga we wstępnym oszacowaniu. Potem potrzebny jest niewielki test praktyczny ze sprawdzalnymi odpowiedziami. Wynik to wybór dla konkretnego zadania i języka, a nie uniwersalny zwycięzca. Bez własnych pomiarów artykuł nie wskazuje najlepszego modelu dla polszczyzny ani określonego komputera.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy swobodny dostęp automatycznie oznacza brak ograniczeń użycia?
Dostęp do pobrania i warunki użycia to odrębne kwestie. Zakres dozwolonego użycia określają licencja i warunki konkretnego modelu lub wersji pochodnej.
Czy model z największą liczbą parametrów jest automatycznie najlepszy dla polskiego?
Nie. Liczą się wyniki zadań po polsku, a nie tylko liczba parametrów. Sprawdzenie obejmuje też kompresję plików, szablon czatu i limit odpowiedzi. Nadal obowiązują udokumentowane ograniczenia językowe modelu.
Źródła
- Qwen: Qwen3.5-9B, oficjalna karta modelu
- Google DeepMind: Gemma 4
- Google: Gemma 4 31B, oficjalna karta modelu
- Mistral: Ministral 3 14B Instruct, oficjalna karta modelu
- Meta: Llama 3.3 70B Instruct, oficjalna karta modelu
- Meta: Llama 4 Scout, oficjalna karta modelu
- DeepSeek: R1 i modele Distill
Źródła sprawdzone: 26 października 2026. Bez własnych benchmarków modeli.
Powiązane artykuły