English
 Deutsch
 Polski
Laptop, Mini-PC, GPU-Tower oder AI-Workstation: Welche Geräte passen zu lokalen LLMs?

Management Summary
Der Artikel vergleicht Rechner für Sprachmodelle, also KI-Systeme zum Bearbeiten von Texten und Beantworten von Fragen. Statt bei einem externen Dienst entstehen die Antworten auf eigener Hardware. Laptop, Mini-PC und größere Arbeitsrechner bieten unterschiedliche Möglichkeiten bei Mobilität, Speicher und Erweiterung. Die Auswahl soll unnötige Ausgaben vermeiden: Viel Speicher allein garantiert weder schnelle noch gute Antworten. Ausschlaggebend sind die vorgesehenen Aufgaben sowie Strombedarf und Lautstärke.
Inhalt
Ein lokales LLM ist ein Sprachmodell, das auf dem eigenen Rechner antwortet. Das passende Gerät hängt von der Aufgabe ab: eine gelegentliche Zusammenfassung, wiederholte Programmierhilfe oder mehrere gleichzeitige Anfragen stellen unterschiedliche Anforderungen. Viel Speicher kann ein größeres Modell ermöglichen, garantiert aber keine schnelle oder richtige Antwort.
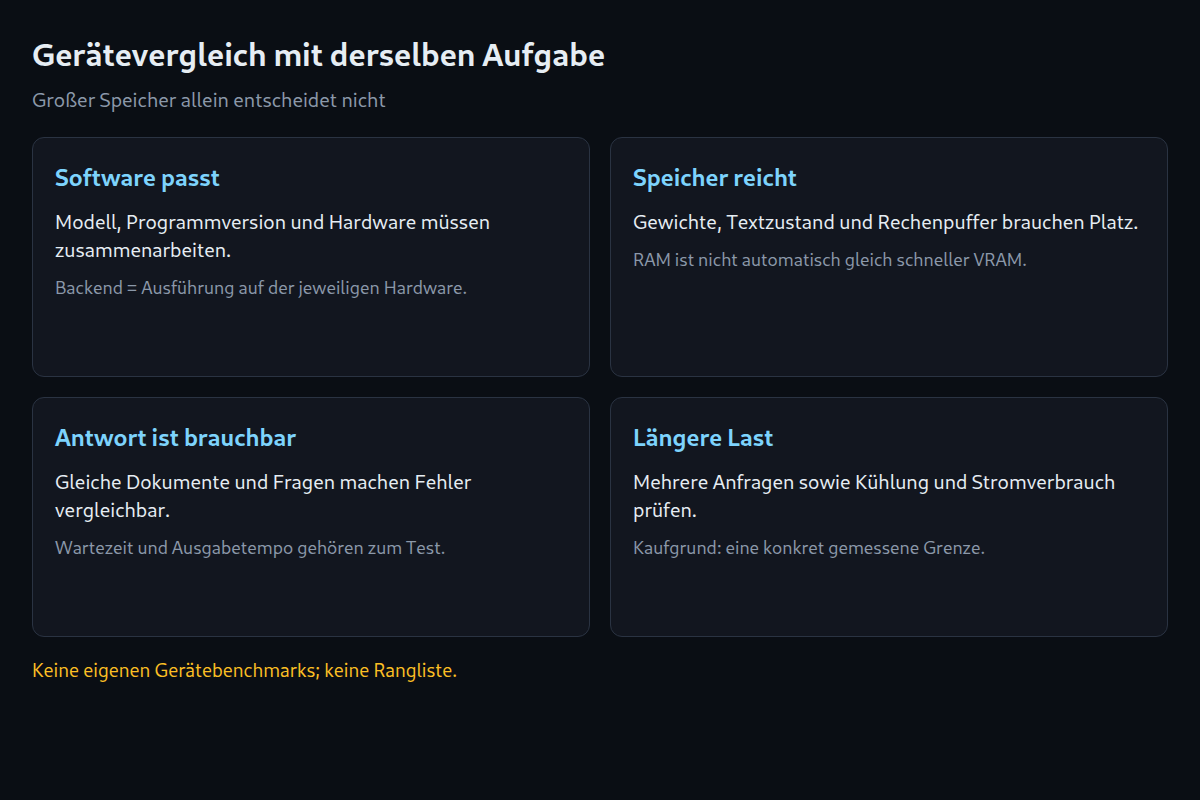
Dieser Vergleich ordnet Herstellerangaben und unterstützte Software ein. Eigene Gerätemessungen liegen nicht vor. Wartezeit, Stromverbrauch und Lüftergeräusch bleiben deshalb für die konkrete Kombination aus Gerät, Modell und Programm zu prüfen.
Geräteklassen nach Einsatz
| Klasse | Passendes Szenario | Typische Grenze |
|---|---|---|
| CPU-Laptop / Mini-PC | Einstieg und kleine Modelle | Antworttempo und RAM |
| Apple Mac mini / Studio | Kompakter Rechner mit gemeinsamem Speicher | Konfiguration und spätere Aufrüstung |
| AMD Ryzen AI Max+ System | Speicherstarker kompakter Rechner | Passende Software für die konkrete Grafikeinheit |
| GPU-Tower | Flexible Entwicklung und Erweiterung | VRAM, Netzteil und Platz |
| NVIDIA DGX Spark | Kompakte CUDA-Workstation | Passende Arm-Programme und gemessenes Antworttempo |
RAM, VRAM und Unified Memory
RAM ist der normale Arbeitsspeicher. VRAM bezeichnet hier den eigenen Speicher einer separaten Grafikkarte. Eine unterstützte Ausführungssoftware kann Teile eines Modells in RAM und andere in VRAM halten. Zusätzliche 32 GB RAM machen aus einer Karte mit 16 GB VRAM jedoch keine Karte mit 48 GB gleich schnellem Grafikspeicher. CPU-Berechnung und Datenübertragung können die Antwort verzögern.
Bei Unified Memory teilen Hauptprozessor und Grafikeinheit denselben Speicher. Betriebssystem und andere Programme benötigen davon ebenfalls einen Teil. Die Speicherbandbreite beschreibt, wie viele Daten pro Sekunde übertragen werden können; die Kapazität beschreibt nur die Menge, die Platz findet. Zwei Geräte mit 128 GB können deshalb unterschiedlich schnell antworten. Das Backend ist der Teil der Software, der die Berechnung auf der jeweiligen Hardware ausführt, beispielsweise über Metal, CUDA oder Vulkan.
Kompakte Geräte: Konfiguration zählt
Apple führt den Mac Studio mit M5 Max oder M5 Ultra und den Mac mini mit M6 oder M5 Pro. Die Speicherausstattung hängt von der gewählten Version ab. Ein Modell kann in eine große Ausstattung passen und trotzdem langsam antworten. Für die Auswahl zählen deshalb die exakte Gerätekonfiguration und ein Test derselben Aufgabe, nicht nur die Bezeichnung Mac Studio.
AMD nennt für Ryzen-AI-Max+-395-Geräte bis zu 128 GB gemeinsamen Speicher, davon je nach Konfiguration bis zu 96 GB für Grafik. Das sind keine zusätzlichen 96 GB. Gerät, Firmware und verwendete Software bestimmen die nutzbare Aufteilung. NVIDIA nennt für DGX Spark 128 GB gemeinsamen Speicher und einen Arm-Prozessor. Programme und Container müssen dessen Prozessorarchitektur und GPU unterstützen; ein Paket für einen üblichen x86-PC funktioniert nicht automatisch. Ollama dokumentiert unterschiedliche Hardwarepfade für NVIDIA, AMD und Apple. Die Freigabe muss zum Betriebssystem und zur Version passen.
Tower: Erweiterung innerhalb der Gerätebegrenzungen
Ein Tower kann sich leichter erweitern lassen: Eine passende Grafikkarte, zusätzlicher RAM oder ein anderes Netzteil können austauschbar sein. Vorher müssen Steckplätze, Anschlüsse, Gehäuseabmessungen und Kühlung passen; Fertig-PCs können eigene Einschränkungen haben. Zum Kaufpreis kommen Stromverbrauch und gegebenenfalls Kosten für Netzteil oder Kühlung. Lüftergeräusch und langfristig gehaltenes Antworttempo zeigen sich erst unter längerer Last.
Zwei Grafikkarten mit je 16 GB erscheinen einem Modell nicht automatisch als eine Karte mit 32 GB. Die Software muss Gewichte oder Berechnungen verteilen können. Dabei brauchen auch Zwischenwerte Platz, und Übertragungen zwischen den Karten können Zeit kosten. Eine einzelne ausreichend große Karte kann einfacher sein. Ob zwei Karten schneller sind oder größere Modelle ermöglichen, hängt von der konkreten Aufteilung ab.
Ein Szenario entscheidet besser als ein Markenname
Für einen ersten Versuch kann ein kleines Modell auf einem vorhandenen Gerät genügen. Ein aussagekräftiger Vergleich verwendet dieselbe Modellversion, dasselbe Zahlenformat und dieselben Texte. Erfasst werden Wartezeit bis zum ersten Textstück, Ausgabetempo, Speicherbedarf und fehlerhafte Antworten. Ein zweiter Durchlauf mit langem Dokument und gleichzeitigen Anfragen zeigt mögliche Engpässe. Bei Programmierhilfe gehören passende Tests des erzeugten Codes zur Qualitätsprüfung.
Ein Raspberry Pi kann kleine Lernversuche ausführen oder Anfragen an einen anderen Rechner weiterleiten. Im zweiten Fall läuft das Modell auf dem anderen Rechner, nicht lokal auf dem Pi. Modellgröße, Pi-Version, Speicher und Kühlung begrenzen den Betrieb. Der Speicherrechner hilft bei der Vorauswahl, ersetzt aber keinen Versuch. Eine konkrete Kaufbegründung lautet beispielsweise: Das benötigte Modell startet nicht, die vereinbarte Wartezeit wird überschritten oder mehrere Anfragen stauen sich.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Ist ein Raspberry Pi für lokale LLMs geeignet?
Ein kleines Modell kann für Lernversuche auf einem passenden Pi ausreichen. Ein Test muss Speicherbedarf und Wartezeit bestätigen. Beim Weiterleiten an einen anderen Rechner läuft das Modell dagegen nicht auf dem Pi.
Ist ein AI-Mini-PC mit viel RAM automatisch besser als eine Grafikkarte?
Nein. Viel Speicher kann ein größeres Modell ermöglichen. Ob Antworten schnell und korrekt sind, hängt auch von Software, Datenübertragung und Aufgabe ab. Ein Vergleich braucht dieselben Texte und Einstellungen.
Quellen
- Apple: Mac Studio M5 Max / M5 Ultra – technische Daten
- Apple: Mac mini M6 und Mac Studio M5 verfügbar
- NVIDIA: DGX Spark Hardware Overview
- Ollama: Hardware support
- llama.cpp: Projekt und Backends
- AMD: Ryzen AI Max+ 395 und Unified Memory
Quellen erneut geprüft: 25. Oktober 2026. Keine eigenen Gerätemessungen und keine Rangliste der Antwortgeschwindigkeit.
Passend dazu