English
 Deutsch
 Polski
Laptop, mini PC, komputer z GPU czy stacja AI: jaki sprzęt pasuje do lokalnych modeli LLM?

Management Summary
Artykuł porównuje komputery do modeli językowych, czyli systemów AI pracujących z tekstem i odpowiadających na pytania. Odpowiedzi powstają na własnym sprzęcie zamiast w zewnętrznej usłudze. Laptop, mini PC i większa stacja robocza różnią się mobilnością, pamięcią oraz rozbudową. Wybór według rzeczywistych zadań pomaga uniknąć zbędnych wydatków: sama duża pamięć nie gwarantuje szybkości ani dobrych odpowiedzi. Znaczenie mają także zużycie prądu i hałas.
Spis treści
Lokalny LLM to model językowy odpowiadający na własnym komputerze. Wybór urządzenia zależy od zadania: okazjonalne streszczenia, częsta pomoc w programowaniu i równoczesne zapytania mają różne wymagania. Więcej pamięci może umożliwić większy model, lecz nie gwarantuje szybkiej ani poprawnej odpowiedzi.
Porównanie wyjaśnia dane producentów i obsługiwane oprogramowanie. Nie ma własnych pomiarów urządzeń. Czas oczekiwania, zużycie energii i hałas wentylatorów nadal wymagają testu konkretnego urządzenia, modelu i programu.
Klasy sprzętu według zadania
| Klasa | Odpowiednie zastosowanie | Częsta granica |
|---|---|---|
| Laptop CPU / mini PC | Początek i małe modele | Tempo odpowiedzi i RAM |
| Apple Mac mini / Studio | Mały komputer ze wspólną pamięcią | Konfiguracja i późniejsza rozbudowa |
| System AMD Ryzen AI Max+ | Kompaktowy sprzęt z dużą pamięcią | Zgodny program dla konkretnego układu graficznego |
| Komputer z GPU | Elastyczny rozwój i rozbudowa | VRAM, zasilacz i miejsce |
| NVIDIA DGX Spark | Mała stacja CUDA | Zgodne programy Arm i zmierzone tempo odpowiedzi |
RAM, VRAM i pamięć zunifikowana
RAM to zwykła pamięć operacyjna. VRAM oznacza tutaj osobną pamięć dedykowanej karty graficznej. Zgodny program może umieścić część modelu w RAM, a część w VRAM. Dodanie 32 GB RAM nie zamienia karty z 16 GB VRAM w kartę z 48 GB równie szybkiej pamięci graficznej. Obliczenia procesora i przesyłanie danych mogą opóźniać odpowiedź.
Pamięć zunifikowaną współdzielą procesor i układ graficzny. System operacyjny i inne programy również zajmują jej część. Przepustowość opisuje ilość danych przesyłanych na sekundę, a pojemność jedynie ilość mieszczących się danych. Dwa urządzenia z 128 GB mogą więc odpowiadać z różną szybkością. Backend to część programu wykonująca obliczenia na danym sprzęcie, na przykład przez Metal, CUDA lub Vulkan.
Małe urządzenia: liczy się konfiguracja
Apple oferuje Maca Studio z M5 Max lub M5 Ultra oraz Maca mini z M6 lub M5 Pro. Pojemność pamięci zależy od wybranej wersji. Model może zmieścić się w dużej konfiguracji, a mimo to odpowiadać powoli. Wybór wymaga więc dokładnej konfiguracji i testu tego samego zadania, nie tylko nazwy Mac Studio.
AMD podaje do 128 GB wspólnej pamięci dla urządzeń Ryzen AI Max+ 395, z przydziałem do 96 GB dla grafiki zależnie od konfiguracji. Nie jest to dodatkowe 96 GB. Urządzenie, firmware i program określają dostępny podział. NVIDIA podaje 128 GB wspólnej pamięci i procesor Arm dla DGX Spark. Programy i kontenery muszą obsługiwać tę architekturę procesora oraz GPU; pakiet dla typowego komputera x86 nie działa automatycznie. Ollama opisuje różne sposoby obsługi NVIDIA, AMD i Apple. Zgodność musi obejmować system operacyjny i wersję.
Rozbudowa zależy od konkretnego komputera
Komputer typu tower może być łatwiejszy do rozbudowy: zgodna karta graficzna, dodatkowy RAM lub inny zasilacz mogą być wymienne. Najpierw muszą pasować gniazda, złącza, wymiary obudowy i chłodzenie; gotowe komputery mogą mieć własne ograniczenia. Do ceny zakupu dochodzą energia oraz ewentualny zasilacz lub chłodzenie. Hałas i utrzymywane tempo odpowiedzi wymagają testu pod dłuższym obciążeniem.
Dwie karty po 16 GB nie stają się automatycznie dla modelu jedną kartą z 32 GB. Program musi obsługiwać podział wag lub obliczeń. Wyniki pośrednie też zajmują miejsce, a przesyłanie między kartami może zabierać czas. Jedna wystarczająco duża karta bywa prostsza. To, czy dwie karty przyspieszą pracę albo pomieszczą większy model, zależy od konkretnego podziału.
Zadanie rozstrzyga więcej niż marka
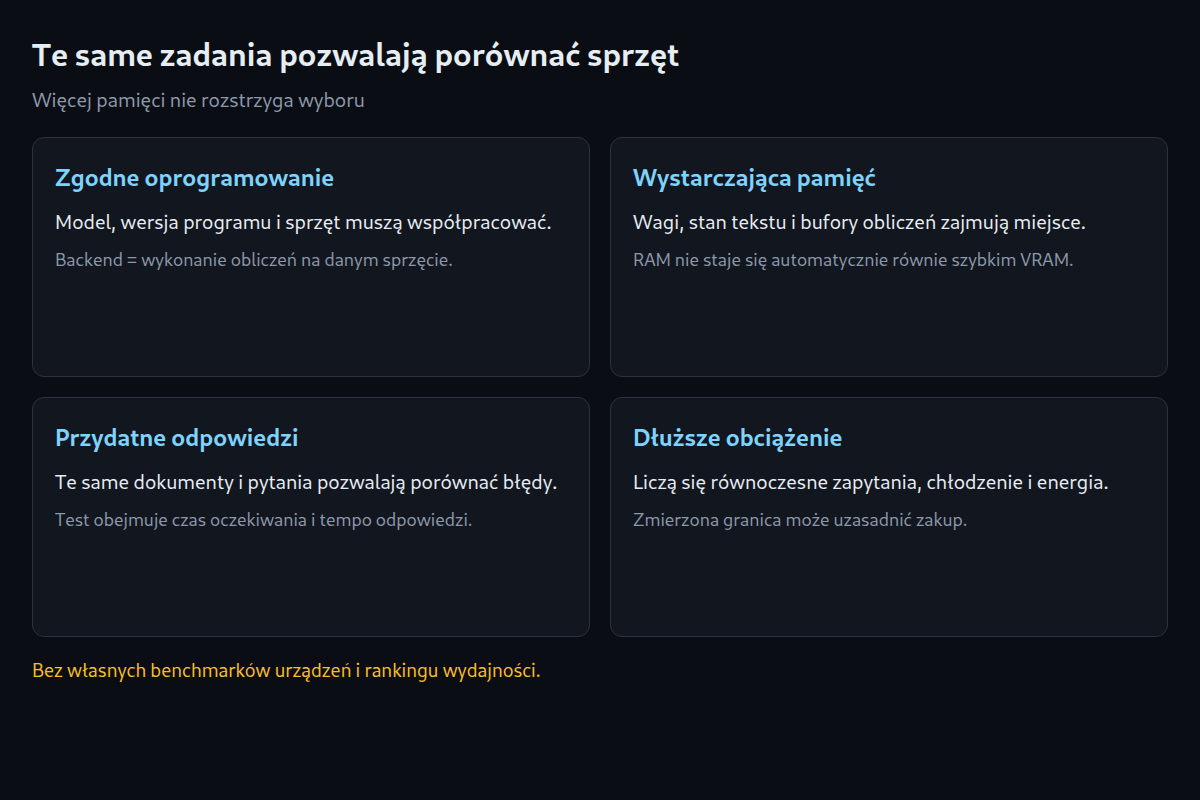
Do pierwszej próby może wystarczyć mały model na posiadanym urządzeniu. Rzetelne porównanie używa tej samej rewizji modelu, formatu liczb i tekstów wejściowych. Zapis obejmuje czas do pierwszego fragmentu odpowiedzi, tempo generowania, pamięć i błędne odpowiedzi. Kolejna próba z długim dokumentem i równoczesnymi zapytaniami może ujawnić ograniczenia. Pomoc programistyczna wymaga też odpowiednich testów wygenerowanego kodu.
Raspberry Pi może wykonywać małe eksperymenty edukacyjne lub przekazywać zapytania do innego komputera. W drugim przypadku model działa na tym drugim komputerze, a nie lokalnie na Pi. Rozmiar modelu, wersja Pi, pamięć i chłodzenie ograniczają działanie. Kalkulator pamięci pomaga we wstępnym wyborze, ale nie zastępuje próby. Konkretnym powodem zakupu może być brak możliwości uruchomienia potrzebnego modelu, przekroczenie ustalonego czasu oczekiwania lub narastająca kolejka równoczesnych zapytań.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy Raspberry Pi nadaje się do lokalnych modeli LLM?
Mały model może wystarczyć do nauki na odpowiednim Pi. Test musi potwierdzić zużycie pamięci i czas oczekiwania. Przy przekazywaniu zapytań do innego komputera model nie działa na Pi.
Czy mini PC do AI z dużą ilością RAM jest automatycznie lepszy od karty graficznej?
Nie. Więcej pamięci może umożliwić większy model. Szybkie i poprawne odpowiedzi zależą też od programu, przesyłania danych i zadania. Porównanie wymaga tych samych tekstów i ustawień.
Źródła
- Apple: Mac Studio M5 Max / M5 Ultra – dane techniczne
- Apple: dostępność Maca mini i Maca Studio
- NVIDIA: DGX Spark Hardware Overview
- Ollama: Hardware support
- llama.cpp: projekt i obsługa sprzętu
- AMD: Ryzen AI Max+ 395 i pamięć zunifikowana
Źródła ponownie sprawdzone: 25 października 2026. Bez własnych pomiarów urządzeń i rankingu szybkości odpowiedzi.
Powiązane artykuły