English
 Deutsch
 Polski
Ollama, LM Studio, llama.cpp oder vLLM: Welche Software passt zu lokalen LLMs?

Management Summary
Ollama, LM Studio, llama.cpp und vLLM sind Programme zum Betrieb eigener Sprachmodelle, also KI-Systeme für Texte und Antworten. Zum Einsatz kommen solche Lösungen auf dem eigenen Rechner oder als Dienst für mehrere Anwendungen. Das schafft mehr Kontrolle über den Betrieb, verlangt aber passende Hardware und Einrichtung. Der Artikel erklärt die unterschiedlichen Schwerpunkte: Für einen einzelnen Chat zählt einfache Bedienung, für gemeinsame Nutzung zusätzlich zuverlässiger Zugang und ausreichendes Tempo.
Inhalt
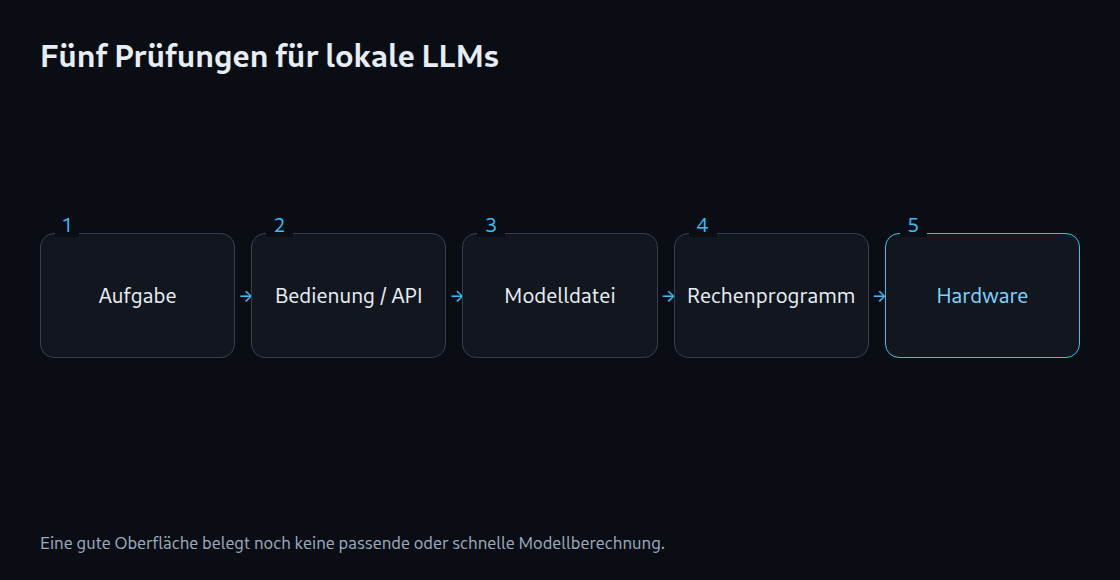
Ein lokales LLM ist ein Sprachmodell, das Antworten auf dem eigenen Rechner berechnet. Für einen Chat am Schreibtisch zählt eine einfache Bedienung. Ein Skript braucht eine Programmschnittstelle, kurz API. Bei mehreren gleichzeitigen Anfragen kommen Wartezeiten und ausreichender Speicher hinzu. Eine Oberfläche zeigt den Chat an; die Modellverwaltung lädt Modelldateien; das Rechenprogramm, auch Runtime genannt, erzeugt die Antwort. Ein Produkt kann mehrere dieser Aufgaben übernehmen.
Der Vergleich beschreibt dokumentierte Funktionen. Eigene Geschwindigkeitsmessungen liegen nicht vor. Ob eine Kombination funktioniert, hängt von Softwareversion, Modell und Hardware ab.
Sechs Wege mit unterschiedlichen Schwerpunkten
| Software | Stärke im Einsatz | Vor dem Start prüfen |
|---|---|---|
| Ollama | Modelle laden und per API ansprechen | Modelldatei, verwendetes Gerät und maximale Eingabelänge |
| LM Studio | Chat-Oberfläche, API und Betrieb ohne Oberfläche | Modellformat, Rechenprogramm und GPU-Nutzung |
| llama.cpp | GGUF-Modelle mit direkten Einstellungen ausführen | Softwareversion und Unterstützung des konkreten Modells |
| MLX LM | Sprachmodelle auf Apple Silicon ausführen | Passende MLX-Dateien und freier Speicher |
| vLLM | Modelldienst für Anwendungen und parallele Anfragen | Betriebssystem, Gerät, Modellformat und Plugin |
| OpenVINO GenAI | Modelle auf unterstützter Intel-Hardware berechnen | Passendes Modellformat und Unterstützung von CPU, GPU oder NPU |
CPU bezeichnet den Hauptprozessor, GPU den Grafikprozessor. Eine NPU ist ein zusätzlicher Prozessor für bestimmte KI-Berechnungen. Unterstützung eines Geräts bedeutet noch nicht, dass jedes Modell damit läuft.
Desktop und API getrennt auswählen
LM Studio bietet eine grafische Oberfläche und eine API. Mit llmster läuft der Rechenkern auch ohne geöffnete Desktop-App. Ollama verbindet Modellverwaltung und API. Die Entscheidung lautet deshalb nicht einfach „Desktop oder Server“. Entscheidend sind die benötigten Funktionen und die Bedienung. Eine zusätzliche Chat-Oberfläche macht das darunterliegende Rechenprogramm nicht automatisch schneller.
llama.cpp erlaubt eine direkte Einstellung der Modellberechnung und der verwendeten Hardware. Das hilft beispielsweise, dieselbe Startkonfiguration bei jedem Test zu verwenden. Trotz des Namens unterstützt das Projekt auch andere Modellfamilien als Llama. Die konkrete Modellarchitektur muss jedoch zur installierten Version passen.
Das Backend entscheidet über Hardware
Das Backend ist der Teil des Rechenprogramms, der die Hardware anspricht. Beispielsweise nutzt ein NVIDIA-Pfad CUDA, ein Apple-Pfad Metal. Eine Anleitung für NVIDIA passt deshalb nicht unverändert zu Intel Arc. Ollama unterstützt auch Vulkan unter Windows und Linux. Dafür müssen Treiber und Backend installiert sein und die Grafikkarte erkannt werden. Die Anzeige von ollama ps zeigt, ob ein geladenes Modell im CPU-Speicher, GPU-Speicher oder in beiden liegt.
Auf Apple Silicon kommen unter anderem MLX LM und Programme mit Metal-Unterstützung infrage. Für MLX vorbereitete Modelldateien und GGUF-Dateien sind unterschiedliche Formate. Beim Programmwechsel müssen Modellversion, Textzerlegung durch den Tokenizer und Chat-Vorlage zusammenpassen. Die Chat-Vorlage legt fest, wie Rollen und Nachrichten an das Modell übergeben werden. Sonst kann eine andere Antwort allein aus anders aufbereiteten Eingaben entstehen.
vLLM für den passenden Serverfall
vLLM bietet einen Modelldienst für Anwendungen, unter anderem für mehrere gleichzeitige Anfragen. Die reguläre GPU-Installation setzt Linux voraus; unter Windows ist WSL eine Möglichkeit, also eine Linux-Umgebung innerhalb von Windows. Für Apple Silicon existiert zusätzlich das separat gepflegte Plugin vLLM-Metal mit MLX. Dessen unterstützte Modelle und Funktionen sind gesondert zu prüfen. Auch bei einer unterstützten GPU funktioniert nicht automatisch jede Form der Modellkomprimierung.
Bei einem einzelnen Chat zählt, wie lange die erste Textausgabe dauert und wie flüssig der Rest erscheint. Bei mehreren Chats zählt zusätzlich, wie viele Antworten insgesamt entstehen und wie lange Anfragen in der Warteschlange bleiben. Ein schneller Einzeltest belegt deshalb keine gute Leistung bei vielen gleichzeitigen Anfragen.
Lokal installiert bedeutet nicht immer lokal gerechnet
Ollama kann auch Cloud-Modelle ansprechen. Für ausschließlich lokale Verarbeitung bietet die Dokumentation OLLAMA_NO_CLOUD=1; nach einer Änderung ist ein Neustart nötig. Bei LM Studio können heruntergeladene Modelle lokal ohne Internet laufen. Suche, Downloads und Updates benötigen dagegen eine Verbindung. Entscheidend ist bei beiden Produkten, welches Modell auf welchem Rechner ausgeführt wird.
Ein belastbarer Auswahlweg
Die Auswahl beginnt mit Betriebssystem, Hardware und Modell. Danach folgen konkrete Aufgaben: beispielsweise gültiges JSON als strukturiertes Textformat ausgeben, einen Werkzeugaufruf vorschlagen oder ein Bild beschreiben. Ein Vergleich braucht dieselben Testfragen, dieselbe Modellversion und gleiche Einstellungen. Dazu gehören die verfügbare Textlänge im Kontext und die Zufallseinstellungen der Ausgabe. Nur so lassen sich Unterschiede sinnvoll zuordnen.
Für einen einzelnen Chat kann eine Desktop-App ausreichen. Ein Dienst für andere Programme braucht außerdem dokumentierte Starteinstellungen, verständliche Fehlermeldungen und eine Grenze für gleichzeitige Anfragen. Der Speicherrechner schätzt, ob das Modell auf die Hardware passt. Ein praktischer Test muss zusätzlich zeigen, ob das gewünschte Gerät tatsächlich genutzt wird und die Antwortzeiten ausreichen.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Sind Ollama und llama.cpp austauschbar?
Ollama verwaltet Modelle und stellt eine eigene API bereit. llama.cpp ermöglicht direkten Zugriff auf die Berechnung und die Hardwareeinstellungen. Vor einem Wechsel sind Modelldatei, Chat-Vorlage und benötigte Funktionen zu vergleichen. Dieselbe Modellbezeichnung allein garantiert keine identischen Ergebnisse.
Ist vLLM für einen einzelnen Desktop-Chat nötig?
Nein. Für einen einzelnen Chat kann eine einfachere Anwendung genügen. vLLM kommt infrage, wenn dessen konkrete Funktionen benötigt werden. Ein möglicher Vorteil bei vielen parallelen Anfragen sagt noch nichts über die Bedienung oder Wartezeit eines einzelnen Chats aus.
Quellen
- Ollama: Unterstützte Hardware
- LM Studio: Dokumentation
- llama.cpp: Projekt und unterstützte Hardware
- vLLM: Installation für GPUs
- MLX LM: Modelle auf Apple Silicon
- OpenVINO: Arbeitsablauf für generative KI
- Ollama: FAQ
- LM Studio: llmster / headless
- LM Studio: Offline operation
- vLLM-Metal: Installation
- OpenVINO GenAI: Project and model preparation
Quellen geprüft: 25. Oktober 2026.
Passend dazu