English
 Deutsch
 Polski
Ollama, LM Studio, llama.cpp czy vLLM: które oprogramowanie pasuje do lokalnych modeli LLM?

Management Summary
Ollama, LM Studio, llama.cpp i vLLM uruchamiają modele językowe, czyli systemy AI pracujące z tekstem i tworzące odpowiedzi. Mogą działać na własnym komputerze lub obsługiwać kilka aplikacji. Daje to większą kontrolę nad działaniem, ale wymaga odpowiedniego sprzętu i konfiguracji. Artykuł wyjaśnia różne zastosowania: przy pojedynczym czacie ważna jest łatwa obsługa, a przy wspólnym korzystaniu także niezawodny dostęp i wystarczająca szybkość.
Spis treści
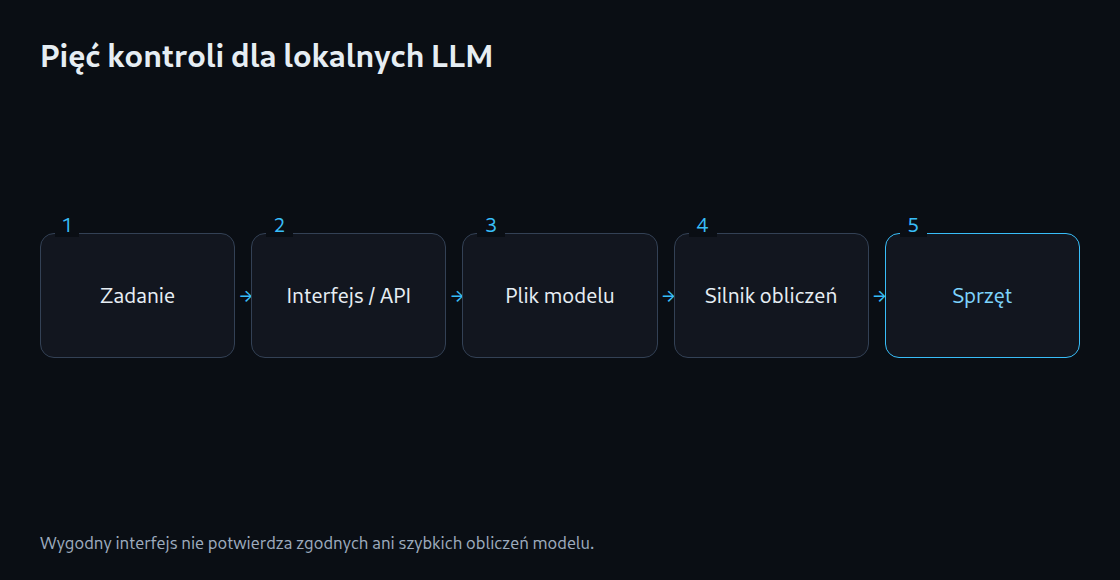
Lokalny LLM to model językowy, który oblicza odpowiedzi na komputerze, na którym został uruchomiony. W czacie na komputerze liczy się prosta obsługa. Skrypt potrzebuje interfejsu programistycznego, czyli API. Przy kilku równoczesnych żądaniach ważne są także dostępna pamięć i czas oczekiwania. Interfejs pokazuje rozmowę, funkcje zarządzania pobierają pliki modelu, a silnik obliczeniowy tworzy odpowiedź. Jeden produkt może wykonywać kilka z tych zadań.
Porównanie opisuje udokumentowane funkcje. Nie zawiera własnych pomiarów szybkości. Działanie konkretnego zestawu zależy od wersji programu, modelu i sprzętu.
Sześć ścieżek z różnymi priorytetami
| Oprogramowanie | Przydatna cecha | Kontrola przed startem |
|---|---|---|
| Ollama | Pobieranie modeli i dostęp przez API | Plik modelu, wybrane urządzenie i maksymalna długość wejścia |
| LM Studio | Interfejs czatu, API i praca bez interfejsu | Format modelu, silnik obliczeniowy i użycie GPU |
| llama.cpp | Uruchamianie modeli GGUF z bezpośrednimi ustawieniami | Wersja programu i obsługa konkretnego modelu |
| MLX LM | Uruchamianie modeli językowych na Apple Silicon | Zgodne pliki MLX i wolna pamięć |
| vLLM | Udostępnianie modeli aplikacjom i równoczesne żądania | System, urządzenie, format modelu i wtyczka |
| OpenVINO GenAI | Obliczenia na obsługiwanym sprzęcie Intel | Zgodny format modelu oraz obsługa CPU, GPU lub NPU |
CPU to główny procesor, a GPU to procesor graficzny. NPU jest dodatkowym procesorem do wybranych obliczeń AI. Obsługa urządzenia nie oznacza, że działa na nim każdy model.
Osobny wybór dla komputera i API
LM Studio udostępnia interfejs graficzny i API. Usługa llmster działa bez interfejsu aplikacji komputerowej. Ollama łączy zarządzanie modelami z API. Wybór nie sprowadza się zatem do „aplikacji albo serwera”: liczą się potrzebne funkcje i sposób obsługi. Dodanie interfejsu czatu nie przyspiesza automatycznie obliczeń.
llama.cpp pozwala bezpośrednio ustawiać parametry obliczeń i wykorzystania sprzętu. Przydaje się to na przykład do powtarzania testów z identyczną konfiguracją startową. Mimo nazwy projekt obsługuje również inne rodziny modeli niż Llama. Konkretna architektura modelu musi jednak być obsługiwana przez zainstalowaną wersję.
Backend określa zgodność sprzętu
Backend to część silnika obliczeniowego komunikująca się ze sprzętem. Przykładowo konfiguracja NVIDIA może korzystać z CUDA, a konfiguracja Apple z Metal. Instrukcja dla NVIDIA nie pasuje więc bez zmian do Intel Arc. Ollama obsługuje także Vulkan w Windows i Linux. Wymaga to zainstalowanego sterownika i backendu oraz wykrycia karty graficznej. Wynik ollama ps pokazuje, czy załadowany model zajmuje pamięć CPU, GPU czy obu urządzeń.
Na Apple Silicon dostępne są między innymi MLX LM i programy obsługujące Metal. Pliki modeli przygotowane dla MLX i pliki GGUF mają różne formaty. Przy zmianie programu muszą zgadzać się wersja modelu, tokenizer i szablon czatu. Tokenizer dzieli tekst na fragmenty rozpoznawane przez model, a szablon układa role i wiadomości. Inna odpowiedź może zatem wynikać wyłącznie z inaczej przygotowanego wejścia.
vLLM dla właściwego zadania serwerowego
vLLM udostępnia modele aplikacjom, także przy kilku równoczesnych żądaniach. Zwykła instalacja GPU wymaga systemu Linux. W Windows dostępna jest między innymi ścieżka WSL, czyli środowisko Linux działające wewnątrz Windows. Dla Apple Silicon istnieje dodatkowo osobno rozwijana wtyczka vLLM-Metal korzystająca z MLX. Obsługiwane modele i funkcje tej wtyczki wymagają osobnego sprawdzenia. Nawet obsługiwana karta GPU nie gwarantuje działania każdego sposobu kompresji modelu.
Przy pojedynczym czacie liczy się czas do pojawienia się pierwszego tekstu oraz tempo dalszej odpowiedzi. Przy kilku czatach ważna jest również łączna ilość wygenerowanego tekstu i czas oczekiwania w kolejce. Szybka odpowiedź na jedno pytanie nie potwierdza zatem dobrej pracy przy wielu równoczesnych żądaniach.
Lokalna instalacja nie zawsze oznacza lokalne obliczenia
Ollama może również korzystać z modeli w chmurze. Dokumentacja przewiduje OLLAMA_NO_CLOUD=1 dla pracy wyłącznie lokalnej; zmiana konfiguracji wymaga ponownego uruchomienia. LM Studio może uruchamiać pobrane modele lokalnie bez internetu. Wyszukiwanie, pobieranie i aktualizacje wymagają połączenia. W obu produktach znaczenie ma to, który model działa na którym komputerze.
Wiarygodna ścieżka wyboru
Wybór zaczyna się od systemu, sprzętu i modelu. Następnie dochodzą konkretne zadania, takie jak poprawny wynik w ustrukturyzowanym formacie tekstowym JSON, propozycja wywołania narzędzia lub opis obrazu. Porównanie wymaga tych samych pytań, wersji modelu i ustawień. Dotyczy to także ilości tekstu dostępnego w kontekście oraz ustawień losowości odpowiedzi. Inaczej trudno ustalić przyczynę różnic.
Do jednego czatu może wystarczyć aplikacja komputerowa. Usługa dla innych programów potrzebuje także zapisanych ustawień startowych, zrozumiałych komunikatów błędów i limitu równoczesnych żądań. Kalkulator pamięci pomaga oszacować, czy model zmieści się na sprzęcie. Test praktyczny musi dodatkowo potwierdzić użycie właściwego urządzenia i akceptowalny czas odpowiedzi.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy Ollama i llama.cpp są zamienne?
Ollama zarządza modelami i udostępnia własne API. llama.cpp zapewnia bardziej bezpośrednie ustawienia obliczeń i sprzętu. Zmiana wymaga porównania plików modelu, szablonu czatu i potrzebnych funkcji. Sama zgodność nazwy modelu nie gwarantuje identycznych wyników.
Czy vLLM jest potrzebny do pojedynczej sesji czatu na komputerze?
Nie. Do jednego czatu może wystarczyć prostsza aplikacja. vLLM jest opcją wtedy, gdy potrzebne są konkretne funkcje tego programu. Możliwa przewaga przy wielu równoczesnych żądaniach nie określa wygody obsługi ani czasu oczekiwania w pojedynczym czacie.
Źródła
- Ollama: Obsługiwany sprzęt
- LM Studio: Dokumentacja
- llama.cpp: Projekt i obsługiwany sprzęt
- vLLM: Instalacja dla GPU
- MLX LM: Modele na Apple Silicon
- OpenVINO: Praca z generatywną AI
- Ollama: FAQ
- LM Studio: llmster / headless
- LM Studio: Offline operation
- vLLM-Metal: Installation
- OpenVINO GenAI: Project and model preparation
Źródła sprawdzone: 25 października 2026.
Powiązane artykuły