English
 Deutsch
 Polski
Welche AI-Modelle passen zu Deutsch, Englisch und Polnisch?

Management Summary
KI-Modelle können beim Schreiben und Übersetzen helfen, beherrschen Deutsch, Englisch und Polnisch aber nicht automatisch gleich gut. Das betrifft besonders Redaktionen und Unternehmen mit mehrsprachigen Inhalten. Der Artikel erklärt, wie sich eine passende Unterstützung auswählen lässt: Fakten sollen erhalten bleiben und Texte natürlich klingen. Maßgeblich ist die Zeit bis zur veröffentlichungsfähigen Fassung. Ein guter englischer Text allein rechtfertigt deshalb noch nicht den Einsatz desselben Modells für alle Sprachen.
Inhalt
Ein Modell kann auf Englisch gut schreiben und bei polnischen Wortformen oder deutschen Fachbegriffen mehr Korrekturen brauchen. Ein allgemeiner Modellrang beantwortet deshalb nicht, welches Modell zu einer dreisprachigen Redaktion passt. Dieser Artikel schlägt einen eigenen Vergleich vor; eigene Modellmessungen liegen hier nicht vor. GPT, Claude, Gemini, DeepSeek und Qwen dienen als Beispiele, geprüft anhand der Herstellerunterlagen vom 25. Oktober 2026.
Mehrsprachig ist keine Qualitätsgarantie
OpenAI und Anthropic nennen mehrsprachige Fähigkeiten. Das belegt noch keine Rangfolge für Deutsch, Englisch und Polnisch. Auch frei verfügbare Modelldateien brauchen passende Sprachtests. Ein Checkpoint ist eine bestimmte gespeicherte Modellversion. Zu einem reproduzierbaren Versuch gehören außerdem das Ausführungsprogramm und die Quantisierung: eine Speicherung der Modellzahlen mit geringerer Genauigkeit, die Speicher spart und Ergebnisse verändern kann. [1, 3, 7, 8]
Dieselben Aufgaben für alle Sprachen
| Sprache | Prüfmaterial | Abnahmekriterium |
|---|---|---|
| Alle drei Sprachen | Technische Erklärung und kurze FAQ | Fachbegriffe, klare Bezüge, neutraler Stil |
| Alle drei Sprachen | Produktbeschreibung und Zusammenfassung | Genaue Aussagen, natürliche Sprache, keine Zusätze |
| Alle drei Sprachen | Übersetzung und Beschriftungen einer Oberfläche | Wortformen, Wortwahl und natürliche Satzstruktur |
| Sprachübergreifend | Dieselben geprüften Fakten | Identische Zahlen, Einschränkungen und Aussagen |
Ein nachvollziehbarer Sprachvergleich
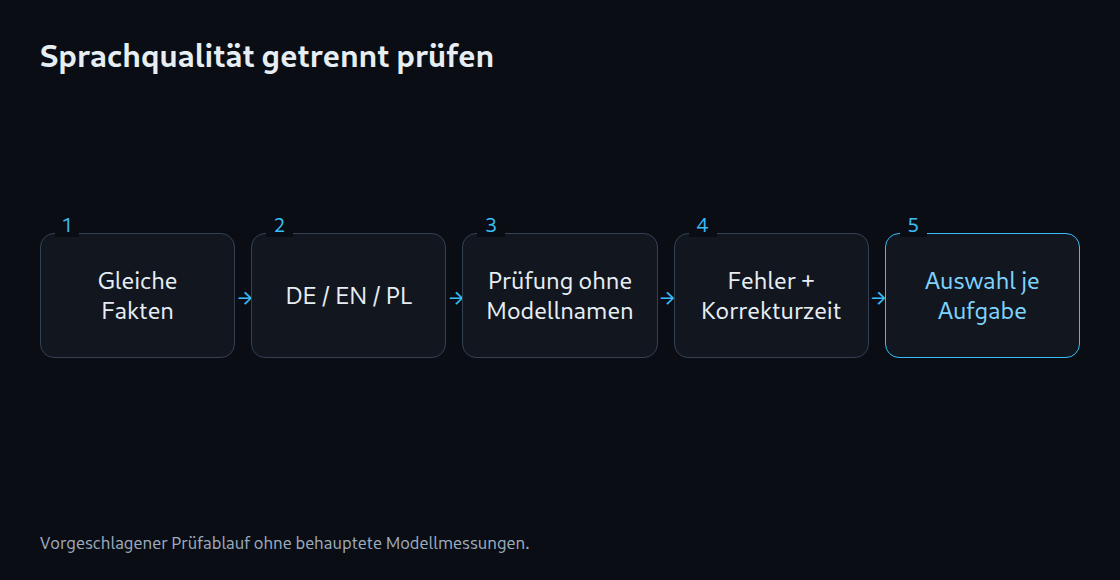
Ein kleiner Einstiegstest könnte zwölf Aufgaben je Sprache enthalten. Das ist ein Vorschlag, keine repräsentative Messung. Alle Sprachen erhalten dieselben Aufgabentypen und vergleichbar schwierige Inhalte; nur deutsche Fachtexte gegen englische Zusammenfassungen zu stellen wäre unfair. Jede Aufgabe enthält geprüfte Fakten, erlaubte Fachbegriffe, Zielgruppe und gewünschte Länge. Ein Teil verlangt einen neuen Text, ein anderer eine Übersetzung. Die Ausgangssprache der Übersetzungen sollte wechseln, damit Englisch nicht stets die Vorlage liefert.
Die Bewertung trennt sachliche Fehler, ausgelassene Einschränkungen, Grammatik, Fachbegriffe und unbelegte Zusätze. Aus „bis zu 30 Tage“ darf zum Beispiel nicht „30 Tage“ werden. Gut klingende Sätze gleichen einen solchen Fehler nicht aus. Fachkundige Personen bewerten Ausgaben ohne sichtbaren Modellnamen und in gemischter Reihenfolge. Mehrere Antworten je Aufgabe zeigen Schwankungen. Neben Fehlerart und Schwere zählt die Zeit bis zu einer freigabefähigen Fassung. Bei unterschiedlichen Textlängen sind rohe Fehlerzahlen oder Korrekturminuten allein nicht vergleichbar.
Cloud und lokale Varianten fair vergleichen
Als konkrete Kandidaten kommen beispielsweise GPT-6.1 Sol, Claude Sonnet 5.5 und Gemini 3.8 Flash über die jeweilige Programmierschnittstelle infrage. GPT-6 Astra und Claude Opus 5.5 können weitere Vergleichskandidaten sein. Qwen3.8-27B bietet herunterladbare Modelldateien; ob die lokale Ausführung passt, hängt von Speicher und unterstützter Software ab. DeepSeek-V4.1-Flash benötigt bei eigener Ausführung erheblich mehr Infrastruktur als ein kleines Desktopmodell. Die Beispiele sind keine vollständige Liste und keine belegten Sprachsieger. [2, 4–8]
Das Testprotokoll hält Modellkennung, Testdatum, Eingabe, Ausgabelänge und unterstützte Einstellungen für den Denkaufwand fest. Bei lokaler Ausführung kommen Programmversion, Hardware, Kontextlänge und Chatvorlage hinzu. Kontext ist die verarbeitete Eingabe samt Gesprächsverlauf; die Chatvorlage legt das Format dieser Nachrichten fest. Q8 und Q4 bezeichnen grob unterschiedliche Genauigkeiten der Modellzahlen; genaue Dateivariante und Verfahren gehören deshalb ins Protokoll. Ein Wechsel ist eine neue Testbedingung. Ollama ist ein Ausführungsprogramm und unterstützt auch Cloudmodelle: Der Name allein belegt keine lokale Verarbeitung. [9]
Die Auswahl pro Aufgabe
Eine Redaktion kann pro Aufgabe und Sprache unterschiedliche Modelle einsetzen. Ein günstigeres Modell ist erst dann passend, wenn die verlangte Qualität erreicht wird. Die Auswertung zeigt daher Ergebnisse je Sprache und Aufgabentyp: schwere Fehler, Korrekturzeit, Antwortzeit und Kosten bis zum brauchbaren Ergebnis. Ein einziger Mittelwert könnte schwache polnische Antworten hinter guten englischen Antworten verstecken. Die Freigabe durch eine fachkundige Person bleibt auch bei guten Testwerten nötig.
Passende Werkzeuge
Fragen und Antworten
Belegt ein englischer Benchmark polnische Sprachqualität?
Nein. Ein Benchmark ist ein festgelegter Aufgabentest. Ein englischer Test zeigt nicht automatisch, ob polnische Wortformen, Fachbegriffe und Bedeutungen korrekt bleiben. Dafür braucht es geeignetes polnisches Prüfmaterial.
Sollten alle drei Sprachen dasselbe Modell verwenden?
Ein gemeinsames Modell vereinfacht den Ablauf. Verschiedene Modelle sind ebenfalls möglich, wenn dieselben Fakten, Fachbegriffe und Freigabekriterien gelten. Die Entscheidung folgt den Ergebnissen für die jeweilige Aufgabe und Sprache.
Quellen
- OpenAI: Modellübersicht
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude-Modellübersicht
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash Modellbeschreibung
- Qwen: Qwen3.8-27B Modellbeschreibung
- Ollama: FAQ zu lokalem Betrieb und Cloud
- OpenAI: API-Preise
- DeepSeek: Modelle und Preise
- Google: Dokumentverarbeitung
Quellen geprüft: 25. Oktober 2026.
Passend dazu