English
 Deutsch
 Polski
Które modele AI pasują do niemieckiego, angielskiego i polskiego?

Management Summary
Modele AI pomagają pisać i tłumaczyć, lecz dobra angielszczyzna nie oznacza automatycznie równie dobrego polskiego lub niemieckiego. Dotyczy to redakcji i firm publikujących w kilku językach. Artykuł wyjaśnia wybór odpowiedniego wsparcia: fakty muszą pozostać zachowane, a tekst brzmieć naturalnie. Korzyścią jest mniej pracy do uzyskania wersji gotowej do publikacji. Dobry wynik angielski sam nie uzasadnia więc wyboru tego samego modelu dla wszystkich języków.
Spis treści
Model może dobrze pisać po angielsku, a wymagać większej liczby poprawek polskich form wyrazów lub niemieckich terminów technicznych. Ogólna pozycja w rankingu nie rozstrzyga więc wyboru dla redakcji trójjęzycznej. Artykuł proponuje sposób porównania; nie zawiera własnych pomiarów modeli. GPT, Claude, Gemini, DeepSeek i Qwen są przykładami sprawdzonymi w dokumentacji producentów 25 października 2026.
Wielojęzyczność bez gwarancji jakości
OpenAI i Anthropic wymieniają obsługę wielu języków. Nie dowodzi to kolejności jakości dla niemieckiego, angielskiego i polskiego. Dostępne pliki modeli także wymagają odpowiednich testów językowych. Checkpoint oznacza konkretną zapisaną wersję modelu. Powtarzalny test zapisuje też program uruchamiający i kwantyzację: zapis liczb modelu z mniejszą dokładnością, który oszczędza pamięć, ale może zmieniać wyniki. [1, 3, 7, 8]
Te same zadania we wszystkich językach
| Język | Materiał | Kryterium akceptacji |
|---|---|---|
| Wszystkie trzy języki | Wyjaśnienie techniczne i krótkie FAQ | Terminy, jasne odniesienia, neutralny styl |
| Wszystkie trzy języki | Opis produktu i streszczenie | Dokładne twierdzenia, naturalny język, brak dodatków |
| Wszystkie trzy języki | Tłumaczenie i etykiety interfejsu | Formy wyrazów, słownictwo i naturalna składnia |
| Między językami | Te same sprawdzone fakty | Jednakowe liczby, zastrzeżenia i twierdzenia |
Powtarzalne porównanie języków
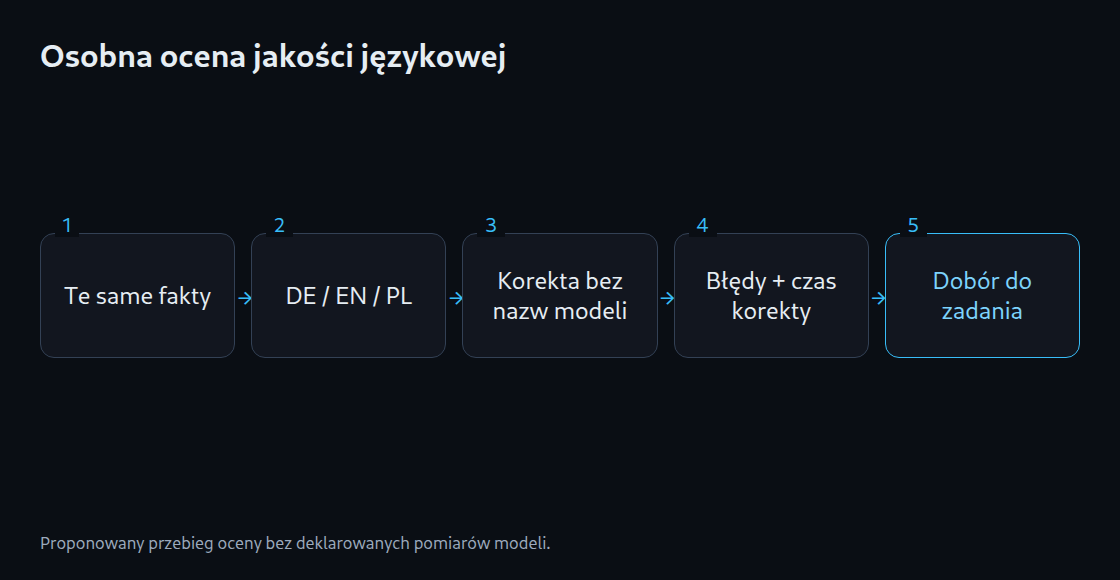
Mały test początkowy może zawierać dwanaście zadań na język. To propozycja, a nie reprezentatywny pomiar. Każdy język otrzymuje te same typy zadań i treści o podobnej trudności; porównanie wyłącznie niemieckich tekstów technicznych z angielskimi streszczeniami byłoby nierzetelne. Każde zadanie określa sprawdzone fakty, dozwolone terminy, odbiorców i oczekiwaną długość. Część wymaga nowego tekstu, a część tłumaczenia. Języki źródłowe tłumaczeń powinny się zmieniać, aby angielski nie był zawsze punktem wyjścia.
Ocena rozdziela błędy rzeczowe, pominięte zastrzeżenia, gramatykę, terminologię i nieuzasadnione dodatki. Na przykład „do 30 dni” nie może zmienić się w „30 dni”. Płynny styl nie rekompensuje takiego błędu. Kompetentne osoby oceniają wyniki bez widocznych nazw modeli i w zmieszanej kolejności. Kilka odpowiedzi na zadanie pokazuje zmienność. Oprócz rodzaju i wagi błędu liczy się czas doprowadzenia tekstu do akceptowalnej wersji. Same liczby błędów lub minuty korekty nie są porównywalne przy różnych długościach tekstu.
Uczciwe porównanie chmury i wariantów lokalnych
Przykładowi kandydaci to GPT-6.1 Sol, Claude Sonnet 5.5 i Gemini 3.8 Flash przez odpowiednie interfejsy programistyczne. GPT-6 Astra i Claude Opus 5.5 mogą rozszerzyć porównanie. Qwen3.8-27B udostępnia pliki modelu do pobrania; przydatność lokalna zależy od pamięci i obsługi przez oprogramowanie. Samodzielne uruchomienie DeepSeek-V4.1-Flash wymaga znacznie większej infrastruktury niż mały model na komputerze osobistym. To nie jest pełna lista ani zestaw potwierdzonych zwycięzców językowych. [2, 4–8]
Rejestr testu zapisuje identyfikator modelu, datę, dane wejściowe, długość odpowiedzi i obsługiwane ustawienia nakładu rozumowania. Przy uruchomieniu lokalnym dochodzą wersja programu, sprzęt, długość kontekstu i szablon czatu. Kontekst to przetwarzane dane wejściowe wraz z historią rozmowy; szablon czatu określa format wiadomości. Q8 i Q4 wskazują w przybliżeniu różne dokładności liczb modelu, dlatego rejestr wymaga konkretnego wariantu pliku i metody. Zmiana tworzy nowy warunek testowy. Ollama to program uruchamiający, który obsługuje również modele chmurowe: sama nazwa nie dowodzi przetwarzania lokalnego. [9]
Dobór według zadania
Redakcja może stosować różne modele zależnie od zadania i języka. Tańszy model pasuje dopiero po spełnieniu wymaganej jakości. Wyniki pozostają więc osobne dla języka i typu zadania: poważne błędy, czas korekty, czas odpowiedzi i koszt uzyskania użytecznego wyniku. Jedna średnia mogłaby ukryć słabe odpowiedzi polskie za dobrymi angielskimi. Kontrola przez kompetentną osobę pozostaje potrzebna także po dobrych wynikach testu.
Powiązane narzędzia
Pytania i odpowiedzi
Czy angielski benchmark potwierdza jakość języka polskiego?
Nie. Benchmark to ustalony zestaw zadań testowych. Test angielski nie dowodzi automatycznie poprawności polskich form wyrazów, terminów i znaczeń. Do takiej oceny potrzebny jest odpowiedni materiał polski.
Czy wszystkie języki powinny używać tego samego modelu?
Wspólny model upraszcza pracę. Różne modele także są możliwe, jeśli obowiązują te same fakty, terminy i kryteria akceptacji. Decyzja wynika z rezultatów dla konkretnego zadania i języka.
Źródła
- OpenAI: katalog modeli
- OpenAI: GPT-6.1 Sol
- Anthropic: przegląd modeli Claude
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash opis modelu
- Qwen: Qwen3.8-27B opis modelu
- Ollama: FAQ o pracy lokalnej i chmurze
- OpenAI: ceny API
- DeepSeek: modele i ceny
- Google: przetwarzanie dokumentów
Źródła sprawdzone: 25 października 2026.
Powiązane artykuły