English
 Deutsch
 Polski
BigQuery-Kosten beim GA4-Export: Welche Tabellen und Spalten eine Abfrage liest und der kostenlose Probelauf

Management Summary
BigQuery wertet gespeicherte Website-Daten aus, darunter Exporte aus Google Analytics. Bei nutzungsabhängiger Abrechnung hängen die Kosten von der gelesenen Datenmenge ab, nicht einfach von der Kürze des fertigen Berichts. Nur benötigte Tage und Felder auszuwählen kann deshalb Kosten senken. Der Beitrag erklärt diesen Zusammenhang und die Schätzung vor einer Auswertung. Wiederverwendbare Zusammenfassungen sparen Arbeit, müssen aber Pflegekosten und spätere Korrekturen der Quelldaten berücksichtigen.
Inhalt
Ein kleines Abfrageergebnis bedeutet nicht automatisch eine kleine BigQuery-Rechnung. Bei der On-Demand-Abrechnung von Abfragen zählt die verarbeitete Datenmenge, nicht die Anzahl zurückgegebener Zeilen. Die Auswahl benötigter Tagestabellen und Felder kann deshalb wesentlich mehr sparen als eine Begrenzung der Ergebniszeilen.
Der Artikel behandelt Abfragen auf den GA4-Export. Die kapazitätsbasierte BigQuery-Abrechnung richtet sich nach Rechenkapazität statt nach einem direkten Bytepreis je Abfrage; Speicherung und Datenübernahme haben eigene Kostenregeln. Ein Probelauf hilft bei der Schätzung, garantiert aber keine exakte Endrechnung.
LIMIT begrenzt den Scan nicht zuverlässig
Clusterung ordnet gespeicherte Daten nach ausgewählten Spalten. Passende Filter können dadurch nicht benötigte Datenblöcke überspringen. Bei einer nicht geclusterten Tabelle verringert SELECT * ... LIMIT 10 die gelesenen Bytes der ausgewählten Spalten nicht. Zehn Ergebniszeilen können einen großen Scan voraussetzen. Für einen ersten Blick ohne Abfragelauf eignen sich die Tabellenvorschau oder bq head.
Eine Ausnahme besteht bei geclusterten Tabellen: Sobald genügend Blöcke das begrenzte Ergebnis liefern, kann der Scan unter Umständen enden. Daraus entsteht keine allgemeine Kostensicherung durch LIMIT. Auch ORDER BY benötigt Rechenarbeit und ist nicht automatisch kostenlos, selbst bei unveränderter Auswahl der Eingabespalten.
Tabellenauswahl und Zeilenfilter erfüllen verschiedene Aufgaben
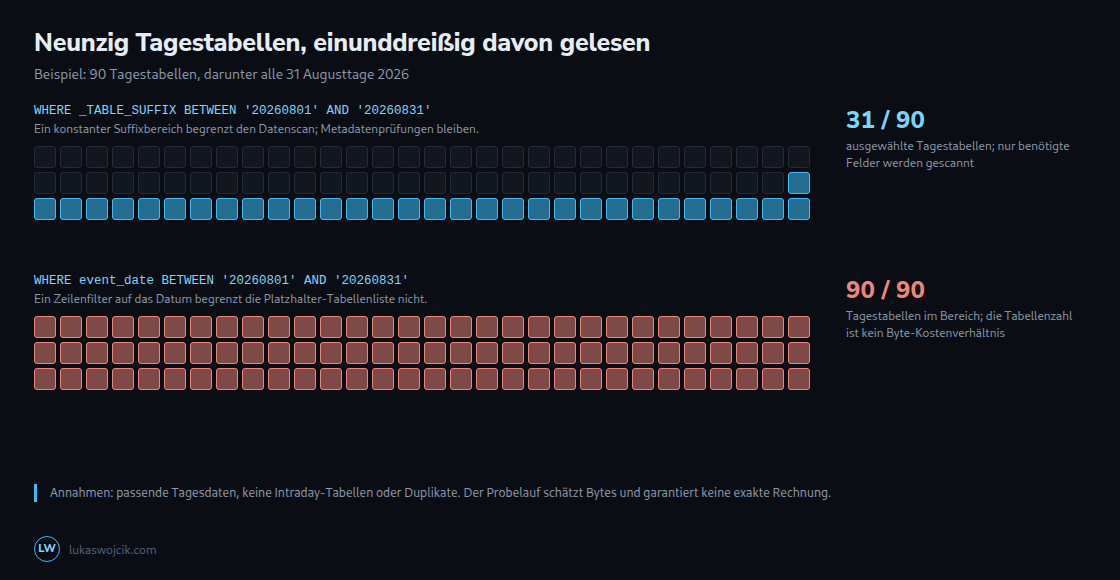
Bei events_* enthält _TABLE_SUFFIX den Namensteil hinter events_. Ein konstanter Datumsbereich beschränkt die gescannten Tagestabellen. Die folgende Abfrage wählt August 2026; Projekt- und Datensatzname sind Platzhalter.
SELECT event_date, event_name, user_pseudo_id
FROM `project.analytics_12345.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831';
Ein Ersatz durch event_date BETWEEN '20260801' AND '20260831' filtert Zeilen, begrenzt aber für sich genommen nicht die Tabellenliste des Platzhalters. Identische Ergebnisse entstehen nur bei passenden Tagestabellen ohne zusätzliche Treffer, Duplikate oder abweichende Daten. Der Suffixbereich schließt intraday_... aus; ein Filter allein auf das Ereignisdatum erfüllt diese Aufgabe nicht.
Ein dynamisch aus einer anderen Tabelle ermittelter Suffixfilter kann die Scanbegrenzung verhindern. Zudem überspringt ein Suffixfilter nicht sämtliche Metadatenprüfungen: Ein inkompatibles Schema oder eine vom Platzhalter erfasste View kann weiterhin zum Fehler führen. Eine möglichst enge Tabellenliste und ein ausreichend spezifisches Präfix vereinfachen die Abfrage. Streaming-Daten des laufenden Tages benötigen eine bewusst getrennte Auswahl.
Verschachtelte Unterfelder lassen sich gezielt auswählen
event_params ist ein Array aus Datensätzen mit Schlüssel und typisierten Wertfeldern. Das Feld ist kein unteilbarer Block, der für jeden Parameter vollständig gelesen werden muss. Das Beispiel verwendet key und value.string_value, statt sämtliche Zahlenfelder und den vollständigen Datensatz anzufordern.
SELECT event_timestamp,
  (SELECT p.value.string_value
   FROM UNNEST(event_params) AS p
   WHERE p.key = 'page_location') AS page_location
FROM `project.analytics_12345.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831';
Die Unterabfrage liefert je Ereignis höchstens einen einzelnen Wert. Dafür setzt die Abfrage höchstens einen Schlüssel page_location je Ereignis voraus. Ein fehlender Schlüssel ergibt NULL; doppelte Schlüssel verursachen einen Fehler und benötigen eine ausdrückliche Qualitäts- oder Auswahlregel. Der Schlüsselfilter erzeugt keine separat gespeicherte Spalte page_location: Die benötigten Schlüssel- und Zeichenkettenfelder müssen weiterhin untersucht werden.
Die gezielte Auswahl gilt ebenso für device, geo, items und user_properties. Diese Felder können für eine Auswertung unverzichtbar sein. Entscheidend ist die Auswahl benötigter Felder, kein pauschaler Ausschluss ganzer Strukturen. Auch Filter, Verknüpfungen und Sortierung können Felder außerhalb der Ergebnisliste benötigen.
Eine kostenlose Schätzung, keine exakte Rechnung
Der Abfrageeditor prüft SQL und schätzt die verarbeiteten Bytes. Das entsprechende Kommando prüft ohne Ausführung der Abfrage:
bq query --use_legacy_sql=false --dry_run < query.sqlquery.sql enthält eine vollständige Abfrage mit tatsächlichem Projekt, Datensatz und Zeitraum. Eine feste Bytezahl gilt nicht für jede GA4-Property. Bei geclusterten Tabellen kann die Schätzung über dem tatsächlichen Scan liegen, weil übersprungene Blöcke erst bei der Ausführung feststehen. Ein erfolgreicher Probelauf garantiert auch keinen erfolgreichen Echtlauf; Skripte und dynamisches SQL haben zusätzliche Prüfgrenzen.
Die tatsächliche On-Demand-Gebühr hängt außerdem von Tarif, Freimenge, Rundung und Mindestabrechnung ab. BigQuery nennt mindestens 10 MB je referenzierter Tabelle und je Abfrage. Treffer im Ergebniscache können Abfragegebühren vermeiden; Abfragen über mehrere Tabellen mit Platzhalter unterstützen diesen Cache jedoch nicht. Kapazitätskosten auf Slotbasis lassen sich aus der Byteschätzung nicht exakt berechnen.
Clusterung und eine wiederverwendbare Ergebnistabelle
Eine Tabelle mit ausschließlich benötigten Feldern und zusammengefassten Ergebnissen kann wiederholte Arbeit reduzieren, wenn viele Berichte dieselben Felder oder Aggregate verwenden. Die Ersparnis muss Aktualisierung und Speicherung rechtfertigen; eine allgemeine Grenze von drei manuellen Ausführungen existiert nicht. Das Beispiel erstellt eine leere Tabelle für Ereigniszahlen je Datum, Ereignisname und pseudonymer Kennung. Die Anweisung füllt keine Daten ein und berechnet keine Nutzer- oder Sitzungszahlen.
CREATE TABLE IF NOT EXISTS `project.analytics_12345.daily_user_metrics`
(
  event_date DATE,
  event_name STRING,
  user_pseudo_id STRING,
  total_events INT64
)
PARTITION BY event_date
CLUSTER BY event_name, user_pseudo_id
OPTIONS (require_partition_filter = TRUE);
Zum Befüllen muss die exportierte Zeichenkette event_date mit PARSE_DATE('%Y%m%d', event_date) in ein Datum umgewandelt werden; total_events benötigt die beabsichtigte Gruppierung nach Datum, Ereignisname und Kennung.
Der Datensatz muss am passenden Standort existieren. IF NOT EXISTS repariert keine vorhandene Tabelle mit abweichendem Schema oder anderer Clusterung. Partitionen teilen die Tabelle nach Datum in Abschnitte auf. Die Partitionsfilteroption verlangt in späteren Abfragen eine geeignete Bedingung für dieses Datum; ein unnötig weiter Datumsbereich kann trotzdem viele Daten lesen.
Clusterung kann bei geeigneten Filtern Speicherblöcke überspringen. Bis zu vier Clusterspalten sind möglich; die Reihenfolge zählt. event_name an erster Stelle passt zu häufigen Filtern auf dieses Feld. Abfragen ausschließlich nach Kennung können eine andere Reihenfolge benötigen. Kleine Tabellen oder kleine Tagespartitionen profitieren möglicherweise kaum. Maßgeblich sind Messungen mit den tatsächlich verwendeten Berichten.
Fragen und Antworten
Lässt sich eine teure Abfrage vor der Ausführung abweisen?
Für On-Demand-Abfragen setzt --maximum_bytes_billed eine Grenze für die geschätzten abrechenbaren Bytes je Abfrage. Eine höhere Schätzung führt zur Abweisung ohne Ausführung. Eine geclusterte Abfrage kann dadurch auch bei einem später möglicherweise kleineren Scan abgewiesen werden. Tageskontingente je Projekt oder Nutzer ergänzen diese Kontrolle; Google beschreibt benutzerdefinierte Kontingente allerdings als näherungsweise statt als absolute Ausgabengarantie.
Wie gelangen verspätete GA4-Ergänzungen in die Ergebnistabelle?
GA4 kann Tagestabellen bis zu drei Tage nach dem Ereignisdatum aktualisieren. Ein täglicher Lauf kann die vier abgeschlossenen Kalendertage vor dem aktuellen Datum in der Property-Zeitzone neu aufbauen. Der älteste Tag wird dadurch nach Ablauf des vollständigen dreitägigen Ergänzungsfensters nochmals gelesen. Das ist etwas anderes als ausschließlich den Vortag anzuhängen oder heute unter vier Tagen mitzuzählen.
Vor dem Ersetzen vorhandener Ergebnisse muss der Lauf alle erwarteten Quelltabellen prüfen und die Ersatzdaten erfolgreich lesen. Eine fehlende Tabelle belegt keine null Ereignisse. Die Zwischentabelle hält Ersatzdaten bereit, bevor die Zieltabelle verändert wird. Eine Transaktion übernimmt Löschung und Einfügen gemeinsam; bei einem Fehler bleibt keine der beiden Änderungen bestehen. Eine Zwischentabelle und anschließend eine Transaktion für zeitlich begrenztes DELETE und INSERT verhindern eine leere Zieltabelle nach fehlgeschlagenem Einfügen. Ein passend begrenztes MERGE benötigt ebenfalls eine Regel für Zielzeilen, die in der Quelle nicht mehr vorkommen.
Die Existenz einer Tabelle beweist keinen vollständigen Export. Exportverzögerungen, historische Korrekturen und Löschungen benötigen Überwachung sowie einen Reparaturweg außerhalb des rollierenden Fensters. Aktualisierungsläufe sollten zudem nicht überlappen. Partitionierung und Suffixfilter liefern diese Vollständigkeitsprüfungen nicht automatisch.
Quellen
- BigQuery-Preise
- Entwicklungsdokumentation für Google Analytics 4
- Einführung in geclusterte Tabellen
- Google: Kosten schätzen und begrenzen
- Google: Tabellenabfragen mit Platzhaltern
- Google: Schema des GA4-Exports nach BigQuery
- Google: verschachtelte und wiederholte Felder
- Google: Berechnungsaufwand von Abfragen
- Google: eigene Abfragekontingente
- Google: Abfragen mit mehreren Anweisungen
Passend dazu