English
 Deutsch
 Polski
Koszty BigQuery przy eksporcie GA4: które tabele i kolumny czyta zapytanie oraz bezpłatny dry run

Management Summary
BigQuery analizuje zapisane dane witryny, w tym eksporty z Google Analytics. Przy rozliczeniu według użycia koszt zależy od ilości odczytanych danych, a nie jedynie od długości gotowego raportu. Wybór tylko potrzebnych dat i pól może więc ograniczyć wydatki. Artykuł wyjaśnia ten związek oraz korzyść z oszacowania zapytania przed wykonaniem. Gotowe podsumowania mogą zmniejszać powtarzaną pracę, jeśli uwzględniają koszt utrzymania i późniejsze korekty danych źródłowych.
Spis treści
Mały wynik zapytania nie oznacza automatycznie małego rachunku BigQuery. Przy rozliczaniu zapytań na żądanie liczy się ilość przetworzonych danych, a nie liczba zwróconych wierszy. Wybór potrzebnych tabel dziennych i pól może zatem dać większą oszczędność niż ograniczenie liczby wyników.
Artykuł dotyczy zapytań do eksportu GA4. Rozliczenie BigQuery oparte na mocy obliczeniowej zależy od tej mocy, zamiast od bezpośredniej opłaty za bajty pojedynczego zapytania. Przechowywanie i przyjmowanie danych mają odrębne zasady kosztów. Przebieg próbny pomaga oszacować zapytanie, lecz nie gwarantuje dokładnej końcowej opłaty.
LIMIT nie jest niezawodnym ograniczeniem skanowania
Klastrowanie porządkuje zapisane dane według wybranych kolumn. Odpowiednie filtry mogą dzięki temu pomijać niepotrzebne bloki danych. Dla tabeli bez klastrowania SELECT * ... LIMIT 10 nie zmniejsza liczby bajtów odczytanych z wybranych kolumn. Dziesięć wierszy wyniku może wymagać dużego skanu. Do pierwszego oglądu bez uruchamiania zapytania lepiej nadaje się podgląd tabeli lub bq head.
Istnieje wyjątek: w tabeli klastrowanej skan może czasem zakończyć się po odczytaniu wystarczającej liczby bloków. Nie czyni to z LIMIT ogólnego zabezpieczenia kosztowego. Sortowanie przez ORDER BY również wymaga obliczeń i nie jest automatycznie bezpłatne, nawet przy niezmienionym zestawie kolumn wejściowych.
Wybór tabel i filtrowanie wierszy mają różne zadania
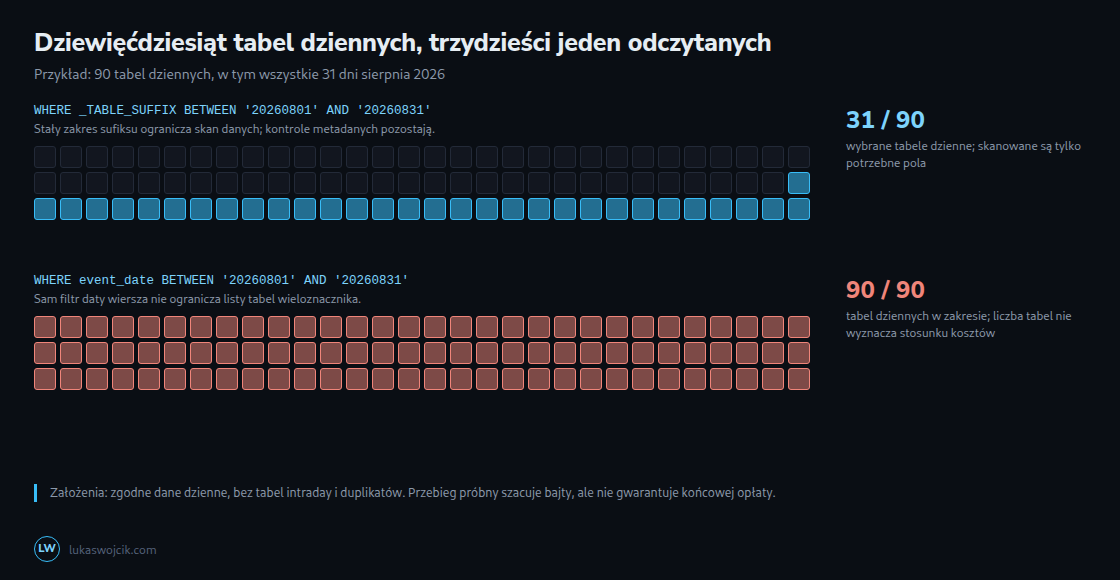
Dla events_* pole _TABLE_SUFFIX zawiera część nazwy po events_. Stały zakres dat ogranicza skanowane tabele dzienne. Przykład wybiera sierpień 2026; nazwy projektu i zbioru danych są symboliczne.
SELECT event_date, event_name, user_pseudo_id
FROM `project.analytics_12345.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831';
Zastąpienie warunku przez event_date BETWEEN '20260801' AND '20260831' filtruje wiersze, ale samo nie ogranicza listy tabel dopasowanych przez wieloznacznik. Wyniki są zgodne tylko dla oczekiwanych danych dziennych, bez dodatkowych dopasowanych źródeł wprowadzających duplikaty lub inne wiersze. Zakres sufiksu wyklucza intraday_...; sam filtr daty zdarzenia tego nie zapewnia.
Warunek sufiksu wyliczany dynamicznie z innej tabeli może nie ograniczać skanowania. Filtr sufiksu nie pomija też wszystkich kontroli metadanych: niezgodny schemat albo widok dopasowany przez wieloznacznik może nadal powodować błąd. Możliwie wąska lista tabel i dostatecznie szczegółowy prefiks upraszczają zapytanie. Dane strumieniowe bieżącego dnia wymagają świadomie oddzielnego wyboru.
Zagnieżdżone pola można wybierać osobno
event_params jest tablicą rekordów z kluczem i polami wartości określonych typów. Nie jest niepodzielnym blokiem, który trzeba odczytać w całości przy każdym parametrze. Przykład odwołuje się do key i value.string_value, zamiast pobierać wszystkie pola liczbowe i cały rekord.
SELECT event_timestamp,
  (SELECT p.value.string_value
   FROM UNNEST(event_params) AS p
   WHERE p.key = 'page_location') AS page_location
FROM `project.analytics_12345.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831';
Podzapytanie zwraca najwyżej jedną wartość na zdarzenie. Dlatego zakłada najwyżej jeden klucz page_location na zdarzenie. Brak klucza daje NULL; powtórzone klucze powodują błąd i wymagają jawnej reguły jakości lub wyboru. Filtrowanie klucza nie tworzy fizycznie odrębnej kolumny page_location: potrzebne pola kluczy i wartości tekstowych nadal trzeba sprawdzić.
Jawny wybór dotyczy także device, geo, items i user_properties. Te pola mogą być niezbędne do analizy. Właściwą zasadą jest wybór potrzebnych pól, a nie ogólne odrzucanie całych struktur. Filtry, złączenia i sortowanie mogą wymagać również pól spoza końcowej listy wynikowej.
Bezpłatne oszacowanie zamiast dokładnego rachunku
Edytor sprawdza SQL i szacuje liczbę przetworzonych bajtów. Odpowiednik wiersza poleceń działa bez wykonywania zapytania:
bq query --use_legacy_sql=false --dry_run < query.sqlPlik query.sql zawiera pełne zapytanie z rzeczywistym projektem, zbiorem i datami. Żadna stała liczba bajtów nie pasuje do każdej usługi GA4. Przy tabelach klastrowanych oszacowanie może przekraczać końcowy skan, ponieważ pomijane bloki są ustalane podczas wykonania. Udany przebieg próbny nie gwarantuje udanego wykonania; skrypty i dynamiczny SQL mają dodatkowe ograniczenia walidacji.
Rzeczywista opłata na żądanie zależy także od taryfy, bezpłatnego limitu, zaokrąglenia i minimalnej rozliczanej ilości danych. BigQuery podaje minimum 10 MB na przywołaną tabelę i na zapytanie. Trafienie w pamięci podręcznej wyników może uniknąć opłaty za zapytanie, lecz zapytania do wielu tabel przez wieloznacznik nie obsługują takiej pamięci. Kosztu mocy opartej na slotach nie da się dokładnie wyliczyć z oszacowania bajtów.
Klastrowanie i tabela wynikowa wielokrotnego użytku
Tabela zawierająca tylko potrzebne pola i podsumowania może ograniczyć powtarzaną pracę, gdy wiele raportów korzysta z tych samych pól lub agregatów. Oszczędność musi uzasadniać koszty odświeżania i przechowywania; nie istnieje uniwersalny próg trzech ręcznych uruchomień. Przykład tworzy pustą tabelę na liczby zdarzeń grupowane według daty, nazwy zdarzenia i pseudonimowego identyfikatora. Nie wstawia danych ani nie oblicza liczby użytkowników lub sesji.
CREATE TABLE IF NOT EXISTS `project.analytics_12345.daily_user_metrics`
(
  event_date DATE,
  event_name STRING,
  user_pseudo_id STRING,
  total_events INT64
)
PARTITION BY event_date
CLUSTER BY event_name, user_pseudo_id
OPTIONS (require_partition_filter = TRUE);
Wypełnienie tabeli wymaga zamiany eksportowanego tekstu event_date na datę przez PARSE_DATE('%Y%m%d', event_date) oraz grupowania według daty, nazwy zdarzenia i identyfikatora w celu obliczenia total_events.
Zbiór danych musi istnieć w odpowiedniej lokalizacji. IF NOT EXISTS nie naprawia istniejącej tabeli o innym schemacie lub klastrowaniu. Partycje dzielą tabelę na części według daty. Opcja filtra partycji wymaga w kolejnych zapytaniach odpowiedniego warunku dotyczącego tej daty; zbyt szeroki zakres nadal może odczytać dużo danych.
Klastrowanie może pomijać bloki dla odpowiednich filtrów. Obsługiwane są maksymalnie cztery kolumny klastrowania, a kolejność ma znaczenie. event_name na początku odpowiada częstym filtrom po tym polu; zapytania wyłącznie po identyfikatorze mogą wymagać innej kolejności. Małe tabele lub małe partycje dzienne mogą zyskać niewiele. Potrzebne są pomiary z rzeczywistymi raportami.
Pytania i odpowiedzi
Czy drogie zapytanie może zostać odrzucone przed wykonaniem?
Dla zapytań rozliczanych na żądanie --maximum_bytes_billed ustawia granicę szacowanych rozliczanych bajtów na zapytanie. Wyższe oszacowanie powoduje odrzucenie bez wykonania. Zapytanie do tabeli klastrowanej może zostać odrzucone także wtedy, gdy końcowy skan byłby mniejszy. Dzienne limity projektu i użytkownika uzupełniają kontrolę, lecz Google opisuje limity niestandardowe jako przybliżone, a nie absolutną gwarancję wydatków.
Jak późne uzupełnienia GA4 trafiają do tabeli wynikowej?
GA4 może aktualizować tabele dzienne do trzech dni po dacie zdarzenia. Dzienny proces może odbudowywać cztery zakończone daty przed bieżącą datą w strefie czasowej usługi. Najstarszy dzień zostaje wtedy ponownie odczytany po pełnym trzydniowym oknie aktualizacji. To nie jest samo dopisywanie wczoraj ani liczenie dzisiaj jako jednego z czterech dni.
Przed zastąpieniem wyników proces musi sprawdzić dostępność wszystkich oczekiwanych tabel źródłowych i pomyślnie odczytać dane zastępcze. Brak tabeli nie dowodzi zera zdarzeń. Tabela pośrednia przechowuje dane zastępcze przed zmianą tabeli docelowej. Transakcja zatwierdza usunięcie i wstawienie razem albo, w razie błędu, nie zachowuje żadnej z tych zmian. Tabela pośrednia, a następnie transakcja obejmująca DELETE i INSERT dla wybranego okresu zapobiega pozostawieniu pustego celu po błędzie wstawiania. Odpowiednio ograniczony MERGE również potrzebuje reguły dla wierszy docelowych, które zniknęły ze źródła.
Istnienie tabeli nie dowodzi kompletności eksportu. Opóźnienia eksportu, historyczne poprawki i usunięcia wymagają monitorowania oraz naprawy poza ruchomym oknem. Odświeżenia nie powinny też wykonywać się równolegle. Partycjonowanie ani filtr sufiksu nie zapewniają automatycznie tych kontroli poprawności.
Źródła
- Cennik BigQuery
- Dokumentacja programistyczna Google Analytics 4
- Wprowadzenie do tabel klastrowanych
- Google: szacowanie i kontrola kosztów
- Google: zapytania do tabel z wieloznacznikiem
- Google: schemat eksportu GA4 do BigQuery
- Google: pola zagnieżdżone i powtarzane
- Google: obliczenia w zapytaniach
- Google: własne limity zapytań
- Google: zapytania z wieloma instrukcjami
Powiązane artykuły