English
 Deutsch
 Polski
Sitemap-Strukturen an 24 Seiten gemessen: Index, Aufteilung, Erweiterungen und Verstöße

Management Summary
Sitemaps sind Adresslisten, mit denen Websites Suchmaschinen auf Inhalte hinweisen. Große Angebote teilen diese Listen auf und ergänzen Angaben zu Sprachen, Bildern oder Videos. Eine Stichprobe von 24 Domains zeigt unterschiedliche Bauformen und Fehler, die die Verarbeitung erschweren können. Viele Sprachverweise können Dateien bereits vor Erreichen der zulässigen Adresszahl zu groß machen. Klare Aufteilung und verlässliche Angaben erleichtern die Pflege; Auswirkungen auf Suchplatzierungen wurden nicht gemessen.
Inhalt
- So wurde gemessen
- Sechs Domains ohne lesbare Sitemap
- robots.txt als Inhaltsverzeichnis
- Fünf Bauformen
- Die Grenze, die zuerst erreicht wird
- Regelverstöße und weitere Auffälligkeiten
- lastmod: ein Datum für alles
- Die Ortsregel und das XSD
- Eine Sitemap vor dem Veröffentlichen prüfen
- Einordnung und Grenzen
- Fragen und Antworten
- Quellen
Eine Sitemap nennt Suchmaschinen die Adressen einer Website. Bei größeren Angeboten verteilt ein Index diese Liste auf mehrere Dateien. Zusätzliche Angaben beschreiben Bilder, Videos, Nachrichten oder Sprachfassungen. Ein Fehler in diesen Dateien muss auf der Website selbst nicht sichtbar sein, kann aber die Verarbeitung durch Suchmaschinen erschweren.
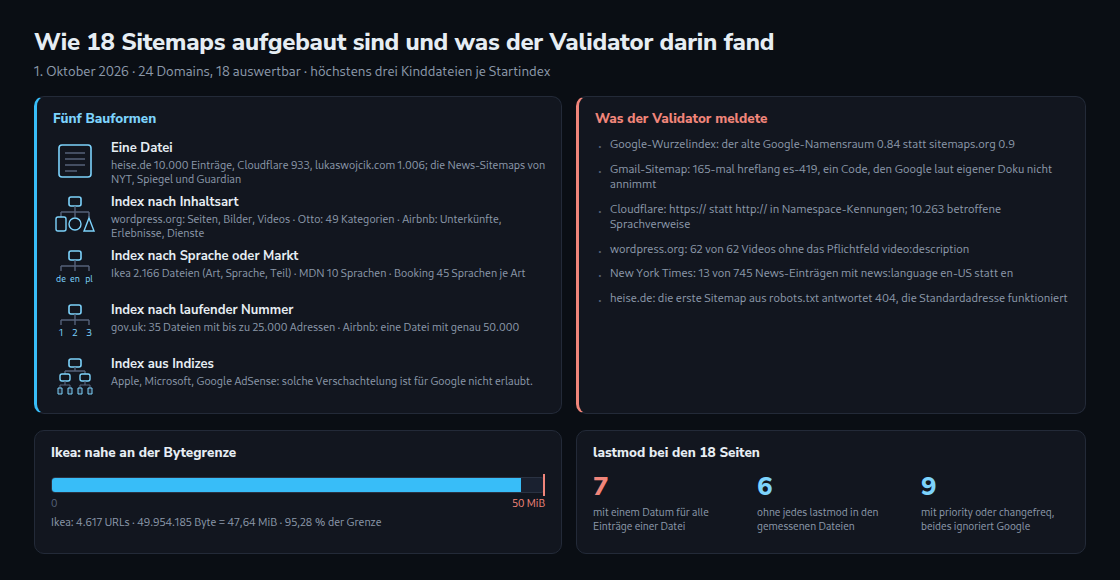
Am 1. Oktober 2026 wurden 24 Domains mit dem Prüfkern des Sitemap Checker & Validator untersucht. Die Auswahl umfasste unter anderem Nachrichtenseiten, Verwaltung, Handel, Reiseangebote und die eigene Website. Die folgenden Zahlen beschreiben diese historische Stichprobe, keinen aktuellen Volltest aller Websites.
So wurde gemessen
Das Messskript verwendete eine einfache Suchstrategie: zuerst den ersten Sitemap:-Eintrag in robots.txt. Nur ohne solchen Eintrag versuchte das Skript /sitemap.xml und bei fehlgeschlagenem Abruf zusätzlich /sitemap_index.xml. Bei einem Index wurden höchstens drei Kinddateien ausgewählt: die erste, die mittlere und die letzte. Das entspricht nicht der vollständigen Suche eines Crawlers. Gzip-Inhalte wurden entpackt; der Prüfkern lief unter Node auf dem eigenen Server.
Die Messung prüfte die Sitemap-Dateien, nicht die Erreichbarkeit sämtlicher darin genannter Seiten. Der XML-Sitemap-Auditor untersucht dafür eine begrenzte Auswahl von Zieladressen. Beide Prüfungen beantworten unterschiedliche Fragen: Ist die Liste korrekt aufgebaut, und liefern ausgewählte Ziele brauchbare Antworten?
Sechs Domains ohne lesbare Sitemap
Das erhaltene Protokoll enthält zunächst 17 lesbare Startdateien, sechs Antworten mit 404 und eine mit 403. Eine zusätzlich gespeicherte Heise-Datei erweitert den auswertbaren Bestand auf 18 Domains. Für die übrigen sechs bleiben fünf 404-Antworten und eine 403-Ablehnung. Das bedeutet nur, dass die gewählte Suche damals keine lesbare Datei lieferte; eine Sitemap an anderer Stelle ist damit nicht ausgeschlossen.
Bei heise.de führte der erste von sieben Einträgen in robots.txt damals auf /sitemapindex.xml mit Status 404. Separat wurde unter /sitemap.xml eine Datei mit 10.000 Einträgen gespeichert. Weitere robots.txt-Einträge nennen andere Teilbereiche. Alle Einträge zu lesen erweitert die Suche, garantiert aber weder dieselbe Abdeckung noch einen erfolgreichen Abruf jeder Datei.
robots.txt als Inhaltsverzeichnis
Mehrere Sitemap:-Zeilen in robots.txt sind erlaubt. Große Websites können damit verschiedene Listen direkt bekannt machen, ohne einen gemeinsamen Index davorzusetzen. Die Tabelle zählt die Einträge im gespeicherten Messprotokoll.
| Domain | Sitemap:-Zeilen |
|---|---|
| booking.com | 434 |
| nytimes.com | 25 |
| microsoft.com | 22 |
| otto.de | 19 |
| bbc.co.uk | 13 |
| wordpress.org | 9 |
| heise.de | 7 |
| zwölf weitere | 1 bis 5 |
Ein Eintrag in robots.txt kann auch eine Sitemap auf einem anderen Host bestätigen. Dieses Verfahren beschreibt sitemaps.org ausdrücklich. Google erlaubt außerdem die gemeinsame Einreichung für Websites, deren Inhaberschaft in der Search Console bestätigt ist. Ohne Kenntnis dieser Einrichtung beweist ein anderer Host allein deshalb keinen Fehler.
Fünf Bauformen
Die auswertbaren Dateien zeigen fünf wiederkehrende Aufteilungen. Die Beispiele beschreiben nur die tatsächlich betrachteten Dateien; eine Domain kann weitere Formen parallel einsetzen.
| Bauform | Beispiele aus der Messung |
|---|---|
| eine Datei | heise.de (10.000 Einträge), lukaswojcik.com (1.006), Cloudflare (933); die News-Sitemaps von New York Times, Spiegel und Guardian, die ihre robots.txt jeweils zuerst nennt |
| Index nach Inhaltsart | wordpress.org (Seiten, Bilder, Videos), Otto (49 Kategorien), Airbnb (Unterkünfte und weitere Inhaltsarten) |
| Index nach Sprache oder Markt | Ikea mit 2.166 Dateien nach dem Muster prod-et-EE_1.xml, MDN mit zehn Sprachen, Booking mit 45 Sprachen je Inhaltsart, Shopify mit 568 Dateien |
| Index nach laufender Nummer | gov.uk mit 35 Dateien zu je bis zu 25.000 Adressen, Airbnb mit mehreren Dateien für Unterkünfte |
| Index aus Indizes | Apple (47 Verweise, darunter apple.com.cn), Microsoft (fünf Verweise), Google: geprüfte Kinddateien enthalten weitere Indizes |
Ein Index aus weiteren Indizes ist für Google ausdrücklich ein Fehler: Die Search-Console-Hilfe verlangt direkte Verweise auf Sitemap-Dateien. Das ist mehr als eine fehlende Zusage in der Anleitung. Bei Apples Verweis auf einen zweiten Host kommt eine andere Frage hinzu: Eine dafür eingerichtete gemeinsame Einreichung war nicht Teil dieser Messung und kann von außen nicht vorausgesetzt oder ausgeschlossen werden.
Die Grenze, die zuerst erreicht wird
Die beiden Grenzen gelten gleichzeitig: höchstens 50.000 Adressen und höchstens 52.428.800 Byte unkomprimierter Inhalt. Das Protokoll nennt diese Bytegrenze „50 MB“; technisch entspricht das 50 MiB. Die geprüften gov.uk-Dateien enthielten bis zu 25.000 Adressen, eine Airbnb-Datei genau 50.000.
Die gespeicherte Ikea-Datei prod-et-EE_1.xml enthält 4.617 Adressen und 49.954.185 Byte: rund 47,64 MiB und 95,28 Prozent der Bytegrenze. Gezählt wurden außerdem 319.635 Sprachverweise, 22.797 Bilder und 1.585 Videos. Im Mittel sind das etwa 69 Sprachverweise und 10,8 kB Gesamtdateigröße je Adresse. Der letzte Wert umfasst den ganzen XML-Anteil, nicht nur Beschreibungen.
hreflang verknüpft verschiedene Sprachfassungen derselben Seite. Bei drei Fassungen nennt jede Fassung alle drei Ziele: zusammen neun Verweise. Bei zehn Fassungen sind es hundert. Für M Inhaltsgruppen mit jeweils L Fassungen ergibt das M × L² Verweise. Die Größe wächst also mit der Zahl der Inhaltsgruppen und mit dem Quadrat der Fassungen. Beim Aufteilen müssen deshalb sowohl URL-Zahl als auch tatsächliche Bytezahl geprüft werden.
Regelverstöße und weitere Auffälligkeiten
Der Validator meldete unterschiedliche Arten von Auffälligkeiten. Doppelte Adressen, URL-Fragmente und leere Dateien brauchen eine andere Bewertung als fehlende Pflichtfelder oder ein falscher XML-Namensraum. Die gespeicherte Heise-Datei enthält beispielsweise drei Adressen mit Fragment und 16 wiederholte Adressen. Die folgende Liste trennt konkrete Regelabweichungen von bloßen Prüfhinweisen.
- Google-Wurzelindex: Das Protokoll meldet den alten Namensraum
http://www.google.com/schemas/sitemap/0.84statthttp://www.sitemaps.org/schemas/sitemap/0.9. Ein auf Version 0.9 ausgelegter strenger Prüfer erkennt diesen Index nicht als passendes Dokument. - Gmail-Sitemap: Unter 9.075 Sprachverweisen für 166 URLs wurden 165 Angaben
es-419gefunden. Google nennt diesen regionalen Code ausdrücklich als nicht unterstützt. Das ist eine Grenze von Googles hreflang-Verarbeitung, keine Behauptung, dass der Sprachcode allgemein ungültig sei. - Cloudflare: Die Sitemap- und XHTML-Namensräume beginnen mit
https://statt dem vorgeschriebenenhttp://. Bei Namensräumen sind das unterschiedliche Kennungen. Die 10.263 entsprechend markierten Sprachverweise passen deshalb nicht zum erwarteten XHTML-Namensraum; das beweist nicht, wie jeder mögliche Parser damit umgeht. - wordpress.org: Das Messprotokoll meldet bei allen 62 Videos ein fehlendes
video:description, das Google verlangt. In der Bilddatei wiederholen 521 von 693 Einträgen eine bereits genannte URL. Das ist vermeidbare Wiederholung: Ein URL-Eintrag darf bis zu 1.000 Bilder enthalten. Wiederholung allein macht die XML-Datei jedoch nicht ungültig. - New York Times: Bei 13 von 745 News-Einträgen steht
news:languageaufen-US. Google verlangt hier den zwei- oder dreibuchstabigen Sprachcode, für Englisch alsoen; die dokumentierten Sonderfälle sindzh-cnundzh-tw. - BBC: Der Index nennt drei Dateien zu Wahlen von 2014. Eine geprüfte Datei enthält 204 HTTP-Adressen. Weder das Alter des Themas noch HTTP allein ist ein Sitemap-Formatfehler. Ob die Ziele inzwischen weiterleiten oder veraltet sind, wurde in dieser Dateiprüfung nicht ermittelt.
Die Liste belegt keine gemeinsame Fehlerklasse für alle Fälle. Ein falscher Namensraum oder ein fehlendes Pflichtfeld widerspricht einer Formatregel; ein alter HTTP-Link oder eine Wiederholung allein nicht. Aus den Dateien lässt sich außerdem nicht ablesen, welche Seiten Google tatsächlich indexiert oder wegen eines bestimmten Befunds auslässt.
lastmod: ein Datum für alles
Von den drei optionalen Kernfeldern lastmod, priority und changefreq verwendet Google nach eigener Dokumentation nur lastmod, sofern die Angaben zuverlässig sind. priority und changefreq erscheinen trotzdem in Teilen der Stichprobe. Ein vorhandenes Feld beweist daher noch keinen Nutzen für Google.
Gleiche Änderungsdaten sind ein Anlass zur Prüfung, kein Beweis für falsche Daten. Cloudflare hatte bei 933 Einträgen dasselbe Datum; die große Ikea-Datei bei 4.617 und die geprüften Booking-Sprachdateien jeweils bei 3.032. Ein Generatorlauf könnte die Ursache sein, ebenso eine gemeinsame tatsächliche Änderung. Umgekehrt beweisen viele unterschiedliche Werte keine Genauigkeit. Dafür wäre ein Abgleich mit den Änderungen der jeweiligen Seiten nötig. Fehlendes lastmod ist erlaubt.
Im historischen Vergleich der eigenen Website nannte der Yoast-Index für post-sitemap.xml den 28. September, während ein Eintrag der Kinddatei den 1. Oktober trug. Das deutet auf nicht zusammenpassende Zeitangaben hin. Das Indexdatum soll die Änderung der Sitemap-Datei beschreiben; das Datum im URL-Eintrag betrifft die einzelne Seite. Ein belastbarer Abgleich braucht beide Dateien und möglichst die tatsächlichen Änderungszeiten.
Die Ortsregel und das XSD
Bei der Ortsregel hängt die Bewertung auch von der Einreichung ab. Ohne besondere Einreichung gilt eine Sitemap unter /sitemaps/sitemap.xml für darunterliegende Pfade. In der Stichprobe enthielten zahlreiche solche Dateien auch URLs außerhalb dieses Bereichs. Google erlaubt einen größeren Bereich bei Einreichung über die Search Console. Da diese Einrichtung nicht geprüft wurde, sind die Funde Hinweise auf Klärungsbedarf und kein Beweis, dass fast alle großen Websites gegen die Regeln verstoßen.
Ein XSD ist eine maschinenlesbare Beschreibung der erlaubten XML-Struktur. Das Basisschema von sitemaps.org verlangt für fremde Erweiterungen mit processContents="strict" eine bekannte Deklaration. Ohne zusätzlich geladenes Bildschema scheitert deshalb auch ein ansonsten korrektes image:image. Das wurde mit libxml2 2.9.14 isoliert bestätigt. Ein zweiter Test zeigt unterschiedliche Datumsregeln: Das XSD lehnt 2026-10-01T14:05 ab, akzeptiert aber 2026-10-01T14:05:00. Das verlinkte W3C-Datumsprofil verlangt bei Uhrzeiten eine Zeitzone. Ein Datum oder eine Uhrzeit mit Sekunden und Zeitzone vermeidet diesen Unterschied.
Eine Sitemap vor dem Veröffentlichen prüfen
Der Sitemap Checker & Validator prüft eingefügtes XML oder eine Datei im Browser. Bei Gzip-Dateien braucht der Browser die verwendete Entpackfunktion. Das Werkzeug prüft ausgewählte Struktur- und Inhaltsregeln; eine grüne Meldung ersetzt keine vollständige Prüfung aller Suchmaschinenregeln. Zum Prüfumfang gehören:
- XML-Syntaxfehler wie ein ungeschütztes & oder ein abgebrochenes Dateiende, mit Fundstellenangabe,
- erwartete Namensräume, Kodierungsangaben sowie URL-Zahl und Dateigröße,
- Grundfelder wie loc und lastmod sowie die im XSD vorgesehene Reihenfolge,
- hreflang-Codes und Verknüpfungen zwischen den in derselben Datei enthaltenen URLs,
- ausgewählte Pflichtfelder und Grenzen für Bilder, Videos und News,
- die Ortsregel, wenn die Adresse der Sitemap angegeben ist.
Der lokale Dateiprüfer lädt den eingegebenen XML-Inhalt nicht zur Prüfung hoch. Der XML-Sitemap-Auditor arbeitet dagegen mit veröffentlichten URLs und ruft eine begrenzte Auswahl ab. Dessen Prüfung von HTML-noindex und Canonical ist nicht vollständig: Die Erkennung hängt teilweise von der Attributreihenfolge ab, und X-Robots-Tag wird nicht berücksichtigt. Eine unauffällige Ausgabe garantiert deshalb weder Indexierbarkeit noch korrekte Angaben auf jeder Seite.
Einordnung und Grenzen
Die Auswahl umfasst 24 Domains an einem Tag und höchstens drei Dateien je Startindex. Bei Ikea wurden damit nur drei von 2.166 Dateien betrachtet. Die Ergebnisse sind keine Zufallsstichprobe und nicht repräsentativ für alle Sitemaps. Nach dem zusätzlichen Heise-Abruf blieben sechs Domains ohne auswertbare Datei. Auch ein 403 für den Testclient beweist nicht, dass Googlebot denselben Status erhält. Folgen für Suchergebnisse wurden nicht gemessen.
Fragen und Antworten
Warum fällt eine korrekte Bild-Sitemap bei der Prüfung gegen das XSD von sitemaps.org durch?
Das Basisschema kennt die Struktur von Bild-, Video- oder anderen Erweiterungen nicht automatisch. Mit strenger Erweiterungsprüfung muss der Validator die passenden Schemata zusätzlich kennen. Andernfalls kann ein Fehler nur die fehlende Schemadeklaration betreffen, nicht den eigentlichen Bildinhalt. Alternativ können Erweiterungen anhand ihrer dokumentierten Regeln geprüft werden. Schemaerfolg und Eignung für Google sind trotzdem verschiedene Prüfziele.
Gehört hreflang besser in die Sitemap oder in den Kopf der Seite?
Google unterstützt Sprachverweise im HTML-Kopf, in HTTP-Headern und in Sitemaps. Keine dieser Methoden erhält allein wegen des Ablageorts einen Vorteil. Entscheidend sind vollständige und widerspruchsfreie Angaben.
Bei drei Sprachfassungen enthält jede Fassung drei Verweise, insgesamt neun. Diese Wiederholung entsteht sowohl über alle HTML-Seiten als auch über alle Sitemap-Einträge. Eine Sitemap bündelt die Angaben in Dateien; HTML verteilt die Angaben auf die Seiten. Bei großen Sprachgruppen kann die Sitemap deshalb die Bytegrenze früh erreichen. Die Ikea-Datei lag trotz nur 4.617 URLs bereits bei 95,28 Prozent.
Die passende Ablage hängt davon ab, wo die Sprachzuordnung zuverlässig gepflegt werden kann. Eine Sitemap hält zusätzliche Verweise aus den HTML-Seiten heraus; der HTML-Kopf lässt die Angaben zusammen mit jeder Seite erzeugen. Viele Sprachen allein entscheiden nicht über die bessere Methode. Zwei parallel gepflegte Listen erhöhen den Abstimmungsaufwand und können auseinanderlaufen.
Wie lässt sich eine Sitemap mit mehr als 50.000 Adressen sauber aufteilen?
Ein Sitemap-Index verweist auf mehrere kleinere Dateien. Vier praktische Regeln helfen:
- Kinddateien liegen im Ordner des Index oder darunter. Abweichende Hosts benötigen eine passende gemeinsame Einreichung.
- Stabile Gruppen, etwa Inhaltsart oder Sprache, erleichtern Pflege und Fehlersuche. Eine Nummerierung kann ebenfalls stabil sein; Verschiebungen hängen vom Sortier- und Aufteilungsverfahren ab.
- Das lastmod des Indexeintrags beschreibt die tatsächliche letzte Änderung der Kinddatei. Ein bloßer erneuter Generatorlauf verlangt kein neues Datum, wenn der Inhalt unverändert bleibt.
- Der Index verweist direkt auf Sitemap-Dateien. Google erlaubt keine weiteren Sitemap-Indizes als Kinddateien.
Quellen
- sitemaps.org – Sitemaps XML format
- sitemaps.org – sitemap.xsd
- Google Search Central – Build and submit a sitemap
- Google Search Central – Manage your sitemaps with a sitemap index file
- Google Search Central – Tell Google about localized versions of your page
- Google Search Central – Image sitemaps
- Google Search Central – Video sitemaps and alternatives
- Google Search Central – Create a news sitemap
- W3C – Date and Time Formats
- Google Search Console: sitemap errors
- W3C: Namespaces in XML
Passend dazu