English
 Deutsch
 Polski
Struktury map witryn zmierzone na 24 stronach: indeksy, podział, rozszerzenia i naruszenia

Management Summary
Mapy witryn to listy adresów pomagające wyszukiwarkom odnajdywać treści. Duże serwisy dzielą listy na pliki i dodają informacje o językach, obrazach lub filmach. Próba obejmująca 24 domeny pokazuje różne sposoby organizacji oraz błędy utrudniające przetwarzanie. Liczne odwołania językowe mogą nadmiernie powiększyć plik jeszcze przed osiągnięciem limitu adresów. Przejrzysty podział i rzetelne dane ułatwiają utrzymanie map; wpływu na pozycje w wyszukiwarce nie zmierzono.
Spis treści
- Jak przeprowadzono pomiar
- Sześć domen bez czytelnej mapy
- robots.txt jako spis treści
- Pięć sposobów budowy
- Limit osiągany jako pierwszy
- Naruszenia reguł i pozostałe ustalenia
- lastmod: jedna data dla wszystkiego
- Reguła lokalizacji i XSD
- Sprawdzenie mapy przed publikacją
- Kontekst i ograniczenia
- Pytania i odpowiedzi
- Źródła
Mapa witryny podaje wyszukiwarkom adresy stron. W większym serwisie indeks rozdziela tę listę na kilka plików. Dodatkowe pola opisują obrazy, filmy, wiadomości i wersje językowe. Błąd w tych plikach może być niewidoczny na samej stronie, a mimo to utrudniać przetwarzanie przez wyszukiwarki.
1 października 2026 sprawdzono 24 domeny rdzeniem narzędzia Sitemap Checker & Validator. Wybór obejmował między innymi serwisy informacyjne, administrację, handel, podróże i tę witrynę. Poniższe liczby opisują historyczną próbę, nie aktualny pełny audyt wszystkich serwisów.
Jak przeprowadzono pomiar
Skrypt stosował prosty sposób wyszukiwania: najpierw pierwszy wpis Sitemap: w robots.txt. Tylko przy braku takiego wpisu sprawdzał /sitemap.xml, a po nieudanym pobraniu także /sitemap_index.xml. Dla indeksu wybierano najwyżej trzy pliki podrzędne: pierwszy, środkowy i ostatni. Nie jest to pełny proces odkrywania adresów przez crawler. Treść gzip rozpakowywano, a rdzeń sprawdzający działał pod Node na własnym serwerze.
Pomiar dotyczył plików map, a nie dostępności wszystkich wymienionych stron. Narzędzie Audytor map witryn XML sprawdza w tym celu ograniczony wybór adresów docelowych. Są to różne pytania: czy lista ma poprawną strukturę oraz czy wybrane cele zwracają użyteczne odpowiedzi?
Sześć domen bez czytelnej mapy
Zachowany dziennik zawiera początkowo 17 czytelnych plików startowych, sześć odpowiedzi 404 i jedną 403. Osobno zapisany plik Heise zwiększa zbiór do 18 domen. W pozostałej szóstce zostaje pięć odpowiedzi 404 i jedna odmowa 403. Oznacza to wyłącznie, że wybrana metoda nie znalazła wtedy czytelnego pliku. Mapa pod innym adresem nadal mogła istnieć.
W heise.de pierwszy z siedmiu wpisów robots.txt wskazywał /sitemapindex.xml z odpowiedzią 404. Osobne pobranie spod /sitemap.xml zapisało plik z 10 000 wpisów. Pozostałe wpisy robots.txt dotyczyły innych części serwisu. Odczytanie wszystkich wpisów poszerza wyszukiwanie, ale nie gwarantuje identycznego zakresu ani poprawnego pobrania każdego pliku.
robots.txt jako spis treści
Wiele wierszy Sitemap: w robots.txt jest dozwolonych. Duże serwisy mogą bezpośrednio ogłaszać kilka list bez wspólnego indeksu. Tabela podaje liczby wpisów z zachowanego dziennika pomiarowego.
| Domena | Wiersze Sitemap: |
|---|---|
| booking.com | 434 |
| nytimes.com | 25 |
| microsoft.com | 22 |
| otto.de | 19 |
| bbc.co.uk | 13 |
| wordpress.org | 9 |
| heise.de | 7 |
| dwanaście kolejnych | od 1 do 5 |
Wpis w robots.txt może również potwierdzać mapę umieszczoną na innym hoście. Protokół sitemaps.org opisuje tę metodę wprost. Google pozwala ponadto wspólnie zgłaszać witryny ze zweryfikowaną własnością w Search Console. Bez znajomości tej konfiguracji sam inny host nie dowodzi więc błędu.
Pięć sposobów budowy
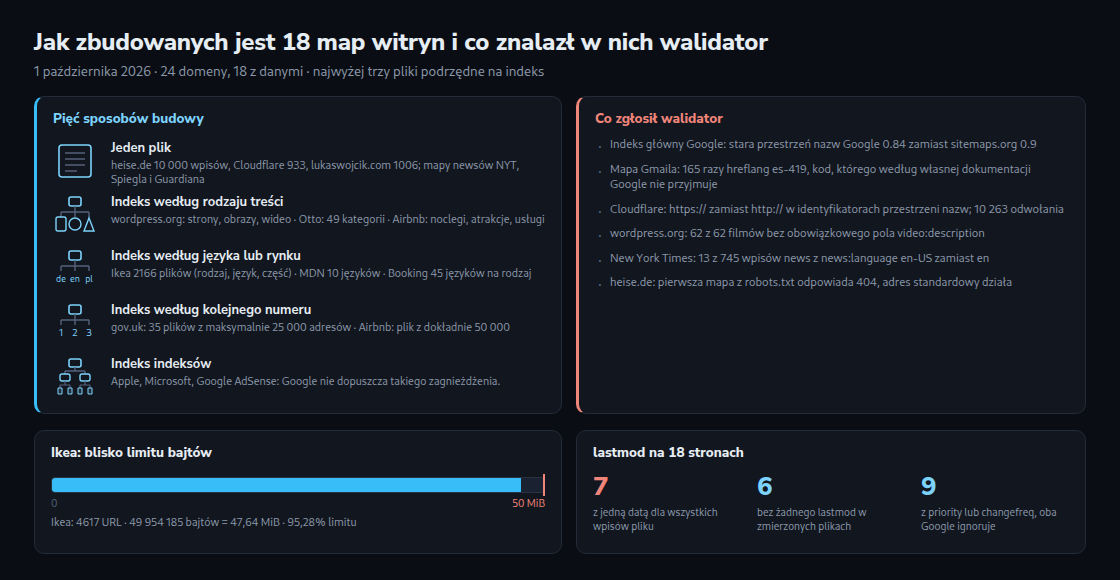
Dostępne pliki pokazują pięć powtarzających się sposobów podziału. Przykłady opisują wyłącznie sprawdzone pliki; domena może równolegle stosować inne struktury.
| Forma | Przykłady z pomiaru |
|---|---|
| jeden plik | heise.de (10 000 wpisów), lukaswojcik.com (1006), Cloudflare (933); mapy newsów New York Timesa, Spiegla i Guardiana, każda wymieniona jako pierwsza w ich robots.txt |
| indeks według rodzaju treści | wordpress.org (strony, obrazy, wideo), Otto (49 kategorii), Airbnb (noclegi i inne rodzaje treści) |
| indeks według języka lub rynku | Ikea z 2166 plikami według wzoru prod-et-EE_1.xml, MDN z dziesięcioma językami, Booking z 45 językami na rodzaj treści, Shopify z 568 plikami |
| indeks według kolejnego numeru | gov.uk z 35 plikami po maksymalnie 25 000 adresów, Airbnb z wieloma plikami noclegów |
| indeks indeksów | Apple (47 odwołań, w tym apple.com.cn), Microsoft (pięć odwołań), Google: sprawdzone pliki podrzędne zawierają kolejne indeksy |
Indeks zawierający kolejne indeksy jest dla Google wprost błędem: pomoc Search Console wymaga bezpośrednich odwołań do plików map. To mocniejsze stwierdzenie niż brak obietnicy w głównym przewodniku. Odwołanie Apple do drugiego hosta rodzi osobne pytanie: konfiguracja wspólnego zgłoszenia nie była częścią pomiaru i nie da się zakładać ani wykluczyć takiej konfiguracji na podstawie samych plików.
Limit osiągany jako pierwszy
Oba limity obowiązują jednocześnie: najwyżej 50 000 adresów oraz 52 428 800 bajtów bez kompresji. Protokół nazywa ten rozmiar „50 MB”; technicznie jest to 50 MiB. Sprawdzone pliki gov.uk zawierały do 25 000 adresów, a jeden plik Airbnb dokładnie 50 000.
Zapisany plik Ikei prod-et-EE_1.xml zawiera 4617 adresów i 49 954 185 bajtów: około 47,64 MiB oraz 95,28 procent limitu. Naliczono też 319 635 odwołań językowych, 22 797 obrazów i 1585 filmów. Średnio daje to około 69 odwołań językowych i 10,8 kB całkowitego rozmiaru na adres. Ostatnia wartość obejmuje całość XML przypadającą na wpis, nie tylko opisy.
hreflang łączy wersje językowe tej samej strony. Przy trzech wersjach każda wymienia wszystkie trzy cele, czyli łącznie powstaje dziewięć odwołań. Przy dziesięciu wersjach jest ich sto. Dla M grup treści po L wersji daje to M × L² odwołań. Rozmiar rośnie zatem z liczbą grup treści oraz z kwadratem liczby wersji. Podział wymaga kontroli zarówno liczby adresów, jak i rzeczywistych bajtów.
Naruszenia reguł i pozostałe ustalenia
Walidator zgłosił różne rodzaje ustaleń. Powtórzone adresy, fragmenty URL i puste pliki wymagają innej oceny niż brak pola obowiązkowego lub błędna przestrzeń nazw XML. Zapisany plik Heise zawiera na przykład trzy adresy z fragmentem i 16 powtórzeń adresów. Poniższa lista oddziela konkretne naruszenia reguł od wskazówek wymagających sprawdzenia.
- Indeks główny Google: Dziennik podaje starą przestrzeń nazw
http://www.google.com/schemas/sitemap/0.84zamiasthttp://www.sitemaps.org/schemas/sitemap/0.9. Ścisły walidator przeznaczony dla wersji 0.9 nie rozpoznaje takiego indeksu jako oczekiwanego dokumentu. - Mapa Gmaila: Wśród 9075 odwołań językowych dla 166 adresów znaleziono 165 wartości
es-419. Google wprost wymienia ten kod regionalny jako nieobsługiwany. Jest to ograniczenie przetwarzania hreflang przez Google, nie stwierdzenie ogólnej niepoprawności kodu językowego. - Cloudflare: Przestrzenie nazw mapy i XHTML zaczynają się od
https://zamiast wymaganegohttp://. Są to różne identyfikatory przestrzeni nazw. 10 263 tak oznaczone odwołania językowe nie pasują więc do oczekiwanej przestrzeni XHTML. Nie dowodzi to sposobu obsługi przez każdy możliwy parser. - wordpress.org: Dziennik pomiaru zgłasza brak wymaganego przez Google
video:descriptionprzy wszystkich 62 filmach. W pliku obrazów 521 z 693 wpisów powtarza wcześniej podany adres. Można ograniczyć te powtórzenia: jeden wpis URL może zawierać do 1000 obrazów. Samo powtórzenie nie czyni jednak XML niepoprawnym. - New York Times: W 13 z 745 wpisów news
news:languagema wartośćen-US. Google wymaga tu dwu- lub trzyliterowego kodu języka, czyli dla angielskiegoen. Udokumentowane wyjątki tozh-cnizh-tw. - BBC: Indeks wymienia trzy pliki dotyczące wyborów z 2014 roku. Jeden sprawdzony plik zawiera 204 adresy HTTP. Ani wiek tematu, ani samo HTTP nie jest błędem formatu mapy. W tej kontroli plików nie ustalano, czy cele obecnie przekierowują lub są nieaktualne.
Te ustalenia nie tworzą jednej wspólnej kategorii błędów. Błędna przestrzeń nazw albo brak pola obowiązkowego narusza regułę formatu. Sam stary link HTTP lub powtórzony adres nie wystarcza do takiej oceny. Pliki nie pokazują też, które strony Google rzeczywiście indeksuje lub pomija z powodu konkretnego problemu.
lastmod: jedna data dla wszystkiego
Z trzech opcjonalnych pól podstawowych lastmod, priority i changefreq Google według dokumentacji wykorzystuje tylko lastmod, jeśli dane są wiarygodne. Pozostałe dwa pola nadal występują w części próby. Sama obecność pola nie dowodzi więc korzyści dla Google.
Identyczne daty zmian są powodem do kontroli, nie dowodem błędnych danych. Cloudflare miało jedną datę przy 933 wpisach, duży plik Ikei przy 4617, a sprawdzone pliki językowe Booking po 3032. Przyczyną mógł być przebieg generatora albo rzeczywista wspólna zmiana. Wiele różnych dat także nie potwierdza dokładności. Potrzebne byłoby porównanie z faktycznymi zmianami stron. Brak lastmod jest dozwolony.
W historycznym porównaniu tej witryny indeks Yoast podawał 28 września dla post-sitemap.xml, a wpis w pliku podrzędnym miał datę 1 października. Wskazuje to na możliwą niespójność czasów. Data w indeksie powinna opisywać zmianę pliku mapy; data przy adresie dotyczy pojedynczej strony. Wiarygodne porównanie wymaga obu plików i najlepiej rzeczywistych czasów zmian.
Reguła lokalizacji i XSD
Ocena reguły lokalizacji zależy także od zgłoszenia. Bez szczególnego zgłoszenia mapa pod /sitemaps/sitemap.xml dotyczy ścieżek poniżej tego katalogu. Wiele badanych plików wymieniało również adresy spoza tego zakresu. Google dopuszcza szerszy zakres po zgłoszeniu przez Search Console. Tej konfiguracji nie sprawdzono, więc ustalenia wymagają wyjaśnienia, zamiast dowodzić naruszeń przez niemal wszystkie duże serwisy.
XSD to maszynowo czytelny opis dozwolonej struktury XML. Podstawowy schemat sitemaps.org przez processContents="strict" wymaga znanej deklaracji dla obcych rozszerzeń. Bez dodatkowego schematu obrazów nawet poprawne image:image nie przechodzi kontroli. Potwierdził to izolowany test libxml2 2.9.14. Drugi test pokazał różnice reguł czasu: XSD odrzuca 2026-10-01T14:05, ale przyjmuje 2026-10-01T14:05:00. Podlinkowany profil dat W3C wymaga strefy czasowej przy podanej godzinie. Sama data albo czas z sekundami i strefą omija tę różnicę.
Sprawdzenie mapy przed publikacją
Sitemap Checker & Validator bada wklejony XML lub plik w przeglądarce. Pliki gzip wymagają używanej przez narzędzie funkcji rozpakowywania w przeglądarce. Sprawdzane są wybrane reguły struktury i treści; zielony wynik nie zastępuje pełnego audytu według wszystkich zasad wyszukiwarek. Zakres obejmuje:
- błędy składni XML, takie jak niezabezpieczony & lub urwany plik, ze wskazaniem miejsca,
- oczekiwane przestrzenie nazw, deklaracje kodowania, liczbę adresów i rozmiar pliku,
- pola podstawowe takie jak loc i lastmod oraz kolejność przewidzianą przez XSD,
- kody hreflang i powiązania między adresami z tego samego pliku,
- wybrane pola obowiązkowe i limity dla obrazów, filmów i newsów,
- regułę lokalizacji po podaniu adresu mapy.
Lokalny walidator nie wysyła podanego XML na serwer w celu sprawdzenia. Audytor map witryn XML pobiera natomiast ograniczony wybór publicznych adresów. Wykrywanie HTML-noindex i canonical jest niepełne: częściowo zależy od kolejności atrybutów, a X-Robots-Tag nie jest sprawdzany. Brak ostrzeżenia nie gwarantuje więc możliwości indeksowania ani poprawnych oznaczeń każdej strony.
Kontekst i ograniczenia
Wybór obejmuje 24 domeny jednego dnia i najwyżej trzy pliki podrzędne na indeks startowy. W Ikei oznacza to tylko trzy z 2166 plików. Nie jest to losowa próba ani reprezentacja wszystkich map witryn. Po dodatkowym pobraniu Heise sześć domen pozostało bez użytecznego pliku. Kod 403 dla klienta testowego nie dowodzi też takiej samej odpowiedzi dla Googlebota. Nie mierzono skutków w wynikach wyszukiwania.
Pytania i odpowiedzi
Dlaczego poprawna mapa obrazów nie przechodzi walidacji względem XSD z sitemaps.org?
Podstawowy schemat nie zna automatycznie struktury rozszerzeń obrazów, wideo i innych dodatków. Ścisła kontrola wymaga także odpowiednich schematów rozszerzeń. W przeciwnym razie błąd może dotyczyć tylko brakującej deklaracji schematu, a nie treści obrazu. Rozszerzenia można również sprawdzać według udokumentowanych zasad. Zgodność ze schematem i przydatność dla Google pozostają osobnymi pytaniami.
Czy hreflang lepiej umieścić w mapie witryny, czy w nagłówku strony?
Google obsługuje odwołania językowe w nagłówku HTML, nagłówkach HTTP i mapach witryn. Żadna metoda nie otrzymuje przewagi wyłącznie z powodu miejsca zapisu. Liczą się pełne i spójne oznaczenia.
Przy trzech wersjach językowych każda zawiera trzy odwołania, łącznie dziewięć. Powtórzenie występuje zarówno we wszystkich stronach HTML, jak i we wszystkich wpisach mapy. Mapa zbiera oznaczenia w plikach, a HTML rozdziela je między strony. Duże grupy językowe mogą więc szybko zbliżyć mapę do limitu bajtów. Plik Ikei osiągnął już 95,28 procent przy tylko 4617 adresach.
Wybór miejsca zależy od sposobu rzetelnego utrzymywania powiązań językowych. Mapa usuwa dodatkowe odwołania z HTML stron; nagłówek HTML pozwala generować oznaczenia razem z każdą stroną. Sama duża liczba języków nie rozstrzyga o lepszej metodzie. Dwie równolegle utrzymywane listy wymagają dodatkowej synchronizacji i mogą stać się niespójne.
Jak czysto podzielić mapę witryny z ponad 50 000 adresów?
Indeks map wskazuje kilka mniejszych plików. Pomagają cztery praktyczne zasady:
- Pliki podrzędne powinny znajdować się w katalogu indeksu lub niżej. Inne hosty wymagają odpowiedniej konfiguracji wspólnego zgłoszenia.
- Stałe grupy, na przykład rodzaj treści lub język, ułatwiają utrzymanie i diagnozę. Numeracja także może być stabilna; przesunięcia zależą od sortowania i sposobu podziału.
- lastmod wpisu indeksu opisuje rzeczywistą ostatnią zmianę pliku podrzędnego. Sam ponowny przebieg generatora nie wymaga nowej daty, jeśli treść pozostaje bez zmian.
- Indeks wskazuje bezpośrednio pliki map. Google nie dopuszcza innych indeksów map jako plików podrzędnych.
Źródła
- sitemaps.org – Sitemaps XML format
- sitemaps.org – sitemap.xsd
- Google Search Central – Build and submit a sitemap
- Google Search Central – Manage your sitemaps with a sitemap index file
- Google Search Central – Tell Google about localized versions of your page
- Google Search Central – Image sitemaps
- Google Search Central – Video sitemaps and alternatives
- Google Search Central – Create a news sitemap
- W3C – Date and Time Formats
- Google Search Console: sitemap errors
- W3C: Namespaces in XML
Powiązane artykuły