English
 Deutsch
 Polski
Reguläre Ausdrücke: Der gierige Punkt, fehlende Anker und verschachtelte Wiederholung

Management Summary
Reguläre Ausdrücke sind kompakte Regeln zum Suchen oder Prüfen von Textmustern, etwa einem geforderten Format in einem Formular. Auf Websites und in der Datenverarbeitung kann eine Regel damit viele mögliche Eingaben beschreiben. Ein Muster kann jedoch nur einen gültigen Ausschnitt erkennen, zu viel Text erfassen oder bei schwierigen Eingaben übermäßig lange arbeiten. Der Beitrag erklärt diese typischen Fallen und die Bedeutung klarer Grenzen, wenn Suchregeln zugleich über zulässige Angaben entscheiden.
Inhalt
Ein regulärer Ausdruck beschreibt ein Textmuster. Die Engine ist das Programm, das dieses Muster auswertet. Schalter verändern einzelne Regeln, etwa die Unterscheidung zwischen Groß- und Kleinschreibung. Zum richtigen Ergebnis gehören neben dem Muster auch Regex-Engine, Schalter und aufgerufene Methode. Eine Teilzeichenfolge zu finden ist eine andere Aufgabe als die vollständige Eingabe zu prüfen.
Ein passendes Beispiel belegt weder korrekte Treffergrenzen noch eine akzeptable Laufzeit. Die folgenden Beispiele verwenden JavaScript, sofern keine andere Sprache genannt ist.
Gierig ist der Quantor
Ein Quantor legt fest, wie oft ein Teil des Musters vorkommen darf. Eine gierige Wiederholung versucht zuerst, möglichst viel passenden Text zu erfassen; eine faule Wiederholung beginnt mit möglichst wenig. Beide können diese Auswahl verändern, damit der restliche Ausdruck passt.
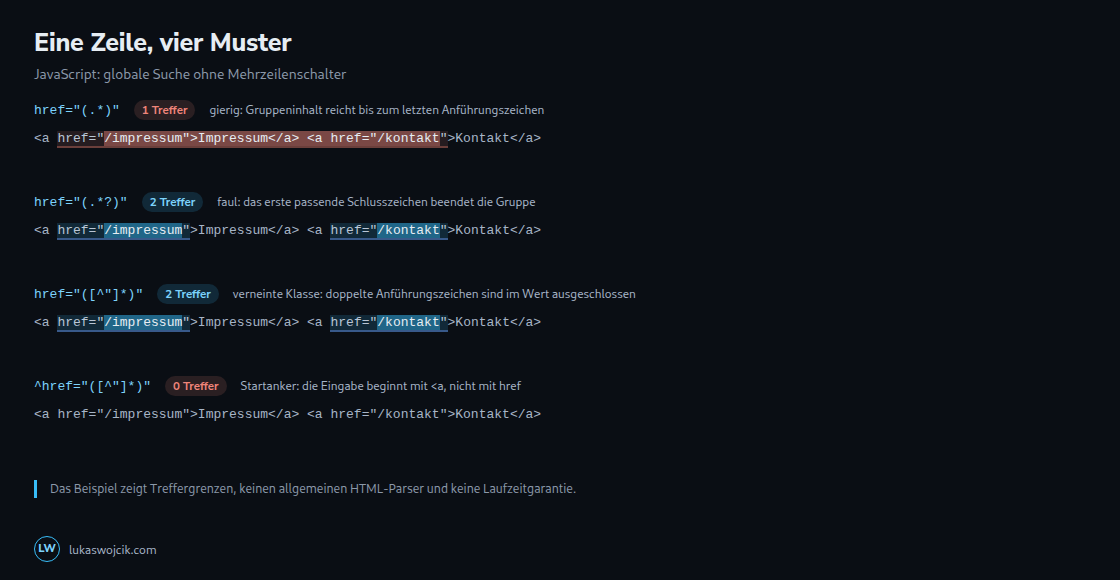
Der Punkt . trifft ein Zeichen; * wiederholt diesen Treffer gierig. In JavaScript bleiben Zeilentrenner ohne den dotAll-Schalter s ausgeschlossen. Ein wörtlicher Punkt wird als \. geschrieben. Bei zwei Verweisen mit doppelten Anführungszeichen kann href="(.*)" vom ersten öffnenden bis zum letzten schließenden Anführungszeichen reichen und das dazwischenliegende HTML einschließen.
href="(.*?)" versucht kürzere Gruppeninhalte zuerst. href="([^"]*)" schließt doppelte Anführungszeichen dagegen ausdrücklich aus dem Wert aus. Im abgebildeten Beispiel entstehen jeweils zwei Treffer, sofern die aufgerufene Methode alle Treffer sucht. Beide Muster ersetzen keinen HTML-Parser: Andere Anführungszeichen, Zeichenreferenzen und Dokumentstruktur erfordern für robuste Auswertung einen passenden Parser.
Eine verneinte Zeichenklasse garantiert nicht allgemein rücksprungfreie Auswertung. Beispielsweise kann [^,]+a ein bereits verbrauchtes Zeichen zurückgeben, damit das abschließende a passt. Im Linkbeispiel ist die ausdrücklich gesetzte Grenze am Anführungszeichen der entscheidende Vorteil.
Der Mehrzeilenschalter begrenzt keine Zeichenklasse
[^&] enthält Zeilenumbrüche, weil diese Zeichen keine Und-Zeichen sind. m verändert Anker, aber nicht die von der Klasse erfassten Zeichen. Der erste Ausdruck liefert deshalb einen Treffer über beide Zeilen. Der ausdrückliche Ausschluss von CR und LF ergibt zwei Treffer:
const text = 'utm_source=newsletter\nutm_medium=email';
const broad = [...text.matchAll(/^utm_([a-z_]+)=([^&]+)$/gm)];
const bounded = [...text.matchAll(/^utm_([a-z_]+)=([^&\r\n]+)$/gm)];
console.log(broad.length);   // 1
console.log(bounded.length); // 2
console.log(broad[0][2] === 'newsletter\nutm_medium=email'); // true
console.log(/^[0-9]+$/.test('123\n')); // false (JavaScript, no m)
console.log(/^[0-9]+$/m.test('bad\n123\nbad')); // true: one valid line
Das begrenzte Beispiel beschreibt ein bewusst einfaches Zeilenformat mit nichtleerem Wert. Leerzeichen bleiben erlaubt; [^&\s]+ würde zusätzlich Leerzeichen und weitere Leerraumzeichen ausschließen und damit eine andere Regel festlegen. CRLF-Eingaben und erlaubte Leerwerte benötigen eigene Tests. Echte URL-Abfragezeichenfolgen lassen sich mit einem URL-Parser und URLSearchParams einschließlich Dekodierung und mehrfacher Schlüssel auswerten.
Validierung braucht eine Prüfung der gesamten Eingabe
Eine Suche nach [0-9]+ trifft innerhalb von abc123def. JavaScript /^[0-9]+$/ ohne m beschränkt den gesamten Wert auf ASCII-Ziffern. Mit m genügt eine passende Zeile innerhalb einer sonst ungültigen Eingabe. Alternativen benötigen außerdem Gruppierung: ^(?:yes|no)$ wendet beide Anker auf beide Alternativen an.
Anker prüfen eine Position, etwa den Anfang oder das Ende der Eingabe, ohne dabei ein Zeichen zu verbrauchen. Die Ankerregeln unterscheiden sich. In Python trifft $ auch unmittelbar vor einem abschließenden Zeilenumbruch; re.fullmatch(r"[0-9]+", value) prüft ausdrücklich die gesamte Zeichenfolge. PCRE2/PHP erlaubt \A[0-9]+\z. In Ruby sind ^ und $ auch ohne Schalter Zeilenanker; für die gesamte Eingabe stehen \A und \z. Rubys Schalter m steuert dotAll, anders als der JavaScript-Schalter für Zeilenanker.
Mehrdeutige Wiederholung kann viel Rechenzeit kosten
Backtracking bedeutet: Wenn der restliche Ausdruck nicht passt, kehrt die Auswertung zu einer früheren Entscheidung zurück und versucht eine andere Möglichkeit. Dadurch können zahlreiche Aufteilungen desselben Textes durchprobiert werden. ^(a+)+$ gegen eine Folge von a mit abschließendem ! ist eine typische riskante Struktur. Ohne die überflüssige äußere Wiederholung akzeptiert ^a+$ dieselben gültigen Zeichenfolgen. Die konkrete Dauer hängt von Engine, Optimierungen, Eingabe und Grenzen ab; eine allgemeine Dreißig-Zeichen-Schwelle existiert nicht.
Verschachtelung allein beweist keine exponentielle Laufzeit und ist auch nicht die einzige Ursache langsamer Auswertung. Eine unverankerte Suche nach a+$ kann bei langer unpassender Eingabe viele Startpositionen versuchen. Das Entfernen einer Verschachtelung rechtfertigt deshalb keine allgemeine Linearitätszusage. Überlappende Alternativen und ein teurer erfolgloser Zweig vor einem erfolgreichen Zweig sind ebenfalls relevant.
Muster wie (.*,)*$ erlauben null Wiederholungen und können bei einer Suche einen leeren Endtreffer liefern. Die Einteilung in immer schnelle Treffer und ausschließlich langsames vollständiges Scheitern greift deshalb zu kurz. Ein fauler Quantor verändert die Suchreihenfolge, beseitigt mehrdeutige Aufteilungen aber nicht grundsätzlich.
Tests und Grenzen gehören zum Entwurf
Nützliche Fälle umfassen gültige Eingaben, zwei Vorkommen, ungültige Präfixe und Suffixe, Leerwerte, CR/LF, Unicode-Ziffern, fehlende Trennzeichen und lange Beinahetreffer. Erwartungswerte sollten Gruppeninhalte und Trefferpositionen einschließen, nicht nur einen Wahrheitswert. Drei Beispiele sind ein Anfang, kein Vollständigkeitsnachweis.
Potenziell teure Muster gehören in isolierte Tests mit zunächst kleinen Eingaben und einer festen externen Zeitgrenze oder einem unterstützten Engine-Timeout. Grenzen für Eingabe und Mustergröße bleiben sinnvoll. Ein Timeout ist ein zu behandelnder Fehler, kein Beweis für einen ungültigen Text.
Fragen und Antworten
Lösen atomare Gruppen oder possessive Quantoren jedes Problem?
Nein. Die Unterstützung hängt von der Engine ab; Python kennt beides seit 3.11. Das Verhindern von Rücksprüngen kann die akzeptierten Zeichenfolgen verändern: Ein gieriger possessiver Teil kann Zeichen verbrauchen, die der folgende Teil benötigt. Gleichwertigkeit braucht Tests.
Was garantiert eine Engine mit linearer Laufzeit?
RE2 und Go regexp dokumentieren bei festem Muster lineare Auswertung in der Eingabelänge. Rust regex nennt O(m × n) für eine einzelne Suche mit Mustergröße m und Eingabelänge n; Iteratoren über mehrere Treffer können quadratische Laufzeit in n besitzen. Nicht unterstützte Funktionen, Kompilierung, Größenlimits und die verwendete Methode bleiben relevant. Beliebige Rückverweise und Lookarounds gehören nicht zum Funktionsumfang dieser Bibliotheken.
Bedeutet \d immer ASCII-Ziffern?
In JavaScript trifft \d die Ziffern 0–9. Python-Zeichenfolgenmuster und das Standardverhalten von .NET erfassen zusätzlich Unicode-Dezimalziffern; Pythons ASCII-Schalter und die ECMAScript-Option von .NET verändern relevante Regeln. [0-9] drückt eine reine ASCII-Anforderung ausdrücklich aus.
Quellen
- MDN: Reguläre Ausdrücke
- MDN: Quantoren
- MDN: Prüfung der Eingabegrenzen
- MDN: Kurzformen für Zeichenklassen
- Python: re
- PCRE2: Mustersyntax
- Ruby: Regexp
- Microsoft: Zeichenklassen in .NET
- Google: RE2
- Go: regexp
- Rust regex: Laufzeit und nicht vertrauenswürdige Eingaben
- V8: Backtracking und eine alternative Engine
- MDN: URLSearchParams
Verstehen durch Ausprobieren
Welche Namen lässt Dein Regex durch?
Gesucht ist genau error.log. Setze Anker und maskiere den Punkt: Welche unerwünschten Namen verschwinden aus den Treffern?
Feste, einzeilige Beispiele in JavaScript, ohne Flags. Der Punkt steht für ein beliebiges Zeichen außer Zeilenumbrüchen; \. für einen echten Punkt. Keine frei eingegebenen Muster und kein Test der Laufzeit oder Sicherheit eines Regex.
Dieses Modul rechnet im Browser und sendet oder speichert Deine Eingaben nicht.
Verstehen durch Ausprobieren
Eine Minute: Findest Du den Denkfehler?
Warum trifft ^error.log$ auch auf errorXlog zu?
^ und $ begrenzen die Position, ändern aber nicht die Bedeutung des Punkts. Erst ^error\.log$ verlangt in diesem Beispiel den echten Punkt.
Code Schritt für Schritt
Entdecken
Code Schritt für Schritt
Eine feste JavaScript-Funktion, fünf Schritte. Wähle einen Namen und beobachte, wann welche Variable ihren Wert bekommt.
function validate() {}
inputpatternmatchvalidreturn
Feste einzeilige Beispiele, JavaScript ohne Flags. Du bearbeitest keinen frei ausführbaren Code. Andere Regex-Spielarten und mehrzeilige Eingaben sind nicht Teil dieser Übung.
PNG mit Einstellungen, Ergebnis und Artikelverweis. Erst beim Klick lokal erstellt.
Die Übungen rechnen im Browser. Deine Antworten werden vom Lernmodul nicht versendet.
Passend dazu