English
 Deutsch
 Polski
Safari 27 i mierzalność w 2027 roku: co jest technicznie blokowane i jaka architektura trackingu się utrzyma

Management Summary
Safari to przeglądarka internetowa Apple. Ochrona prywatności może ograniczać informacje otrzymywane przez witryny o wizytach i ich źródłach. Artykuł wyjaśnia skutki dla firm mierzących efekty marketingu: raport może mieć luki mimo poprawnego działania strony. Zbieranie danych przez własny adres nie przywraca informacji wcześniej usuniętych przez przeglądarkę. Znajomość tych granic pomaga oceniać wyniki i odróżniać potwierdzone ograniczenia od niezweryfikowanych zapowiedzi.
Spis treści
Safari może blokować żądania pomiarowe lub usuwać informacje z żądania. Poprawnie wysłane zdarzenie nie musi więc zawierać użytecznej informacji o źródle ruchu. Planowanie na 2027 rok wymaga sprawdzenia rzeczywistej drogi danych: co dociera do serwera, co może odczytać skrypt i co później pojawia się w raporcie.
Przegląd źródeł z 25 października 2026 roku oddziela udokumentowane funkcje od otwartych pytań. Informacje Apple o wydaniu Safari 27 nie potwierdzają pełnej nowej listy blokowanych sieci reklamowych ani parametrów URL. Publiczny kod WebKit pokazuje możliwe filtry i uprawnienia, ale nie stanowi wiarygodnego wykazu wszystkich obecnie dostarczanych reguł. Konkretne dodatki, takie jak xmt, si czy wskazani dostawcy, nie są tu zatem przedstawiane jako potwierdzone blokady Safari 27. Na potrzeby tego artykułu nie przeprowadzono testu na urządzeniu z Safari. [1, 4, 5]
Które mechanizmy ochrony są udokumentowane
Mechanizmy mają różne zadania. Filtr sieciowy uniemożliwia połączenie. Link Tracking Protection usuwa określone identyfikatory z adresu. Ochrona przed fingerprintingiem utrudnia rozpoznawanie na podstawie cech urządzenia. Limit ciasteczka skraca natomiast czas przechowywania identyfikatora. Każdy przypadek wymaga osobnego testu.
| Mechanizm | Udokumentowana podstawa | Skutek praktyczny |
|---|---|---|
| Filtrowanie sieciowe | WebKit opisywał blokowanie znanych trackerów w trybie prywatnym już przy Safari 17. | Skrypt może się załadować, mimo że późniejsze żądanie pomiarowe nie dociera. |
| Ochrona przed fingerprintingiem | Safari 26 ogranicza znanym skryptom fingerprintingowym między innymi odczyt cech urządzenia, długotrwały zapis przez skrypt oraz dostęp do parametrów URL i referrera. | Żądanie może dotrzeć bez informacji o poprzedniej stronie lub kampanii. |
| Reguły ciasteczek i pamięci | WebKit rozróżnia ciasteczka stron trzecich, pamięć zapisywaną przez skrypty i dostęp do serwera rozpoznany jako maskowanie strony trzeciej. | Własna subdomena nie oznacza stale dostępnego identyfikatora. |
Tabela podsumowuje istniejące mechanizmy, zamiast przypisywać każdej wersji Safari całkowicie nową warstwę ochrony. Ustawienia, tryb prywatny, blokery treści i konkretne żądanie mogą zmieniać wynik. Krajowe udziały przeglądarek nie zastępują analizy rzeczywistego ruchu danej witryny. [2, 3, 6]
Brak danych mimo poprawnego żądania
Brak informacji o źródle można zbadać: dziennik sieciowy pokazuje faktycznie przesłane pola. Poprawna odpowiedź HTTP potwierdza na początku tylko transfer. Dopiero porównanie danych wejściowych, wysłanej zawartości i raportu pokazuje miejsce utraty informacji. Sam wzrost udziału „Direct” nie dowodzi działania filtra Safari.
Ochrona przed fingerprintingiem nie oznacza też nowych losowych wartości przy każdym odczycie. WebKit opisuje między innymi zmienione wyniki i ujednolicone cechy urządzenia; pewne wartości audio pozostają spójne w obrębie bufora. Nie wynika z tego, że każdy możliwy fingerprint stał się niemożliwy. [7]
W przejrzanym publicznym kodzie WebKit przyporządkowanie skryptów korzysta między innymi z nazw hostów i domen. Interfejsy zawierają osobne uprawnienia dotyczące ciasteczek, lokalnej pamięci, parametrów URL i żądań sieciowych. Ten kod rozwojowy nie potwierdza pełnego zestawu reguł zainstalowanej wersji Safari 27. Nie dowodzi też automatycznego dziedziczenia wszystkich ograniczeń kontenera tagów przez każdy później załadowany skrypt. [4, 5]
Co zmienia własna domena
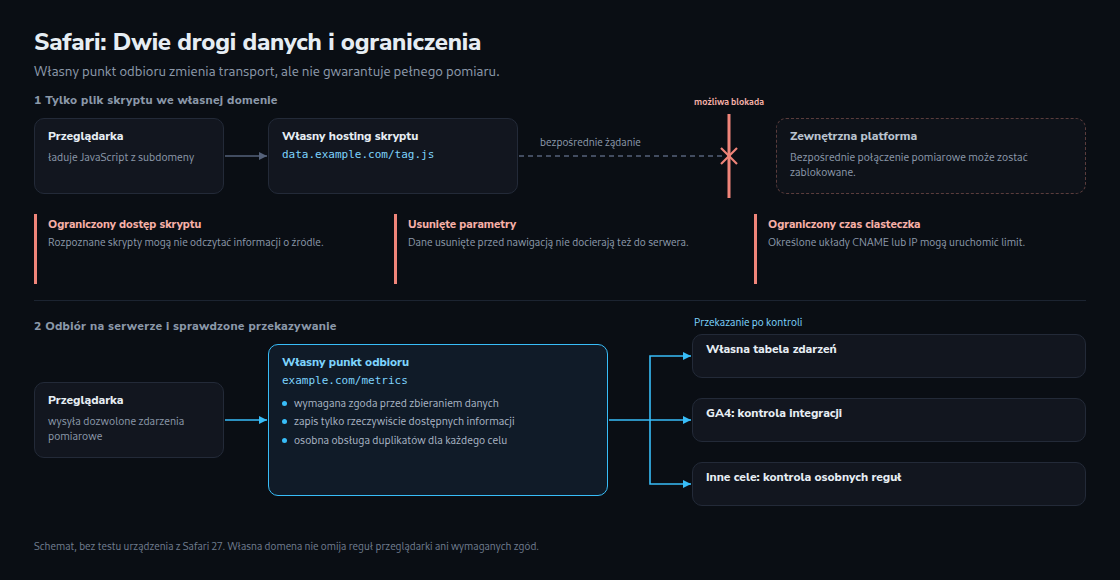
| Konfiguracja | Droga danych | Ograniczenie |
|---|---|---|
| Hosting samego skryptu | Witryna dostarcza JavaScript, a przeglądarka wysyła później dane bezpośrednio do platformy analitycznej. | Zewnętrzne połączenie pomiarowe pozostaje i może zostać zablokowane. |
| Własny punkt odbioru | Przeglądarka wysyła dane np. do example.com/metrics. Serwer sprawdza dane i przekazuje dozwolone zdarzenia. | Mniej bezpośrednich połączeń z platformami, ale bez gwarancji ochrony przed regułami przeglądarki, blokerami treści lub brakami danych wejściowych. |
Collection endpoint to punkt odbioru zdarzeń pomiarowych. Reverse proxy, czyli serwer pośredniczący, może przekazywać żądania spod własnej ścieżki do usługi wewnętrznej. Przeglądarka widzi wtedy własną ścieżkę. Nie zastępuje to kontroli zapisywanych danych ani wymaganych zgód.
Osobne sprawdzanie parametrów URL i ciasteczek
Link Tracking Protection może usuwać identyfikatory jeszcze przed załadowaniem strony docelowej. Usunięta informacja nie dociera wtedy również do serwera. Parametry kampanii i uprawnienia skryptu do odczytu to osobne kwestie: parametr może dotrzeć do serwera, podczas gdy ograniczony skrypt nie uzyska dostępu do wartości. Dlatego testy powinny obejmować tryb prywatny i dodatkowe ustawienie ochrony dla całego przeglądania. [3, 7]
Parametry UTM, np. utm_source, określają źródło kampanii. Click ID oznacza natomiast konkretny klik reklamowy. Przypisanie do kampanii według UTM jest użyteczne, ale nie odtwarza usuniętego click ID ani nie dowodzi skutku pojedynczej reklamy.
Przy ciasteczkach serwera pod własną subdomeną mogą działać kontrole CNAME i IP. CNAME to odwołanie DNS do innej nazwy. WebKit opisuje ograniczenia dla określonych przypadków ukrywania strony trzeciej za własną subdomeną. Nie oznacza to identycznego traktowania każdego ciasteczka z serwera o innym adresie IP. [6]
Konkretny test porównuje wysłany nagłówek Set-Cookie, termin wygaśnięcia zapisany w przeglądarce i późniejszą dostępność. Termin po siedmiu dniach może pochodzić również od samego serwera. Ścieżka w domenie głównej może uniknąć pewnych różnic w drodze danych, ale nie gwarantuje dłuższego przechowywania. HttpOnly blokuje dostęp z JavaScript; nie tworzy wyjątku od reguł pamięci Safari.
Konfiguracja możliwa do sprawdzenia w 2027 roku
- Ograniczenie zbierania. Wymagane zgody i dozwolone cele muszą sterować zbieraniem oraz zapisem od początku, nie dopiero przekazywaniem danych. Własna baza nie sprawia automatycznie, że zbieranie jest dozwolone.
- Zapis dostępnego źródła ruchu. Serwer otrzymuje faktycznie żądany URL. Nagłówek
Referermoże być nieobecny lub zawierać tylko źródłową domenę; fragment URL po#nie jest dołączany. Wcześniej usuniętych parametrów nie da się w ten sposób odzyskać. [8] - Kontrola przekazywania dla każdego celu. GA4 Measurement Protocol uzupełnia zwykłe zbieranie danych; pełne przejście wyłącznie na ten protokół może prowadzić do niepełnych raportów. Ogólne
event_idnie usuwa automatycznie wszystkich duplikatów GA4. Dla zakupów w internetowych strumieniach danych Google opisuje usuwanie duplikatów za pomocątransaction_id. [9, 10] - Możliwy do prześledzenia zapis zdarzeń. Dozwolona tabela ograniczona do określonego celu pozwala porównać wejście i przekazywanie. Zawiera tylko otrzymane zdarzenia, a nie pełny wykaz wszystkich wizyt.
Mniej JavaScript może odciążyć stronę. Poprawa czasu ładowania lub reakcji na działania wymaga jednak pomiaru konkretnej konfiguracji.
Badanie braków na jasno określonej podstawie
Porównanie zaczyna się od tego samego żądania strony po obu stronach: unikalny identyfikator żądania łączy dostarczenie HTML z odpowiadającym zdarzeniem odsłony. Żądanie z dwoma powtórzonymi zdarzeniami nadal liczy się raz. Pamięć przeglądarki, nawigacja wewnętrzna bez nowego żądania HTML, boty i wstępne pobieranie wymagają osobnych zasad.
Zestaw testów obejmuje zwykły i prywatny tryb Safari, rozszerzoną ochronę całego przeglądania, linki z Poczty lub Wiadomości oraz przeglądarkę porównawczą. Każdy przypadek zapisuje URL na serwerze, pola wysłanego zdarzenia, zablokowane żądania i zachowanie ciasteczek. Wynik powinien zawierać wersję przeglądarki, ustawienia, stan zgody i aktywne blokery treści.
Poniższy przykład BigQuery korzysta z dwóch tabel projektu, a nie z gotowego eksportu GA4. measurement_allowed może mieć wartość prawda tylko wtedy, gdy zapis tego żądania do celów pomiarowych jest dozwolony i dostępna jest wymagana zgoda. is_prefetch, is_bot i is_document_request to wcześniej przygotowane pola logu. Okno kończy się dzień przed analizą, aby opóźnione zdarzenia miały czas dotrzeć; jeden dzień nie gwarantuje nadejścia wszystkich opóźnionych danych.
WITH bounds AS (
  SELECT TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 29 DAY) AS start_ts,
         TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 1 DAY) AS end_ts,
         CURRENT_TIMESTAMP() AS checked_at
), raw_logs AS (
  SELECT l.*, COUNT(*) OVER (PARTITION BY request_id) AS id_rows
  FROM server_access_logs AS l CROSS JOIN bounds AS b
  WHERE l.ts >= b.start_ts AND l.ts < b.end_ts
), logs AS (
  SELECT browser_family, request_id,
    REGEXP_CONTAINS(
      SPLIT(COALESCE(url, ''), '#')[OFFSET(0)],
      r'[?&](gclid|msclkid|fbclid|twclid)=[^&#]+'
    ) AS has_click_id
  FROM raw_logs
  WHERE is_document_request AND NOT is_bot AND NOT is_prefetch
    AND measurement_allowed
    AND request_id IS NOT NULL AND TRIM(request_id) != ''
    AND id_rows = 1
), hits AS (
  SELECT DISTINCT request_id
  FROM analytics_events AS e CROSS JOIN bounds AS b
  WHERE event_name = 'page_view'
    AND e.ts >= b.start_ts AND e.ts < b.checked_at
    AND request_id IS NOT NULL AND TRIM(request_id) != ''
)
SELECT l.browser_family,
       COUNT(*) AS document_requests,
       ROUND(SAFE_DIVIDE(COUNTIF(h.request_id IS NOT NULL), COUNT(*)), 3)
         AS capture_rate,
       ROUND(SAFE_DIVIDE(COUNTIF(l.has_click_id), COUNT(*)), 3)
         AS click_id_share
FROM logs AS l LEFT JOIN hits AS h USING (request_id)
GROUP BY l.browser_family
ORDER BY document_requests DESC;
capture_rate to udział jednoznacznie rozpoznanych żądań dokumentu z co najmniej jedną odsłoną. click_id_share obejmuje wszystkie uwzględnione żądania dokumentu, a nie tylko wejścia z płatnych kampanii. Zapytanie wyklucza brakujące, puste i powtarzające się w danym oknie identyfikatory żądań. Liczba i przyczyny tych wykluczeń wymagają osobnej kontroli. Łączenie danych wymaga identyfikatorów unikalnych we wszystkich żądaniach.
Niższy wynik Safari wskazuje potrzebę badania, a nie wyizolowany wpływ przeglądarki. Różne zgody, blokery treści, błędy klasyfikacji i utrata danych również mogą wpływać na wynik. Odsetek click ID dla płatnych wejść wymaga dodatkowo podstawy złożonej z wiarygodnie rozpoznanych wejść kampanii. Więcej ruchu „Direct” lub mniej powracających wizyt stanowi dalszą wskazówkę, ale nie wskazuje jednoznacznie konkretnej reguły Safari.
Pytania i odpowiedzi
Czy CNAME gwarantuje stale dostępne ciasteczka?
Nie. Sama widoczna nazwa nie rozstrzyga działania Safari. Sprawdzenia wymagają cel połączenia, relacja adresów IP, konkretna reguła ciasteczka i tryb przeglądania. Błędne byłoby również twierdzenie, że każdy CNAME automatycznie uruchamia taki sam limit siedmiu dni.
Jak pamięć CDN wpływa na porównanie?
Stron dostarczonych przez CDN nie ma w logu serwera źródłowego. Podstawa zliczania musi wtedy pochodzić z CDN. Identyfikator żądania zapisany w buforowanym HTML może być wydawany wielokrotnie. Łączenie wymaga nowego identyfikatora dla każdego rzeczywistego dostarczenia, np. tworzonego przez funkcję CDN. Wiele zdarzeń z tym samym ID może też wynikać z ponowień lub podwójnych tagów i samo nie dowodzi błędu pamięci podręcznej.
Czy codzienny panel wykryje każdą nową blokadę?
Panel może pokazać nietypowe zmiany. Mała próba, opóźnione dane i równoczesne zmiany kampanii utrudniają wykrywanie. Ustalenie przyczyny wymaga także konkretnych żądań testowych; nie można obiecać wykrycia każdej zmiany reguł w ciągu jednego dnia.
Źródła
- Apple: informacje o wydaniu Safari 27
- WebKit: funkcje Safari 17
- WebKit: funkcje Safari 26
- WebKit: publiczne interfejsy prywatności (gałąź rozwojowa)
- WebKit: przypisywanie reguł prywatności skryptom (gałąź rozwojowa)
- WebKit: ochrona przed śledzeniem i reguły ciasteczek
- WebKit: Private Browsing 2.0
- MDN: nagłówek HTTP Referer
- Google: GA4 Measurement Protocol i ograniczenia
- Google: usuwanie duplikatów zakupów przez identyfikator transakcji
Powiązane artykuły