English
 Deutsch
 Polski
Cztery rodzaje liczb w raporcie konwersji: policzone, modelowane, prognozowane i szacowane z przedziałem

Spis treści
W raporcie konwersji stoją dziś cztery różne rodzaje liczby. Trzy z nich wyglądają jednakowo – ten sam krój, ta sama szerokość kolumny, to samo wyrównanie. Czwarty wygląda inaczej, i to jest jego zaletą.
Rozróżnienie nie jest akademickie. Rozstrzyga, czy liczbę wolno dodać, porównać, przeliczyć i wpisać do umowy.
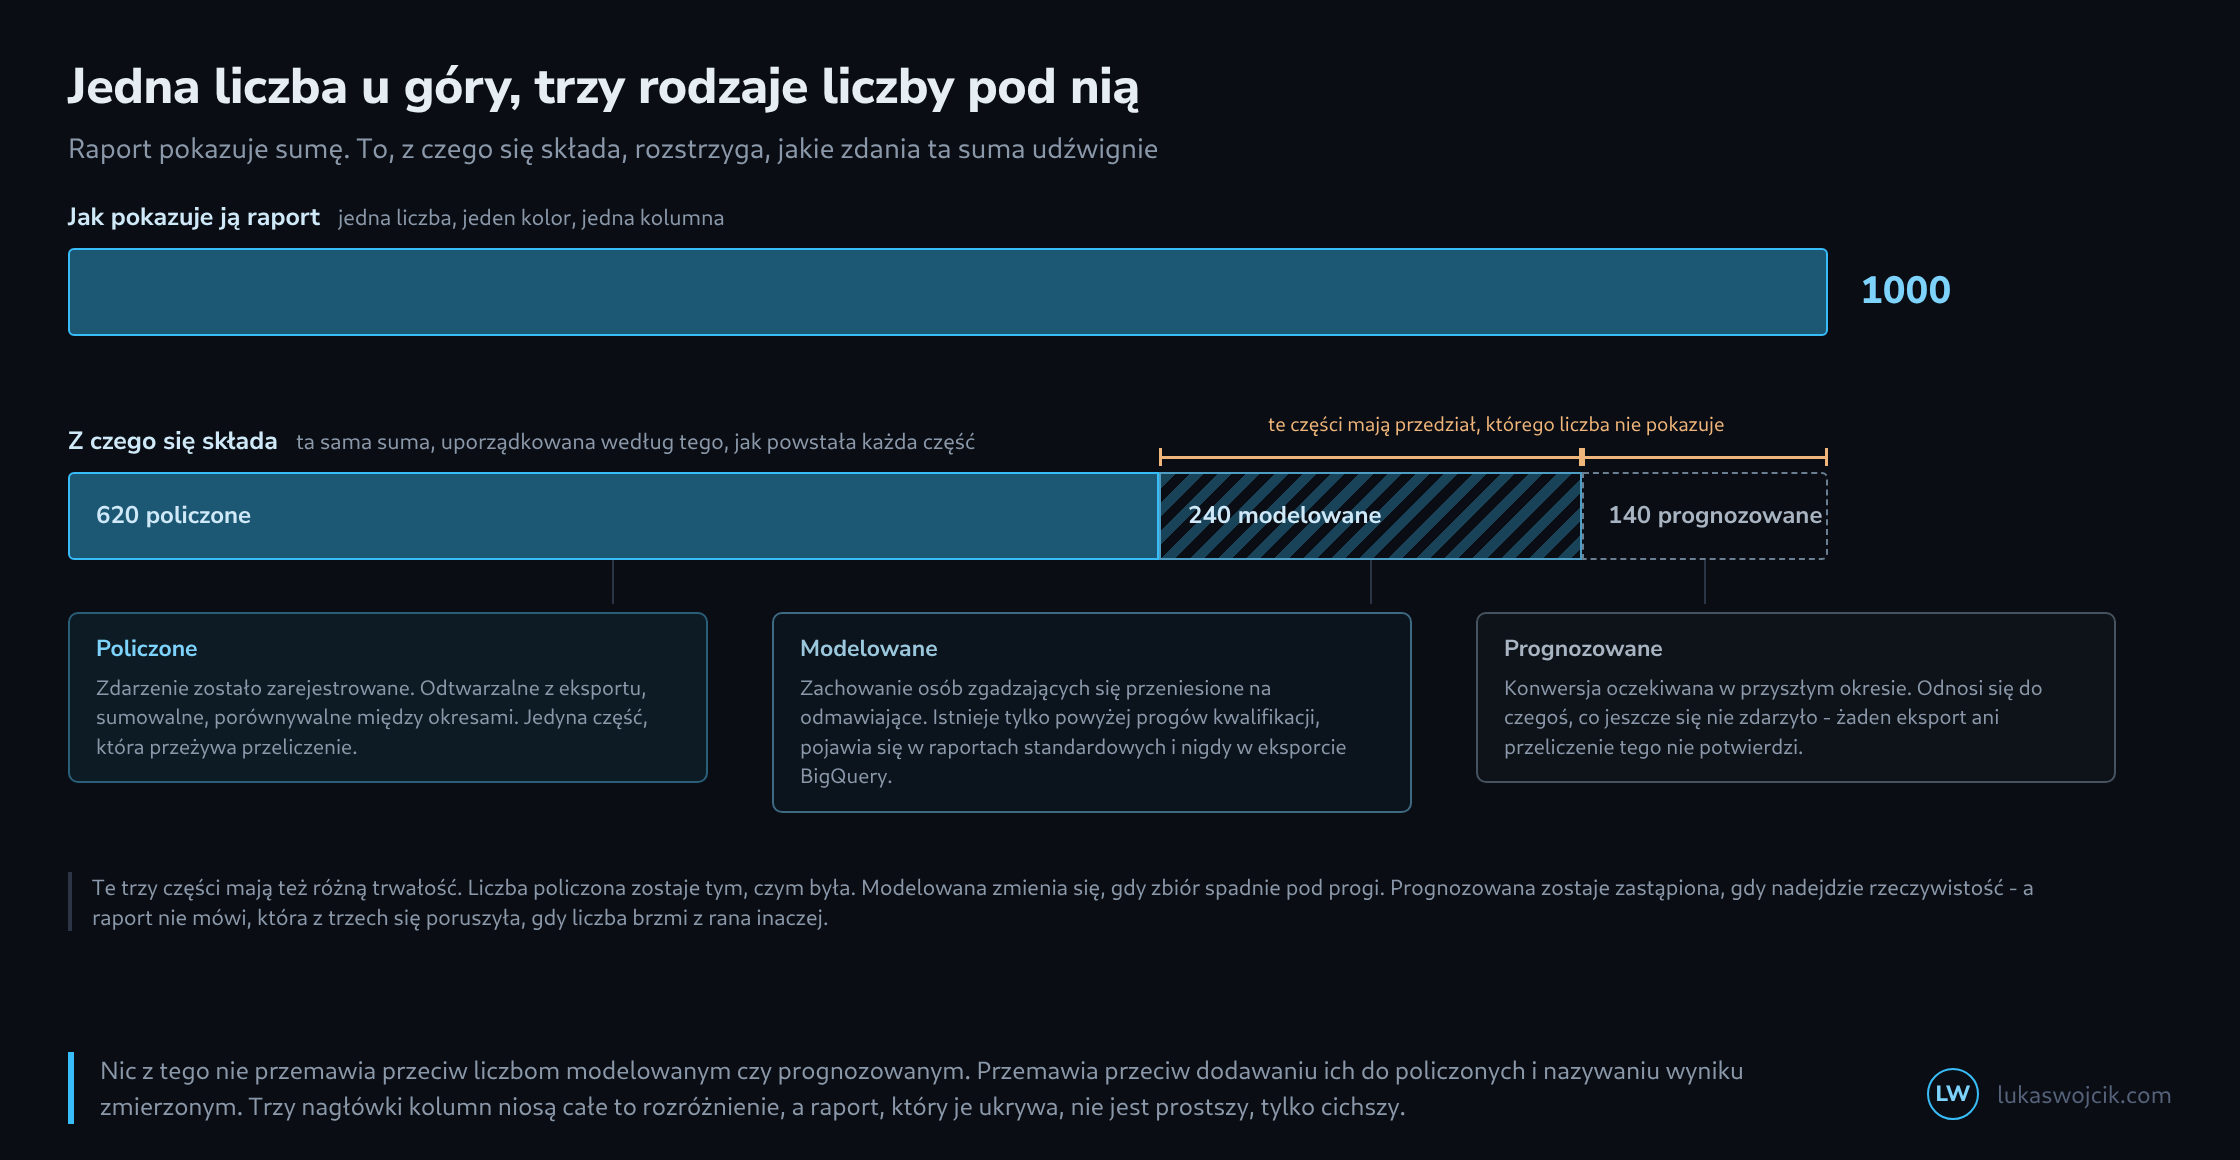
Policzone
Zdarzenie nadeszło i zostało zarejestrowane. Ta liczba ma trzy właściwości, których nie ma żadna inna: da się ją odtworzyć z danych surowych, da się ją dodawać między okresami i już się nie zmienia. Kto przeliczy ją za dwa lata, dostanie ten sam wynik.
To ta część, do której zdanie w rodzaju „we wrześniu było ich 620″ naprawdę pasuje. Wszystko inne wymaga dopisku.
Modelowane
W trybie zgody model przenosi zachowanie osób zgadzających się na odmawiające. To, co przy tym powstaje, pojawia się w raportach standardowych obok wartości policzonych i nie da się go tam od nich odróżnić.
Dwie właściwości czynią tę liczbę kłopotliwą. Istnieje tylko wtedy, gdy zbiór dosięga progów kwalifikacji – a kwalifikacja bywa tracona i odzyskiwana, bez żadnej adnotacji obok. I nigdy nie pojawia się w eksporcie BigQuery. Kto porówna liczbę z raportu z zapytaniem na danych surowych, znajdzie rozbieżność bez przyczyny w danych, mającą przyczynę w definicji.
Prognozowane
Rodzaj najnowszy jest najmniej oswojony. Qualified Future Conversions szacują konwersje, które nastąpią jeszcze w ciągu 180 dni po dotknięciu reklamy, i pojawiają się we własnych kolumnach obok istniejących. Biegną obecnie jako test ograniczony.
Różnica wobec wszystkiego innego jest zasadnicza: ta liczba nie odnosi się do przeszłości. Nie jest oszacowaniem nieobserwowanej części przeszłości, lecz twierdzeniem o przyszłości. Żadne przeliczenie nie może jej zatem potwierdzić ani zaprzeczyć – w każdym razie nie w tym kwartale.
Cztery rodzaje, cztery sprawdzenia

  rodzaj        odtwarzalne     sumowalne   zmienia się    podany
                 z eksportu      w czasie    później        przedział

  policzone      tak             tak         nie            nie dotyczy
  modelowane     nie             ostrożnie   tak, niezauważ. nie
  prognozowane   nie             nie         tak, z zasady   nie
  oszacowane     tak, z modelu   nie         przy przeliczeniu tak

  Tylko rodzaj ostatni podaje swoją niepewność sam z siebie.
  Tylko pierwszy przeżywa przeliczenie bez zmian.
Oszacowane, i to z przedziałem
Model mieszany podaje oszacowanie środkowe i przedział, w którym wartość prawdziwa leży z dużym prawdopodobieństwem. Z czterech rodzajów to jedyny, który dostarcza miarę niepewności, zamiast ją przemilczeć.
Właśnie dlatego wygląda w raporcie inaczej i właśnie dlatego bywa najczęściej używany błędnie: wypisanie oszacowania środkowego i pominięcie przedziału zamienia najuczciwszą z czterech liczb w najbardziej zwodniczą.
Po czym poznać rodzaj
Trzy sprawdzenia wystarczają i kosztują po kilka minut. Pierwsze to nagłówek kolumny: jeśli stoi tam „modelowane”, „szacowane”, „prognozowane” albo znak odsyłacza, pytanie ma odpowiedź. Drugie to eksport – liczba, której nie da się odtworzyć na danych surowych, nie jest policzona. Trzecie to odniesienie czasowe: liczba odnosząca się do okna w przyszłości jest prognozą, jakkolwiek się nazywa.
Która liczba udźwignie które zdanie
Dla wartości policzonych obowiązuje zdanie proste: tyle ich było. Dla modelowanych: było ich szacunkowo tyle, przy założeniach modelu, a w eksporcie stoi inna liczba. Dla prognozowanych: tyle oczekujemy do tego czasu. Dla oszacowanych z przedziałem: wkład leży prawdopodobnie między X a Y.
Żadne z tych zdań nie jest gorsze od pozostałych. Złe jest tylko użycie pierwszego, gdy zachodzi jedno z innych – a zdarza się to nie z nieuczciwości, lecz dlatego, że cztery rodzaje liczby stoją w tym samym wierszu, a nagłówek kolumny jest jedyną różnicą.
Pytania i odpowiedzi
Czy policzona liczba naprawdę pozostaje niezmienna, także kilka dni po zamknięciu okresu?
Dopiero po pewnym czasie. Trzy procesy zmieniają policzone wartości jeszcze później, nie zmieniając przy tym ich rodzaju:
- Czas przetwarzania. Zdarzenia z ostatnich dni często nie są jeszcze w pełni przetworzone w raportach; pobranie poprzedniego miesiąca pierwszego dnia następnego może dać zbyt niskie wartości dla jego ostatnich dni.
- Przypisanie do daty kliknięcia. Google Ads domyślnie księguje konwersje w dniu interakcji z reklamą. Zakup tydzień po kliknięciu podnosi wstecz wartość dnia kliknięcia, więc najnowsze dni rosną tak długo, jak długo otwarte jest okno konwersji.
- Korekty i usunięcia. Anulowane zakupy zgłoszone później jako korekty albo usunięte dane użytkowników zmniejszają liczbę, która została już zaraportowana.
Właściwość „już się nie zmienia” dotyczy więc okresu, dla którego wszystkie okna już się zamknęły. W raportach stanowiących podstawę umowy warto ustalić stały dzień pobrania danych i zapisać go razem z liczbą.
Czy da się porównać dwa miesiące, gdy tylko jeden z nich zawiera wartości modelowane?
Nie wprost. Różnica zawiera wtedy oprócz rzeczywistej zmiany także włączenie lub wyłączenie modelowania, a raport nie podaje o tym żadnej informacji. Bardziej miarodajne jest porównanie wartości policzonych z eksportu, bo tam w obu miesiącach obowiązuje ta sama definicja.
Jak sprawdzić prognozę po czasie?
Dopiero po upływie jej okna i tylko przy odpowiednim przygotowaniu. W przypadku Qualified Future Conversions okno wynosi 180 dni po dotknięciu reklamy. Później prognozę da się zestawić z policzonymi konwersjami, o ile dają się one przypisać do tych samych dotknięć reklamy.
Przygotowanie polega na zapisaniu prognozowanej wartości w chwili raportowania, razem z datą pobrania. Tabela w artykule podaje prognozy jako liczby, które zmieniają się z zasady; kto zajrzy dopiero po pół roku, może znaleźć w kolumnie inną wartość niż ta zaraportowana wtedy i nie będzie już w stanie sprawdzić pierwotnego stwierdzenia.
Dlaczego przedziałów z kilku okresów lub kanałów nie da się po prostu dodać?
Bo przedział sumy zależy od tego, jak poszczególne oszacowania są ze sobą powiązane. Dodanie dolnych i górnych granic daje właściwy przedział tylko wtedy, gdy wszystkie oszacowania wahają się całkowicie zgodnie. Jeśli są od siebie niezależne, odchylenia częściowo się znoszą, a zsumowany przedział wychodzi szerszy od rzeczywistego.
W modelu mieszanym przeciwstawne zależności są wręcz typowe. Jeśli dwa kanały zawsze działają jednocześnie, model ma trudność z podziałem ich wspólnego wkładu i przypisuje go raz jednemu, raz drugiemu. Oba przedziały cząstkowe stają się szerokie, a przedział ich sumy pozostaje wąski. Przedział sumy musi więc pochodzić z samego modelu, na przykład z jego próbek łącznego rozkładu, a nie z obliczeń na opublikowanych wartościach cząstkowych. Zgadza się to z tabelą w artykule, która określa wartości oszacowane jako niesumowalne w czasie.
Źródła
Powiązane artykuły