English
 Deutsch
 Polski
Meta Conversions API: Maksymalizacja Event Match Quality (EMQ) i deduplikacja
Część 5 z 5 serii Od piksela do serwera: śledzenie, które wytrzyma

Spis treści
- Meta Conversions API: Maksymalizacja Event Match Quality (EMQ) i deduplikacja
- 1. Zaawansowana normalizacja danych PII i haszowanie SHA-256 po stronie serwera
- 2. Bezpieczna deduplikacja zdarzeń za pomocą event_id oraz event_name
- 3. Wykorzystanie external_id w środowisku zgodnym z RODO
- Podsumowanie
- Pytania i odpowiedzi
- Źródła
Meta Conversions API: Maksymalizacja Event Match Quality (EMQ) i deduplikacja
W nowoczesnych architekturach analityki serwerowej równoległe wdrażanie Meta Conversions API (CAPI) oraz przeglądarkowego Meta Pixela wymaga precyzyjnej inżynierii danych. Głównym celem jest maksymalizacja Event Match Quality (EMQ) – wskaźnika określającego, jak precyzyjnie przychodzące zdarzenia serwerowe są dopasowywane do aktywnych kont użytkowników Meta – przy jednoczesnym zapewnieniu szczelnej deduplikacji zapobiegającej podwójnemu zliczaniu konwersji. Osiągnięcie wysokiego EMQ w zgodzie z przepisami RODO wymaga zaawansowanej normalizacji danych PII po stronie serwera, kryptograficznego haszowania oraz strukturalnego parowania identyfikatorów.
1. Zaawansowana normalizacja danych PII i haszowanie SHA-256 po stronie serwera
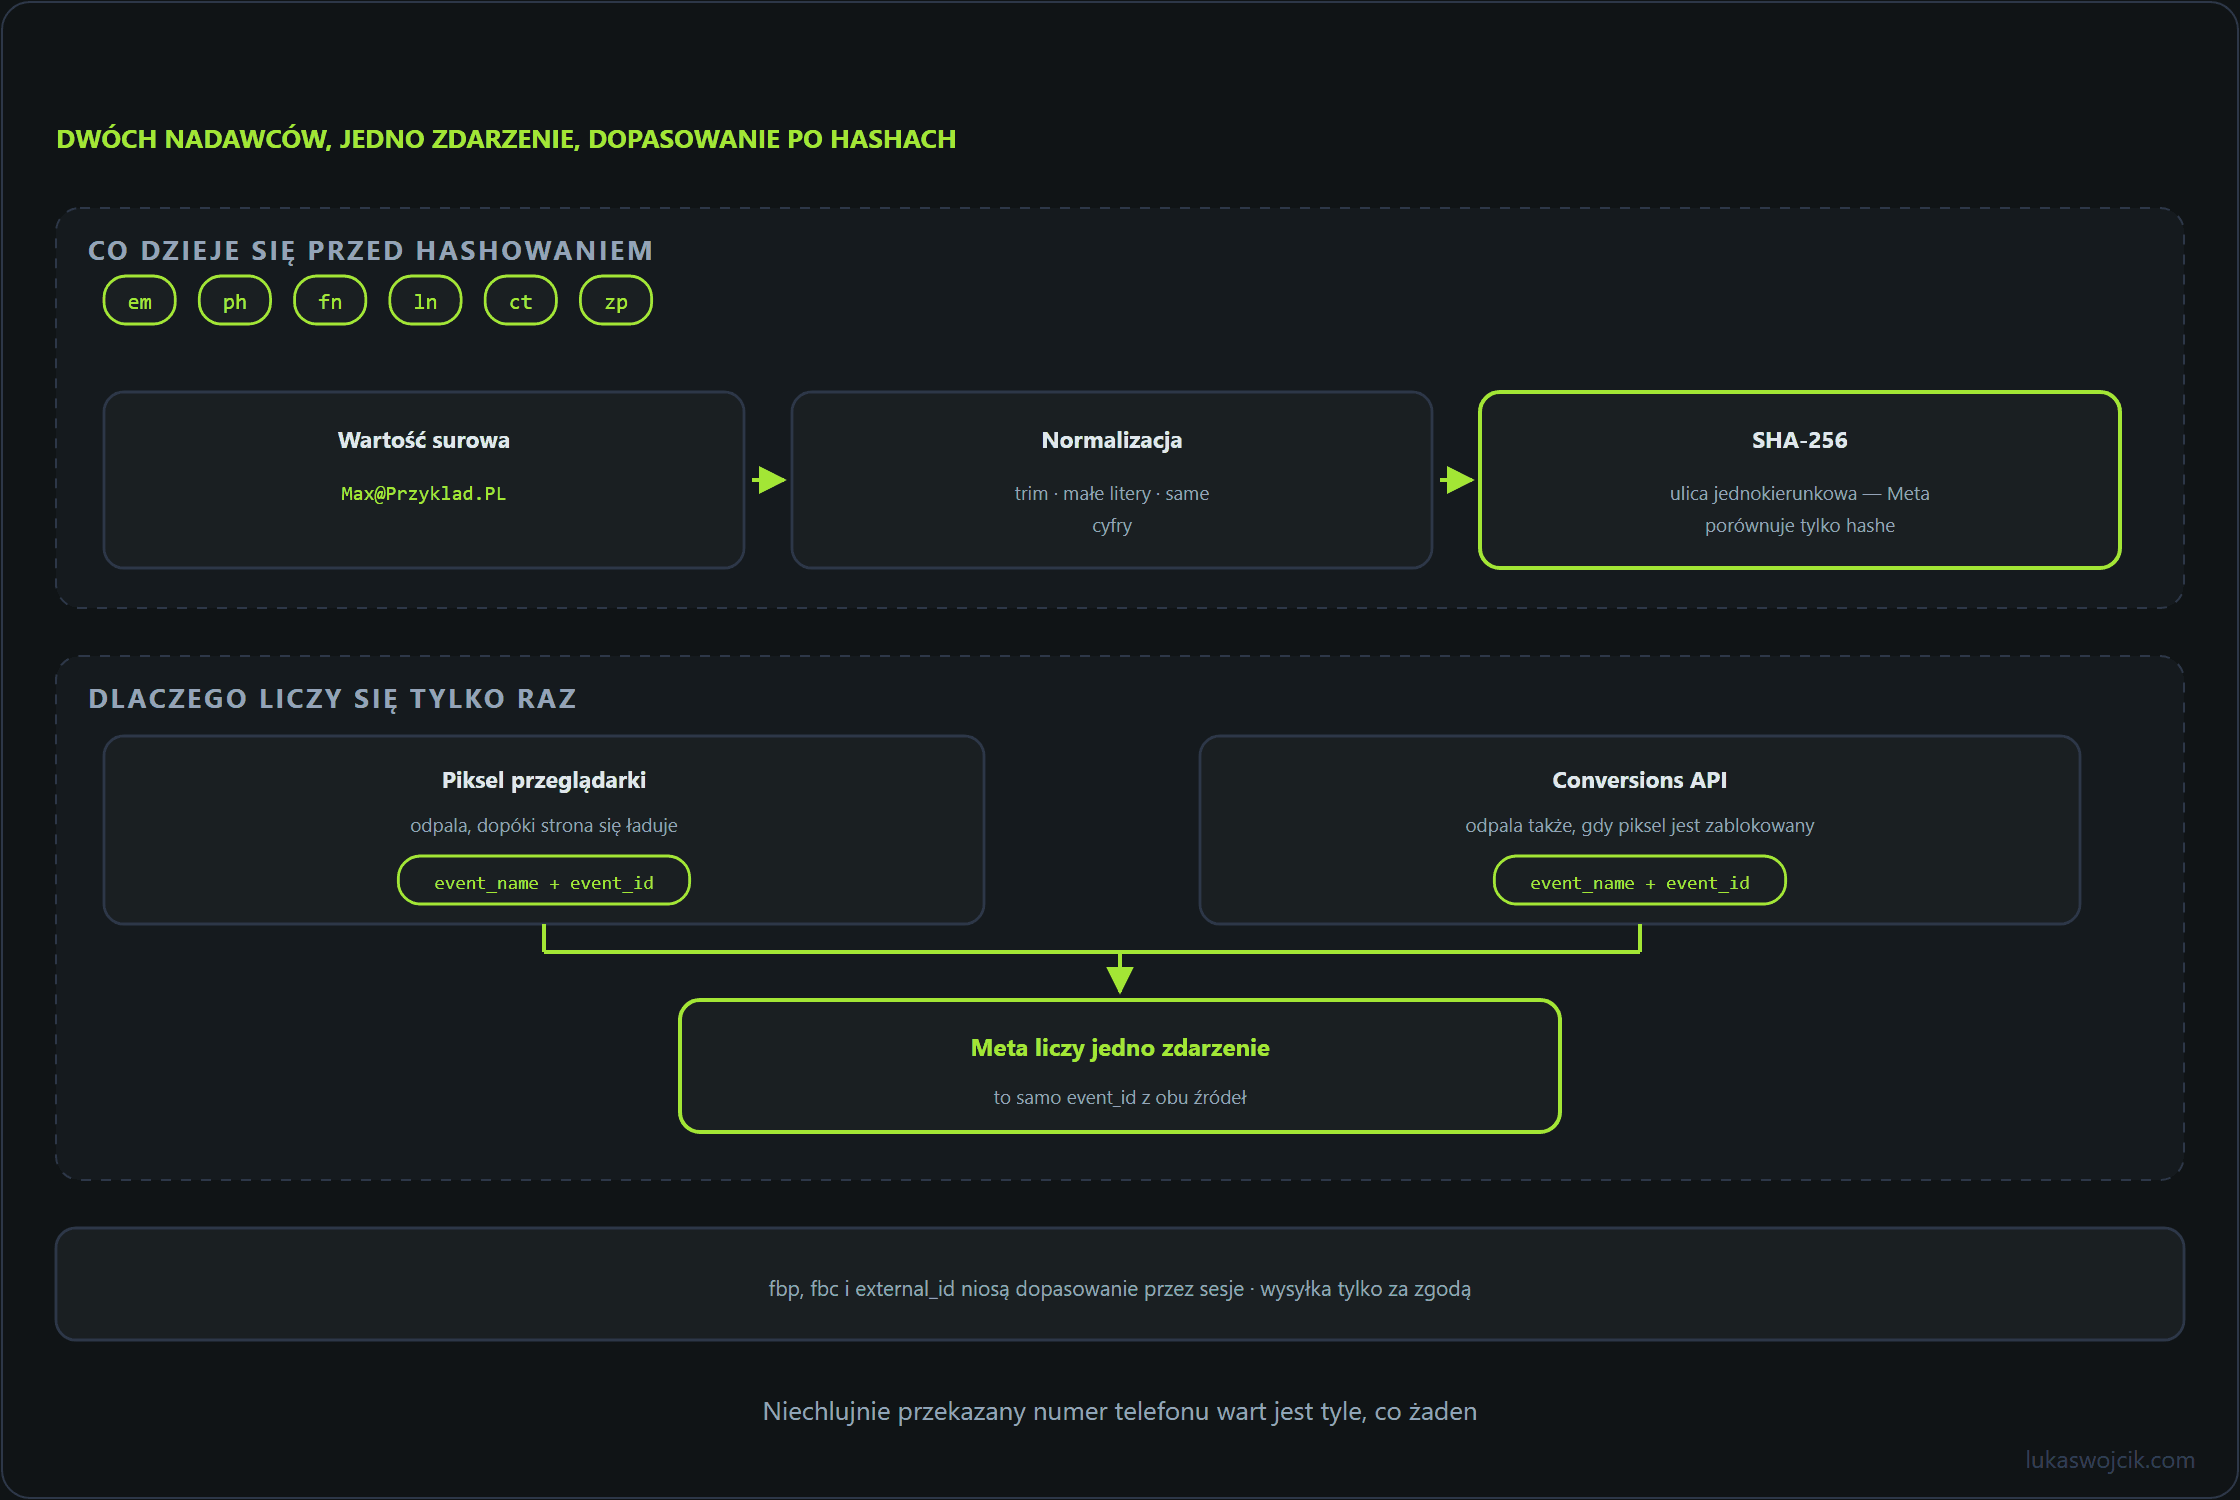
Meta wymaga, aby wszelkie dane osobowe (PII) – takie jak adresy e-mail, numery telefonów, imiona czy kody pocztowe – były przesyłane wyłącznie w formie kryptograficznych skrótów SHA-256. Haszowanie surowych wartości bezpośrednio w przeglądarce lub na serwerze bez uprzedniej normalizacji prowadzi jednak do poważnych błędów dopasowania. Jedna spacja na końcu ciągu lub wielka litera generuje zupełnie inny skrót SHA-256 niż ustandaryzowany rekord w bazie danych Meta.
Aby zagwarantować maksymalną skuteczność dopasowań, serwerowy potok analityczny (np. Server-Side Google Tag Manager) musi realizować surowe procedury normalizacyjne przed zastosowaniem algorytmu SHA-256:
- Adresy e-mail (
em): Konwersja wszystkich znaków na małe litery, usunięcie białych znaków z początku i końca ciągu oraz eliminacja niewidocznych znaków Unicode przed haszowaniem. - Numery telefonów (
ph): Usunięcie wszelkich symboli, myślników, spacji i wiodących zer. Przed haszowaniem numer telefonu musi zawierać wyłącznie cyfry sformatowane zgodnie z międzynarodowym standardem E.164 (wraz z kodem kraju, np.48...lub49...). - Imiona i dane adresowe (
fn,ln,ct,zp): Konwersja na małe litery, usunięcie interpunkcji oraz znaków diakrytycznych, a także redukcja nadmiarowych spacji.
// Przykład: Logika normalizacji po stronie serwera przed haszowaniem SHA-256
const normalizeEmail = (rawEmail) => {
  return rawEmail.trim().toLowerCase();
};

const normalizePhone = (rawPhone) => {
  // Usuwa wszystkie znaki niebędące cyframi i zapewnia międzynarodowy kod kraju
  return rawPhone.replace(/\D/g, '');
};
2. Bezpieczna deduplikacja zdarzeń za pomocą event_id oraz event_name
Dobrą praktyką jest równoległe przesyłanie zdarzeń konwersji przez przeglądarkowy Pixel i serwerowe Conversions API. Takie dwukanałowe podejście zabezpiecza ciągłość pomiaru przed blokerami reklam i błędami sieciowymi. Aby zapobiec dwukrotnemu przypisaniu zakupu dla jednej transakcji, mechanizm deduplikacji opiera się na dokładnym parowaniu parametrów.
Każdy ładunek wysyłany oboma kanałami musi zawierać identyczną wartość event_name oraz współdzielony, unikalny parametr event_id. Gdy serwery Meta otrzymają w oknie 48 godzin dwa zdarzenia z identycznym event_id, zduplikowany hit jest automatycznie odrzucany przy jednoczesnym zachowaniu bogatszych parametrów użytkownika pochodzących ze strumienia serwerowego.
- Generowanie ID: Wartość
event_idpowinna być generowana dynamicznie w przeglądarce (np. za pomocą UUIDv4 lub złożonego ciągu znacznika czasu) w momencie wywołania konwersji i przekazywana identycznie do tagu Pixela oraz tagu transportowego ssGTM. - Spójność czasowa: Zdarzenia z przeglądarki i serwera muszą docierać do punktów końcowych Meta w niewielkim odstępie czasu, aby zapewnić natychmiastową deduplikację w panelach raportowych.
3. Wykorzystanie external_id w środowisku zgodnym z RODO
W restrykcyjnym europejskim otoczeniu prawnym regulowanym przez RODO poleganie wyłącznie na ciasteczkach śledzących podmiotów trzecich (fbp i fbc) jest często niewystarczające ze względu na brak zgód lub skrócony czas życia ciasteczek. Parametr external_id stanowi stabilną, bezpieczną dla prywatności alternatywę przy rozpoznawaniu tożsamości cross-device.
Parametr external_id to stały, unikalny identyfikator klienta nadawany przez system CRM, bazę e-commerce lub program lojalnościowy. Podczas przesyłania do Meta CAPI obowiązują następujące zasady:
- Kontrola zgody: Przekazywanie jakichkolwiek danych PII, w tym zhaszowanych wartości
external_id, musi być bezwzględnie uzależnione od uzyskania wyraźnej zgody użytkownika (np. zgody reklamowej kontrolowanej przez Consent Mode v2). - Jednokierunkowe haszowanie: Wewnętrzny identyfikator klienta nie może być nigdy przesyłany otwartym tekstem. Skrót SHA-256 pozwala systemom Meta na powiązanie profilu z istniejącym grafem użytkowników bez ujawniania struktur wewnętrznych baz danych.
- Ciągłość między sesjami: Wdrożenie zhaszowanego
external_idumożliwia poprawną atrybucję konwersji nawet w sytuacji, gdy przejście ze smartfona na komputer stacjonarny następuje wiele tygodni po kliknięciu reklamy.
Podsumowanie
Maksymalizacja Event Match Quality w Meta Conversions API wymaga rygorystycznej inżynierii danych. Normalizacja i haszowanie PII wyłącznie na serwerze, parowanie identycznych wartości event_id w strumieniach przeglądarkowych i serwerowych w celu deduplikacji oraz wdrażanie zhaszowanych parametrów external_id zgodnie z wymogami RODO gwarantują najwyższą precyzję atrybucji i optymalne wyniki kampanii.
Pełną ścieżkę przez kontener Server-Side GTM, od przekazania danych do data layer po odczyt wyniku w Menedżerze zdarzeń Meta, opisuje artykuł Tutorial: Wdrożenie Meta Conversions API przez Server-Side GTM dla EMQ powyżej 6,0.
Pytania i odpowiedzi
Czy dopisywanie kodu kraju w skrypcie do numerów telefonów zapisanych w formacie krajowym, bez prefiksu, jest bezpieczne?
Bezpieczne jest tylko wtedy, gdy kraj jest znany dla danego rekordu, a przy numerze zapisanym bez prefiksu zwykle nie jest, tylko zgadywany na podstawie kraju sklepu albo języka strony.
Zgadywanie ma tu gorsze skutki, niż się wydaje. Błędnie doklejony prefiks daje numer poprawny formalnie, więc funkcja haszująca nic nie zgłosi, żądanie przejdzie, a jakość dopasowania po prostu będzie niższa bez wskazania przyczyny. To jest ta sama klasa błędu co pominięcie zamiany na małe litery przed haszowaniem: cicha i systematyczna.
Praktycznie sprawdzają się dwie rzeczy. Kraj zapisywany razem z numerem w momencie zbierania danych – jedno pole w formularzu albo wybór z listy, który i tak zwykle istnieje przy adresie dostawy. A dla rekordów historycznych, w których tej informacji nie ma: lepiej nie wysyłać numeru wcale. Brak identyfikatora obniża dopasowanie o znaną wielkość; identyfikator błędny obniża je o nieznaną i dodatkowo psuje statystyki, na podstawie których ktoś potem ocenia całą integrację.
Od piksela do serwera: śledzenie, które wytrzyma
- Ewolucja analityki internetowej: Od plików logów po przyszłość Server-Side Tracking
- GA4 i Server-Side GTM: Wyjaśnienie funkcji „Migrate from JavaScript Managed Client ID” w GA4
- Server-Side GTM na GCP Cloud Run: Architektura, Auto-Scaling i optymalizacja kosztów
- GA4 Measurement Protocol: Serwerowa integracja konwersji offline z CRM
- Meta Conversions API: Maksymalizacja Event Match Quality (EMQ) i deduplikacja
Powiązane artykuły