English
 Deutsch
 Polski
Chunk-Größe und Überlappung in einer RAG-Wissensbasis: Auswirkungen auf Embedding-Zahl, Token-Budget und Neuindexierung

Management Summary
Ein KI-System mit Wissensbasis sucht vor einer Antwort passende Stellen in Unternehmensdokumenten. Dieses RAG genannte Verfahren bindet Antworten an vorhandene Informationen. Die Aufteilung der Dokumente ist wichtig: Ein Abschnitt braucht genug Zusammenhang, soll aber nicht zu viele nebensächliche Inhalte mitliefern. Etwas wiederholter Text zwischen Abschnitten kann die Bedeutung erhalten, erhöht jedoch Aufwand und Kosten. Eine passende Aufteilung unterstützt brauchbare Antworten und überschaubare Aktualisierungen.
Inhalt
- Exakte Zahlen für einen einfachen Zerleger
- Textwiederholung ist weder Vektorspeicher noch Rechnung
- Überlappung erhält Zusammenhang, besitzt aber kein allgemeines Optimum
- Platz für die gesamte Modelleingabe einplanen
- Geänderte Eingaben mit nachvollziehbaren Versionen neu indexieren
- Fragen und Antworten
- Quellen
Abschnittsgröße und Überlappung beeinflussen den auffindbaren Zusammenhang, die Zahl gespeicherter Einbettungen und die Textmenge für das antwortende Modell. Diese Einstellungen sind prüfbare Entscheidungen, keine allgemeingültigen Konstanten. Eine sinnvolle Wahl verbindet eine eindeutige Zählweise mit repräsentativen Fragen und bekannten Belegstellen.
Ein RAG-System sucht passende Quellenstellen und gibt diese als Grundlage für eine Antwort an ein Sprachmodell weiter. Ein Chunk ist ein Dokumentabschnitt. Überlappung bedeutet, dass benachbarte Abschnitte einen Teil desselben Textes wiederholen. Eine Einbettung bildet Text numerisch für die Ähnlichkeitssuche ab; ein RAG-System kann Vektorsuche zusätzlich mit Stichwortsuche verbinden. Token sind Einheiten des gewählten Tokenizers und keine festen Wortanteile. Sprache, Satzzeichen und Modell verändern die Anzahl.
Exakte Zahlen für einen einfachen Zerleger
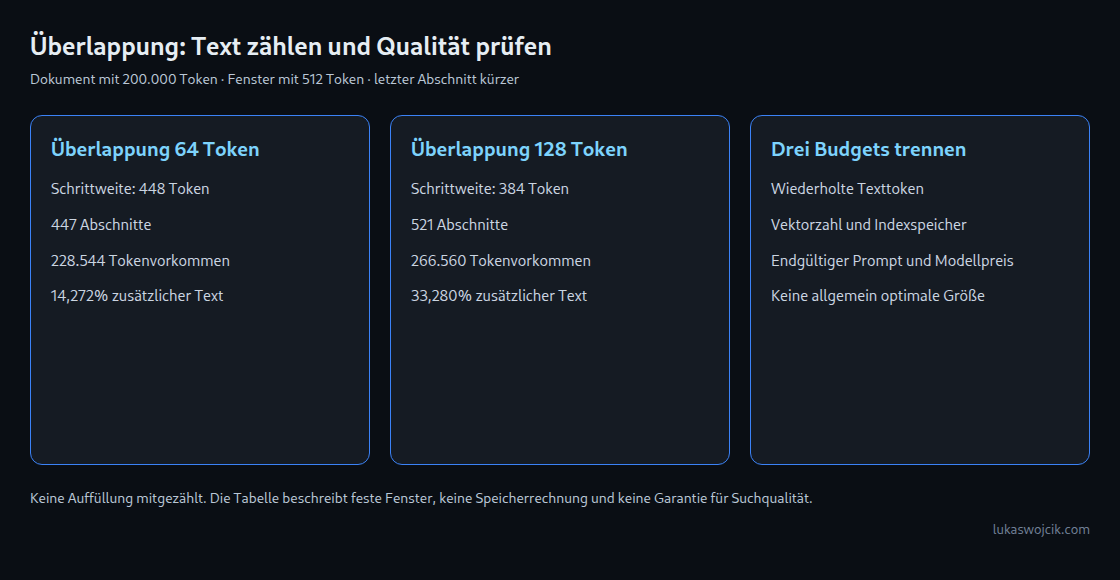
Das folgende Modell verwendet ein bereits tokenisiertes Dokument, feste Fenster und einen verkürzten letzten Abschnitt ohne Auffüllung. Sobald das letzte Token abgedeckt ist, endet die Zerlegung. N bezeichnet die Dokumentlänge, C die Abschnittsgröße und O die Überlappung mit 0 ≤ O < C. Die Schrittweite beträgt C − O. Ein leeres Dokument erzeugt keinen Abschnitt; bis einschließlich C Token entsteht ein Abschnitt.
Schrittweite = C - O
Abschnitte = 1 + ceil(max(0, N - C) / Schrittweite)   # für N > 0
Tokenvorkommen insgesamt = N + O * (Abschnitte - 1)
Die Funktion ceil rundet zur nächsten ganzen Zahl auf.
Für N = 200.000 und C = 512 ergibt sich:
| Überlappung | Schrittweite | Abschnitte | Tokenvorkommen | Zusätzlicher Text |
|---|---|---|---|---|
| 64 (12,5%) | 448 | 447 | 228.544 | 14,272% |
| 128 (25%) | 384 | 521 | 266.560 | 33,280% |
| 256 (50%) | 256 | 781 | 399.680 | 99,840% |
Abschnittszahl mal 512 würde eine nicht vorhandene Auffüllung des letzten Abschnitts mitzählen. Bei langen Dokumenten nähert sich die Vervielfachung C / (C − O); endliche Dokumente behalten Randeffekte. Bei 50 Prozent Überlappung werden innere Bereiche überwiegend wiederholt, aber nicht sämtliche Token exakt zweimal. Satzorientierte Schnitte, erneute Tokenisierung je Abschnitt und zusätzliche Überschriften können die Zahlen verändern.
Textwiederholung ist weder Vektorspeicher noch Rechnung
Die Tabelle zählt Texttoken einschließlich Wiederholungen. Bei einem Vektor fester Dimension je Abschnitt entstehen 447, 521 oder 781 Vektoren. Die Dimension bezeichnet die Anzahl der Zahlen eines Vektors. Der Speicherbedarf hängt von dieser Anzahl und dem Speicherformat jeder Zahl ab; Suchindex, abgelegter Text, Metadaten und Replikate benötigen zusätzlichen Speicher. Vierzehn Prozent mehr Text bedeuten nicht automatisch vierzehn Prozent mehr Gesamtspeicher oder Kosten.
Embedding-Dienste können nach Token, Zeichen oder anderen Einheiten abrechnen; selbst betriebene Modelle benötigen Rechenleistung. Wiederholter Import, Modellwechsel und Dokumentaktualisierungen erzeugen weiteren Aufwand. Anbieter, Modell, Zwischenspeicherung und Datenrepräsentation bestimmen die tatsächliche Rechnung. Einbettung ist weder zwangsläufig billig noch eine ausschließlich einmalige Arbeit.
Überlappung erhält Zusammenhang, besitzt aber kein allgemeines Optimum
Überlappung kann Beziehungen über Abschnittsgrenzen erhalten, etwa eine Definition mit anschließender Ausnahme. Eine Garantie für vollständige Sätze oder Antworten entsteht dadurch nicht. Lange Tabellen, Code, Verweise und Erklärungen über mehrere Absätze benötigen passende Behandlung. Zwei Sätze besitzen keine feste Tokenzahl.
Schnitte an Überschriften und Absätzen können den Zusammenhang verbessern; übergroße Abschnitte benötigen anschließend eine Größenbegrenzung. Ein Pfad wie Handbuch > Abrechnung > Kündigung kann fehlenden Kontext ergänzen. Der Zusatz belegt weiterhin Eingabe- und Promptraum, und der Nutzen benötigt eine Prüfung. Strukturorientiertes Zerlegen ist ein sinnvoller Ansatz, kein Beweis für grundsätzlich überflüssige Überlappung.
Ein überschaubarer Vergleich prüft mehrere Größen und Überlappungen mit denselben Fragen, Quellversionen und Abrufeinstellungen. Aussagekräftig sind gefundene notwendige Belegstellen, Antwortkorrektheit, belegte Quellenangaben, Latenz und Gesamtkosten. Kleine Abschnitte können Zusammenhang verlieren; große Abschnitte können ablenkende Themen enthalten. Auch 400 bis 800 Token sind von diesen Zielkonflikten nicht ausgenommen. Eine Einbettung wird gelernt und ist kein wörtlicher arithmetischer Mittelwert ihrer Themen.
Platz für die gesamte Modelleingabe einplanen
Acht vollständige Abschnitte mit jeweils 512 Token ergeben unter derselben Tokenizer-Annahme 4096 Token Quelltext. Anweisungen, Frage, Gesprächsverlauf, Überschriften und Quellenangaben kommen hinzu; die Antwort benötigt ein eigenes Ausgabebudget. Maßgeblich sind der tatsächliche Prompt-Tokenizer und die Modellabrechnung nach dem Zusammensetzen.
Halbe Abschnittsgröße und doppelte Trefferzahl erhalten lediglich diese nominelle Quelltextmenge. Bessere Treffer, gleiche Latenz oder eine identische Rechnung sind damit nicht garantiert. Suche, Frageeinbettung und Nachbewertung können gesonderte Kosten verursachen. Suchabschnitt und Generierungskontext müssen auch nicht identisch sein: Ein Parent-Document-Retriever kann kleine Fragmente suchen und einen größeren umgebenden Abschnitt zurückgeben.
Benachbarte Treffer können überlappenden Text wiederholen. Das Zusammenführen geprüfter Quellbereiche oder Entfernen exakter Dubletten kann Kontextraum sparen. Quellversion und Textpositionen müssen übereinstimmen, damit nur Passagen derselben Dokumentfassung zusammengeführt werden. Das automatische Verwerfen jedes schlechter bewerteten Nachbarn könnte allerdings gerade die einzige Ausnahme entfernen. Regeln für Vielfalt und Entdopplung benötigen deshalb dieselben Qualitätsprüfungen wie die Abschnittsgröße.
Geänderte Eingaben mit nachvollziehbaren Versionen neu indexieren
Eine andere Zerlegung verändert die Einbettungseingabe betroffener Abschnitte. Daraus folgt weder die Unmöglichkeit einer schrittweisen Umstellung noch die Pflicht, sämtliche Dokumente gleichzeitig zu verarbeiten. Exakt unveränderte Eingaben können kompatible Einbettungen wiederverwenden. Ein versionierter Index lässt sich vor dem Austausch der aktiven Fassung aufbauen und prüfen. Alte Verweise benötigen eine ausdrückliche Aufbewahrungs- oder Weiterleitungsregel.
Sinnvolle Angaben sind Quellkennung und Version, Positionen im Quelldokument, Zerlegerversion, vollständige Einbettungseingabe und Embedding-Konfiguration. Die Quellzuordnung kann als Metadatum oder Zuordnungstabelle vorliegen und muss nicht in der Abschnittskennung stecken. Eine Textprüfsumme allein reicht bei geänderter Modellversion, Dimension, Aufgabenart, Vorverarbeitung oder vorangestelltem Kontext nicht zur Wiederverwendung.
Rohdokumente, extrahierter Text, Abschnitte und Einbettungen sollten unterscheidbare Verarbeitungsschritte bleiben. Eine geänderte Abschnittsbildung erfordert zuerst erneutes Zerlegen, dann Einbetten geänderter Eingaben. Bei ausschließlich geändertem Embedding-Modell können vorbereitete Abschnitte weiterverwendet werden, sofern neue Grenzen und Eingabeanforderungen passen. Gelöschte Quellpassagen müssen auch aus dem aktiven Index verschwinden.
Fragen und Antworten
Bleiben bei strukturierten Schnitten alle übrigen Abschnitte unverändert?
Nicht unbedingt. Zusammenfassung von Teilabschnitten, Größenlimits und geänderte Überschriftenpfade können spätere Abschnitte beeinflussen. Bei festen Fenstern kann eine Einfügung viele spätere Grenzen verschieben; auch daraus folgt keine ausnahmslose Änderung jeder späteren Eingabe. Ein Vergleich vollständiger Eingaben ist verlässlicher als eine Stabilitätsannahme allein anhand des Zerlegernamens.
Was passiert bei einer zu langen Einbettungseingabe?
Modell und Endpunkt bestimmen Grenze und Verhalten. Googles dokumentierter Prediction-Endpunkt für gemini-embedding-001 unterstützt autoTruncate mit dem Standardwert true; false lässt zu lange Texte scheitern. Die Antwortstatistik enthält truncated und token_count. Das gilt nicht pauschal für sämtliche Embedding-APIs. Überschriften und andere eingebettete Zusätze zählen ebenfalls mit.
Ein abgeschnittener Schluss trägt nicht zu diesem Vektor bei; die Suchgrundlage für dessen Inhalt wird dadurch schwächer. Der Abschnitt kann trotzdem über den verbliebenen Anfang oder ein anderes Suchverfahren gefunden werden. Absolute Unauffindbarkeit folgt daraus nicht. Protokollierte Kürzungen und tatsächliche Modell-Tokenzahlen verhindern den falschen Eindruck, ein langer gespeicherter Abschnitt sei vollständig eingebettet worden.
Genügt die Aktualisierung eines einzelnen Dokuments?
Gewöhnlich lassen sich die betroffene Quelle und ihre abgeleiteten Datensätze unabhängig aktualisieren, sofern Quellzuordnung und Bereinigung umgesetzt sind. Unveränderte Eingaben können mit kompatibler Embedding-Konfiguration wiederverwendet werden. Eine zuverlässige Aktualisierung behandelt außerdem entfernte Abschnitte und verhindert die Vermischung inkompatibler Indexversionen beim Abruf.
Quellen
- Google: Texteinbettungen
- Microsoft: Dokumente in Abschnitte teilen
- Microsoft: Abschnittsbildung anhand der Dokumentstruktur
- Microsoft: Vergleich von Suchverfahren
- MongoDB: Suche mit Rückgabe umgebender Dokumentabschnitte
- LangChain: Indexierung
- Azure Samples: Textzerlegung
- Google: Überblick über Einbettungen
Passend dazu