English
 Deutsch
 Polski
Rozmiar chunków i nakładka w bazie wiedzy RAG: wpływ na liczbę embeddingów, budżet tokenów i ponowne indeksowanie

Management Summary
System AI z bazą wiedzy wyszukuje odpowiednie fragmenty dokumentów firmy przed przygotowaniem odpowiedzi. Podejście nazywane RAG pomaga oprzeć odpowiedź na istniejących informacjach. Podział dokumentów ma znaczenie: fragment potrzebuje kontekstu, ale nie powinien zawierać nadmiaru treści niezwiązanych z pytaniem. Powtórzenie części tekstu między fragmentami może zachować sens, lecz zwiększa pracę i koszty. Odpowiedni podział wspiera użyteczne odpowiedzi i sprawne aktualizowanie dokumentów.
Spis treści
Rozmiar fragmentów i nakładka wpływają na odnajdywany kontekst, liczbę przechowywanych osadzeń i ilość tekstu przekazywanego modelowi odpowiedzi. Są to ustawienia wymagające sprawdzenia, a nie uniwersalne stałe. Dobry wybór łączy jednoznaczną metodę liczenia z reprezentatywnymi pytaniami i znanymi fragmentami źródłowymi.
System RAG wyszukuje odpowiednie fragmenty źródeł i przekazuje je modelowi językowemu jako podstawę odpowiedzi. Chunk to fragment dokumentu. Nakładka oznacza, że sąsiednie fragmenty powtarzają część tego samego tekstu. Osadzenie jest reprezentacją liczbową używaną do wyszukiwania podobieństwa; system RAG może także łączyć wyszukiwanie wektorowe ze słowami kluczowymi. Tokeny są jednostkami wybranego tokenizera, a nie stałymi częściami słów. Język, interpunkcja i model zmieniają wynik liczenia.
Dokładne liczby dla prostego podziału
Poniższy model używa jednego już stokenizowanego dokumentu, stałych okien i skróconego ostatniego fragmentu bez dopełniania. Podział kończy się po objęciu ostatniego tokena. N oznacza długość dokumentu, C rozmiar fragmentu, a O nakładkę, przy 0 ≤ O < C. Krok wynosi C − O. Pusty dokument nie tworzy fragmentów; dokument nieprzekraczający C tokenów tworzy jeden.
krok = C - O
fragmenty = 1 + ceil(max(0, N - C) / krok)   # dla N > 0
łączna liczba wystąpień tokenów = N + O * (fragmenty - 1)
Funkcja ceil zaokrągla w górę do najbliższej liczby całkowitej.
Dla N = 200 000 i C = 512 wynik jest następujący:
| Nakładka | Krok | Fragmenty | Wystąpienia tokenów | Dodatkowy tekst |
|---|---|---|---|---|
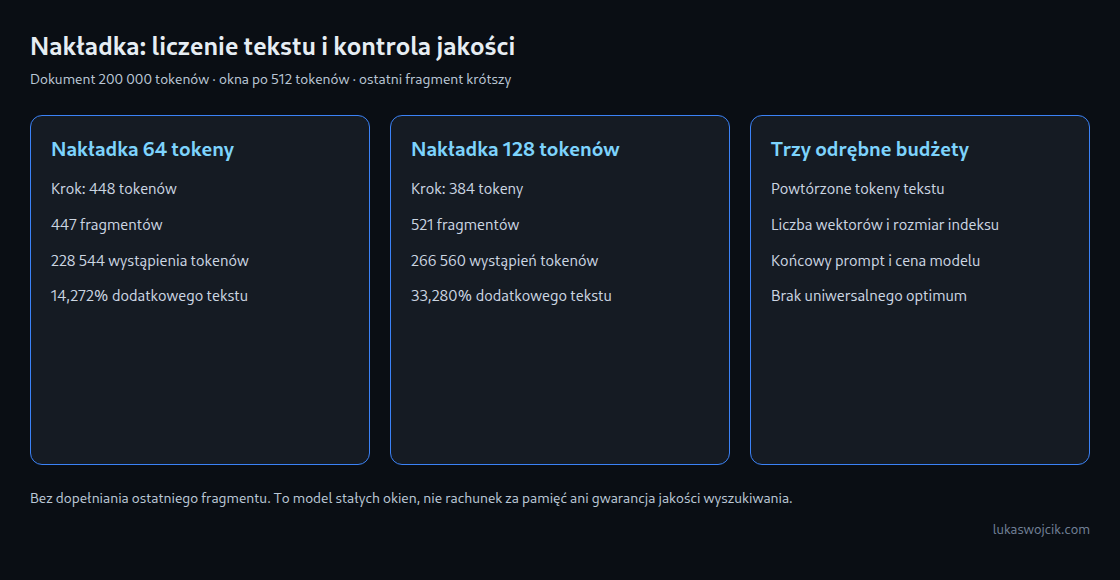
| 64 (12,5%) | 448 | 447 | 228 544 | 14,272% |
| 128 (25%) | 384 | 521 | 266 560 | 33,280% |
| 256 (50%) | 256 | 781 | 399 680 | 99,840% |
Mnożenie liczby fragmentów przez 512 doliczałoby nieistniejące dopełnienie ostatniego fragmentu. Dla długich dokumentów mnożnik zbliża się do C / (C − O); skończone dokumenty zachowują efekty brzegowe. Przy nakładce 50 procent wnętrze jest w dużej części powtarzane, ale nie każdy token występuje dokładnie dwukrotnie. Podział według zdań, ponowna tokenizacja fragmentów i dodatkowe nagłówki mogą zmienić te liczby.
Powtórzenia tekstu to nie rozmiar wektorów ani rachunek
Tabela liczy tokeny tekstu wraz z powtórzeniami. Przy jednym wektorze o stałym wymiarze na fragment powstaje 447, 521 lub 781 wektorów. Wymiar oznacza liczbę wartości w wektorze. Rozmiar w bajtach zależy od tej liczby i formatu zapisu każdej wartości; indeks wyszukiwania, tekst, metadane i repliki dodają osobny narzut. Czternaście procent więcej tekstu nie oznacza automatycznie czternastu procent więcej całej pamięci lub kosztów.
Usługi embeddingów mogą rozliczać tokeny, znaki albo inne jednostki; modele lokalne wymagają zasobów obliczeniowych. Ponowne importy, zmiany modeli i aktualizacje dokumentów także oznaczają pracę. Faktyczny rachunek zależy od dostawcy, modelu, buforowania i przechowywanej reprezentacji. Osadzanie zbioru nie musi być ani tanie, ani jednorazowe.
Nakładka zachowuje kontekst, ale nie ma uniwersalnego optimum
Nakładka może zachować związki ponad granicami, na przykład definicję z następującym po niej wyjątkiem. Nie gwarantuje jednak, że każde zdanie lub odpowiedź zmieści się w całości. Długie tabele, kod, odsyłacze i wyjaśnienia obejmujące wiele akapitów wymagają odpowiedniej obsługi. Dwa zdania nie mają stałej liczby tokenów.
Dzielenie na nagłówkach i akapitach może poprawić spójność; zbyt długie sekcje nadal potrzebują ograniczenia rozmiaru. Ścieżka taka jak Podręcznik > Rozliczenia > Wypowiedzenie może przywrócić brakujący kontekst. Dodatkowy tekst nadal zajmuje miejsce w wejściu i prompcie, a korzyść wymaga oceny. Podział według struktury jest sensowną strategią, nie dowodem zbędności każdej nakładki.
Niewielki eksperyment może porównać kilka rozmiarów i nakładek na tych samych pytaniach, wersjach źródeł i ustawieniach wyszukiwania. Przydatne miary obejmują odnalezienie wymaganych fragmentów, poprawność odpowiedzi, potwierdzenie cytowanych źródeł, opóźnienie i całkowity koszt. Małe fragmenty mogą tracić kontekst; duże mogą zawierać rozpraszające tematy. Zakres 400–800 tokenów również podlega tym kompromisom. Osadzenie jest wyuczoną reprezentacją, a nie dosłowną średnią arytmetyczną tematów.
Budżet całego złożonego promptu
Osiem pełnych fragmentów po 512 tokenów daje 4096 tokenów tekstu źródłowego przy tym samym tokenizerze. Instrukcje, pytanie, historia rozmowy, nagłówki i oznaczenia źródeł zwiększają tę liczbę; odpowiedź potrzebuje osobnego budżetu wyjścia. Po złożeniu promptu należy uwzględnić rzeczywisty tokenizer i zasady rozliczania modelu.
Zmniejszenie rozmiaru o połowę i podwojenie liczby trafień zachowuje tylko nominalną ilość tekstu źródłowego. Nie gwarantuje lepszego wyszukiwania, tego samego opóźnienia ani niezmienionego rachunku. Wyszukiwanie, osadzenie pytania i ponowne ocenianie trafień mogą mieć osobne koszty. Fragment wyszukiwany i kontekst generowania także nie muszą być identyczne: wyszukiwanie może odnajdywać małe fragmenty, a następnie zwracać większą otaczającą sekcję (parent-document retrieval).
Sąsiednie trafienia mogą powtarzać wspólny tekst. Łączenie sprawdzonych zakresów źródła lub usuwanie dokładnych duplikatów oszczędza miejsce na kontekst. Wersja źródła i pozycje w tekście muszą być zgodne, aby łączyć wyłącznie fragmenty tej samej wersji dokumentu. Automatyczne odrzucanie każdego niżej ocenionego sąsiada może jednak usunąć jedyny fragment z wyjątkiem. Reguły różnorodności i deduplikacji potrzebują takich samych kontroli jakości jak rozmiar fragmentu.
Ponowne indeksowanie zmienionych wejść z wersjonowaniem
Inny podział zmienia wejście osadzania dla objętych zmianą fragmentów. Nie wyklucza to migracji przyrostowej ani nie wymusza równoczesnego przetwarzania wszystkich dokumentów. Identyczne wejścia mogą ponownie wykorzystać zgodne osadzenia; wersjonowany indeks można zbudować i sprawdzić przed zastąpieniem aktywnego. Stare odwołania potrzebują jawnej polityki zachowania lub przekierowania.
Przydatne dane to identyfikator i wersja źródła, pozycje w dokumencie, wersja mechanizmu podziału, pełne wejście osadzenia oraz konfiguracja embeddingów. Powiązanie ze źródłem może być polem metadanych lub osobnym mapowaniem; nie musi być zakodowane w identyfikatorze fragmentu. Sama suma kontrolna tekstu nie wystarcza do ponownego użycia po zmianie wersji modelu, wymiaru, typu zadania, przetwarzania wstępnego lub dodanego kontekstu.
Dokumenty źródłowe, wyodrębniony tekst, fragmenty i osadzenia powinny pozostać rozróżnialnymi etapami. Zmiana podziału wymaga ponownego uruchomienia podziału przed osadzeniem zmienionych wejść. Zmiana wyłącznie modelu osadzeń może korzystać z przygotowanych fragmentów, jeśli nowe limity i wymagania wejścia na to pozwalają. Usunięte fragmenty źródła wymagają także usunięcia z aktywnego indeksu.
Pytania i odpowiedzi
Czy podział według struktury zachowuje wszystkie pozostałe fragmenty?
Niekoniecznie. Łączenie sekcji, limity rozmiaru i zmienione ścieżki nagłówków mogą wpływać na późniejsze fragmenty. Przy stałych oknach wstawienie tekstu może przesunąć wiele dalszych granic, lecz również nie oznacza bezwarunkowej zmiany każdego późniejszego wejścia. Porównanie rzeczywistych pełnych wejść jest pewniejsze niż założenie stabilności na podstawie nazwy mechanizmu.
Co dzieje się ze zbyt długim wejściem osadzenia?
Limit i zachowanie zależą od modelu oraz endpointu. Udokumentowany endpoint predykcji Google dla gemini-embedding-001 obsługuje autoTruncate z domyślną wartością true; false powoduje błąd dla zbyt długiego tekstu. Statystyki odpowiedzi zawierają truncated i token_count. Nie jest to ogólna reguła wszystkich API osadzeń. Nagłówki i inne osadzane dodatki również zwiększają wejście.
Odrzucona końcówka nie wpływa na ten wektor, osłabiając podstawę wyszukiwania jej treści. Fragment nadal może zostać odnaleziony przez zachowany początek lub inne wyszukiwanie; nie wynika z tego całkowita niemożność odnalezienia. Rejestrowanie skróceń i sprawdzanie rzeczywistej liczby tokenów modelu zapobiega mylnemu wrażeniu, że cały długi zapisany fragment został osadzony.
Czy wystarczy aktualizacja jednego dokumentu?
Zwykle objęte zmianą źródło i jego rekordy pochodne można aktualizować niezależnie, jeśli wdrożono śledzenie źródeł i usuwanie starych danych. Niezmienione wejścia mogą ponownie wykorzystać zgodną konfigurację osadzeń. Bezpieczna aktualizacja uwzględnia także usunięte fragmenty i zapobiega mieszaniu niezgodnych wersji indeksu podczas wyszukiwania.
Źródła
- Google: Osadzenia tekstu
- Microsoft: Dzielenie dokumentów na fragmenty
- Microsoft: Podział według struktury dokumentu
- Microsoft: Porównanie metod wyszukiwania
- MongoDB: Wyszukiwanie ze zwracaniem otaczających fragmentów dokumentu
- LangChain: indeksowanie
- Azure Samples: Dzielenie tekstu
- Google: Przegląd osadzeń
Powiązane artykuły